Kurzzusammenfassung: Die Preise für LLM-APIs variieren 2026 je nach Anbieter erheblich. Sie reichen vom günstigen DeepSeek mit $0,28 pro Million Token bis hin zu OpenAIs GPT-5.2 Pro mit $21 pro Million Input-Token. Durch das Verständnis tokenbasierter Preismodelle, versteckter Kosten wie Caching und Embeddings sowie von Optimierungsstrategien lassen sich die Ausgaben um 30–90 % senken, ohne die Leistung zu beeinträchtigen.
Der Markt für APIs großer Sprachmodelle ist explosionsartig gewachsen. Über 300 Modelle konkurrieren mittlerweile um die Aufmerksamkeit der Entwickler, jedes mit völlig unterschiedlichen Preisstrukturen.
Die Wahl des falschen Anbieters kann monatlich Tausende an Mehrkosten verursachen. Einige Quellen deuten darauf hin, dass Unternehmen für LLM-APIs zu viel bezahlen, schlicht weil sie Modellauswahl und Nutzungsmuster nicht optimiert haben; wie hoch der Aufschlag genau ist, hängt vom Anwendungsfall ab.
Dieser Vergleich schlüsselt die aktuelle Preisgestaltung der wichtigsten Anbieter auf, deckt versteckte Kosten auf, die Teams unvorbereitet treffen, und zeigt genau, wohin Ihr Geld fließt, wenn Sie eine LLM-API aufrufen.
LLM-API-Preismodelle verstehen
Die meisten LLM-APIs berechnen die Kosten pro Token. Aber was bedeutet das konkret für Ihr Budget?
Ein Token entspricht etwa vier Textzeichen. Das englische Wort „understanding“ besteht aus etwa drei Token. Ihre API-Aufrufe werden getrennt nach Input-Token (was Sie senden) und Output-Token (was das Modell generiert) abgerechnet.
Output-Token kosten typischerweise das 3- bis 6-Fache der Input-Token. Diese Asymmetrie ist relevant, wenn lange Antworten generiert werden.
Die drei wichtigsten Preismodelle
Die Anbieter strukturieren ihre Preisgestaltung anhand von drei Verbrauchsmodellen:
- On-Demand (Standard): Bezahlung pro Token ohne Verpflichtungen. Höchste Kosten pro Token, aber maximale Flexibilität. Gut geeignet für Prototypen oder schwer planbare Workloads.
- Batch-Verarbeitung: Sie reichen Anfragen ein, die asynchron innerhalb von 24 Stunden verarbeitet werden. Amazon Bedrock und OpenAI gewähren beide 50 % Rabatt auf Batch-Anfragen im Vergleich zu On-Demand-Preisen. Ideal für nicht dringende Aufgaben wie Datenanalyse oder Content-Erstellung.
- Provisioned Throughput: Sie reservieren dedizierte Kapazität mit garantierten Antwortzeiten. Abrechnung stündlich oder monatlich. Sinnvoll, wenn Sie konstant hohe Volumen verarbeiten und eine planbare Latenz benötigen.
OpenAI hat in seiner neuesten Preisstruktur zusätzliche Stufen eingeführt. Die Stufe „Flex“ bietet moderate Rabatte, während „Priority“ eine schnellere Bearbeitung während der Spitzenzeiten garantiert.
Aufschlüsselung der Preise der wichtigsten Anbieter
Lassen wir das Marketing beiseite und schauen wir uns die tatsächlichen Zahlen von den offiziellen Preisseiten an.
OpenAI API-Preise (2026)
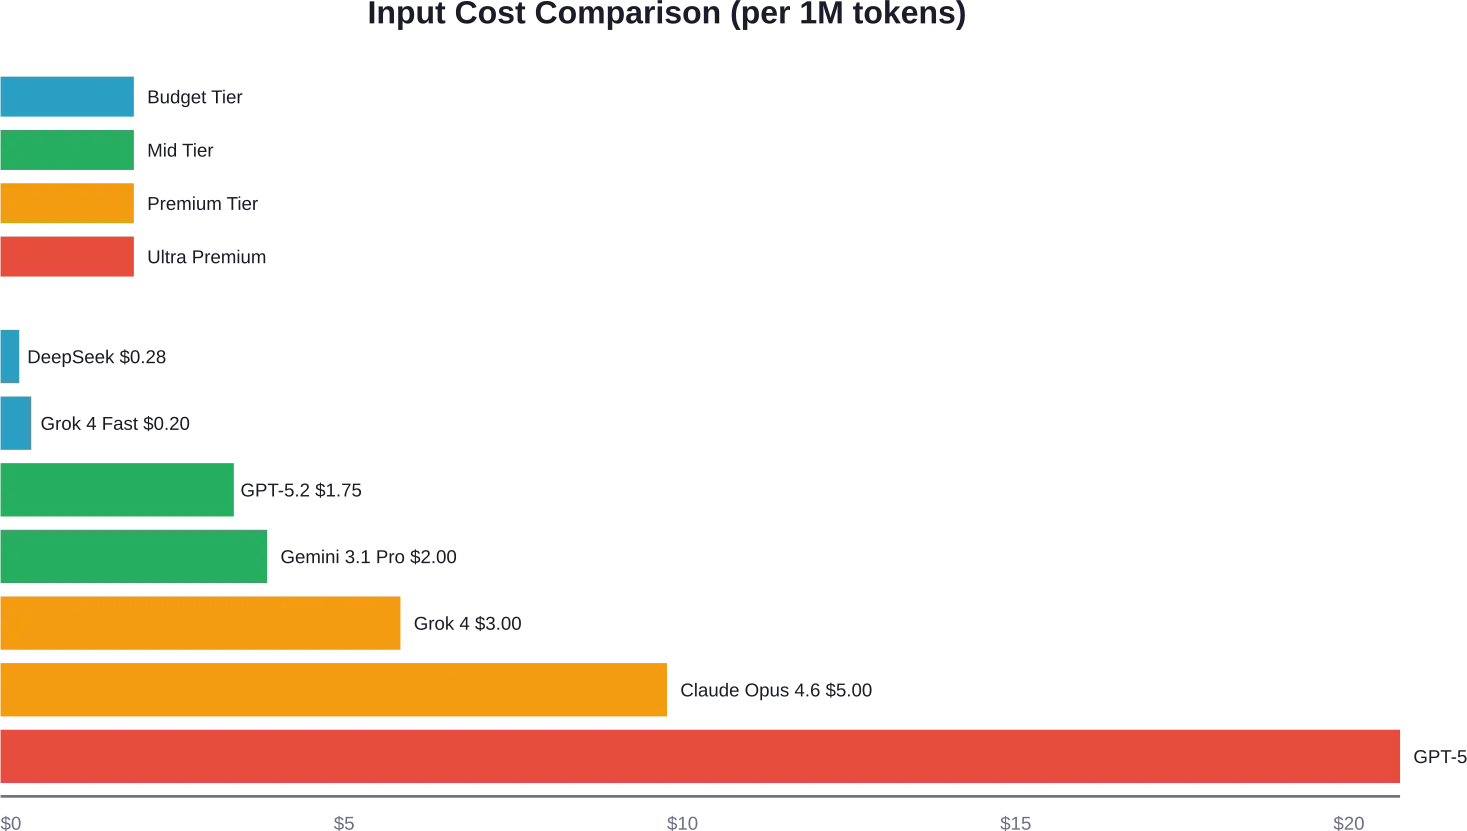
Das Produktangebot von OpenAI wurde deutlich erweitert. Laut der offiziellen Preisseite von OpenAI gelten folgende Preise pro Million Token:
| Modell | Input | Gecachter Input | Output |
|---|---|---|---|
| GPT-5.2 Pro | $21,00 | k. A. | $168,00 |
| GPT-5.2 | $1,75 | $0,175 | $14,00 |
| GPT-5 Mini | $0,25 | $0,025 | $2,00 |
| GPT-5 Nano | $0,025 | $0,0025 | $0,20 |
| GPT-4.1 | $1,00 | k. A. | $4,00 |
| GPT-4o | $1,25 | k. A. | $5,00 |
Das Flaggschiff GPT-5.2 ist für komplexes Reasoning und agentische Workflows konzipiert. GPT-5 Nano bietet den günstigsten Einstieg in das aktuelle OpenAI-Portfolio und eignet sich für einfache Klassifizierungs- oder Extraktionsaufgaben.
Die Batch-API von OpenAI halbiert diese Preise. Im Batch kostet GPT-5.2 $0,875 Input und $7,00 Output pro Million Token, also 50 % weniger als zum Standardpreis.
Preise von Anthropic Claude
Die Claude-Modelle von Anthropic folgen einem anderen Ansatz mit ausgeprägten Funktionen für Kontext-Caching. Aus der offiziellen Dokumentation:
| Modell | Basis-Input | Cache-Treffer | Output |
|---|---|---|---|
| Claude Opus 4.6 | $5,00 | $0,50 | $25,00 |
| Claude Opus 4.5 | $5,00 | $0,50 | $25,00 |
| Claude Opus 4.1 | $15,00 | $1,50 | $75,00 |
Das Caching-System von Claude gewährt 90 % Rabatt, wenn Sie Kontext wiederverwenden. Wenn Sie einen Chatbot entwickeln, der wiederholt auf dieselbe Wissensdatenbank zugreift, bedeuten Cache-Treffer von $0,50 pro Million Token im Vergleich zu $5,00 für neuen Input enorme Einsparungen.
Anthropic bietet außerdem Batch-Verarbeitung mit 50 % Rabatt auf die Standardtarife an und entspricht damit der Rabattstruktur von OpenAI.
Google Vertex AI (Gemini-Modelle)
Googles Plattform Vertex AI hostet neben der Gemini-Familie auch Modelle von Drittanbietern. Die Preise auf der offiziellen Vertex AI-Seite lauten wie folgt:
| Modell | Input ≤200K Token | Input >200K | Output |
|---|---|---|---|
| Gemini 3.1 Pro Preview | $2,00 | $4,00 | $12,00 |
| Gemini 3.1 Flash | Günstigere Preisstufe | Siehe offizielle Dokumentation | Siehe offizielle Dokumentation |
Google arbeitet mit Preisschwellen für lange Kontexte. Bei Anfragen mit mehr als 200.000 Token gilt der höhere Preis für alle Token dieser Anfrage. Gemini 2.5 Pro enthält täglich 10.000 kostenlose Grounded Prompts (mit Websuche) und berechnet danach $35 pro 1.000 weitere Grounded Prompts.
Enterprise Web Grounding kostet $45 pro 1.000 Grounded Prompts. Diese suchgestützten Funktionen summieren sich schnell, wenn die Nutzung nicht überwacht wird.
Amazon Bedrock als Multi-Modell-Plattform
AWS Bedrock aggregiert Modelle verschiedener Anbieter unter einheitlicher Abrechnung. Laut der Preisaktualisierung vom Februar 2026:
- Claude 3.5 Sonnet ab $3 Input / $15 Output pro Million Token
- Gemma 3 4B kostet $0,04 Input / $0,08 Output
- Gemma 3 12B kostet $0,09 Input / $0,18 Output
Bedrock bietet Batch-Inferenz mit 50 % Rabatt auf die On-Demand-Preise. Beim Provisioned Throughput wird pro Model-Unit-Stunde statt pro Token abgerechnet; für Laufzeiten von 1 oder 6 Monaten gibt es Rabatte.
Amazon bietet seine Nova-Modelle ebenfalls zu wettbewerbsfähigen Preisen an, wobei die genauen Preise je nach Region variieren.
Budget-Optionen: DeepSeek und xAI
Das chinesische Unternehmen DeepSeek hat den Markt mit aggressiven Preisen für seine V3.2-Exp-Modelle aufgemischt. Laut verfügbaren Preisdaten kosten die V3.2-Exp-Modelle von DeepSeek $0,60 pro Million Input-Token (Cache-Miss) und $0,40 für Reasoning-Output-Token.
xAI hat Grok 4 zu $3 Input / $15 Output pro Million Token auf den Markt gebracht. Die schnellere Variante Grok 4.1 Fast kostet $0,20 Input und $0,50 Output und richtet sich an Entwickler, denen Geschwindigkeit wichtiger ist als maximale Leistungsfähigkeit.
Versteckte Kosten, die Ihre Rechnung in die Höhe treiben
Die Token-Preise stehen im Rampenlicht. Doch diverse weniger offensichtliche Gebühren können Ihre tatsächlichen Ausgaben verdoppeln.
Prompt-Caching und Kontextfenster
Große Kontextfenster klingen verlockend, bis man merkt, dass man jedes Mal für jedes Token bezahlen muss. OpenAI und Anthropic bieten beide Prompt-Caching an, um die Kosten wiederholter Kontextnutzung zu reduzieren.
Laut OpenAI-Dokumentation sind gecachte Input-Token 90 % günstiger als Standard-Input. Bei GPT-5.2 betragen die Kosten zwischengespeicherter Token $0,175, während nicht zwischengespeicherte Token $1,75 kosten.
Der Haken? Schon das Schreiben in den Cache kostet Geld. Die Preisgestaltung von Anthropic zeigt, dass die Kosten für Cache-Schreibvorgänge je nach Dauer variieren: 5-minütige Cache-Schreibvorgänge kosten $6,25 pro Million Token und 1-stündige Schreibvorgänge $10 pro Million Token für Claude Opus 4.6.
Wenn der Kontext nicht häufig genug wiederverwendet wird, sind die Kosten für das Caching höher als die Einsparungen.
Embeddings und Vektorsuche
Der Aufbau eines RAG-Systems (Retrieval-Augmented Generation) erfordert das Erzeugen von Embeddings. Diese Kosten fallen separat von den Kosten für die Hauptinferenz an.
Amazon Titan Text Embeddings V2 kostet laut AWS-Dokumentation $0,00002 pro 1.000 Input-Token. Das klingt günstig, bis man Millionen von Dokumenten einbetten muss.
Zusätzlich fallen Kosten für die Vektorspeicherung an. Googles Vertex AI RAG Engine beinhaltet Gebühren für die Datenaufnahme, das LLM-Parsing für das Chunking und Vektorsuchen, die über die Kosten der Modellinferenz hinausgehen.
Grounding und Tool-Nutzung
Google berechnet bei Gemini nach Ausschöpfen des kostenlosen Tageskontingents $35 pro 1.000 Grounded Prompts (Websuche). Die Websuche mit Claude kostet laut offizieller Preisdokumentation von Anthropic für Vertex AI $10 pro 1.000 Suchanfragen.
Diese Funktionen verbessern die Genauigkeit bei Echtzeitinformationen erheblich. Bei großzügiger Nutzung erhöhen sie jedoch auch die üblichen Kosten um 10–15 %.
Rate Limits und Drosselung
Kostenlose und niedrige Nutzungsstufen unterliegen strengen Rate Limits. Im Tier-System von OpenAI erhalten Nutzer in Tier 1 bei GPT-5.2 500 Anfragen pro Minute und 500.000 Token pro Minute. Nutzer in Tier 5 kommen auf 40 Millionen Token pro Minute.
Das Erreichen von Rate Limits führt zu fehlgeschlagenen Anfragen und Wiederholungsversuchen, was sowohl Token als auch Entwicklerzeit verschwendet. Ein Upgrade auf einen höheren Tarif erfordert zwar einen Mindestbetrag pro Monat, beseitigt aber Engpässe.
Die richtige LLM-Architektur mit AI Superior
Die Wahl zwischen verschiedenen LLM-APIs hängt nicht nur von der Token-Preisgestaltung ab. Leistungsanforderungen, Prompt-Design, Systemarchitektur und Skalierungsstrategie beeinflussen die Gesamtkosten einer Anwendung.
AI Superior unterstützt Unternehmen bei der Entwicklung produktionsreifer LLM-Systeme und bei der Auswahl der am besten geeigneten Architektur für ihren Anwendungsfall.
Das Team unterstützt Sie bei:
- der Auswahl der richtigen LLM-Anbieter
- dem Entwurf skalierbarer LLM-Architekturen
- der Optimierung von Prompts und Token-Nutzung
- der Integration von LLMs in bestehende Systeme
Wenn Sie ein LLM-basiertes Produkt planen, kann AI Superior bei der Gestaltung der technischen Architektur und der Implementierung der Lösung helfen.
Kostenanalyse in der Praxis: Beispiel Chatbot
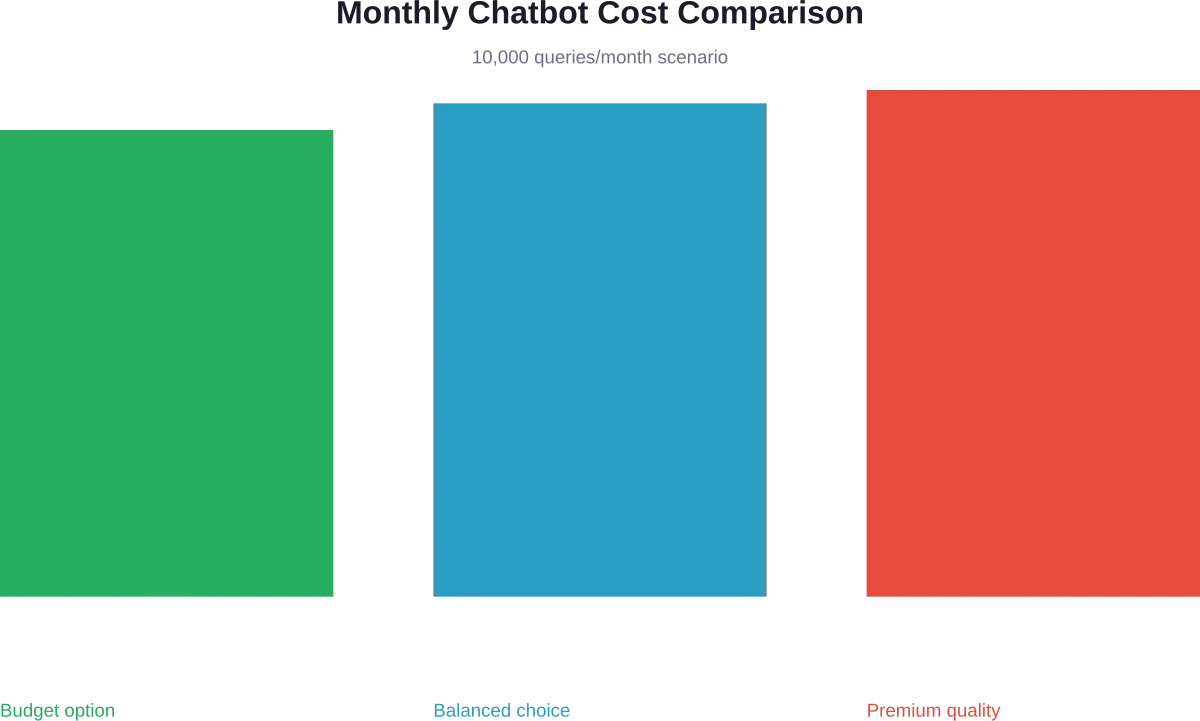
Lassen Sie uns die tatsächlichen Kosten für einen Kundenservice-Chatbot modellieren, der monatlich 10.000 Anfragen bearbeitet.
Annahmen basierend auf typischen Callcenter-Mustern aus der AWS-Dokumentation:
- 5 Millionen Token für die Wissensdatenbank (einmalig + Aktualisierungen)
- 50.000 Embeddings für die semantische Suche
- Durchschnittlich 100 Token pro Nutzeranfrage
- Durchschnittlich 100 Token pro Antwort
- Insgesamt: 2 Millionen Token monatlich (1 Million Input, 1 Million Output)
OpenAI GPT-4.1 Mini
- Input: 1 Mio. Token × $0,20 = $200
- Output: 1 Mio. Token × $0,80 = $800
- Embeddings: 50K × $0,00002 = $1
- Summe pro Monat: ~$1,001
Claude Opus 4.6 mit Caching
- Wissensdatenbank im Cache: 90 % Cache-Treffer
- Gecachter Input: 900K × $0,50 = $450
- Neuer Input: 100K × $5,00 = $500
- Output: 1M × $25,00 = $25,000
- Summe pro Monat: ~$25,950
Moment, das ist 26-mal teurer. Doch Claude Opus liefert bei komplexen Reasoning-Aufgaben eine deutlich höhere Qualität. Der höhere Preis ist für unternehmenskritische Anwendungen gerechtfertigt, bei denen Genauigkeit wichtiger ist als die Kosten.
DeepSeek V3.2 Budget-Option
- Input: 1M × $0,28 = $280
- Output: 1M × $0,40 = $400
- Embeddings: $1
- Summe pro Monat: ~$681
DeepSeek bietet die günstigste Option, weist jedoch eine weniger bewährte Zuverlässigkeit für Unternehmensanwendungen auf. Benchmarks zeigen, dass es in Standardtests höchstens 20 % hinter führenden kommerziellen Modellen liegt und sich somit für kostensensible Anwendungen eignet.
Kostenoptimierungsstrategien, die tatsächlich funktionieren
Teams, die ihre LLM-Kosten effektiv managen, folgen mehreren bewährten Mustern.
Intelligentes Prompt-Routing
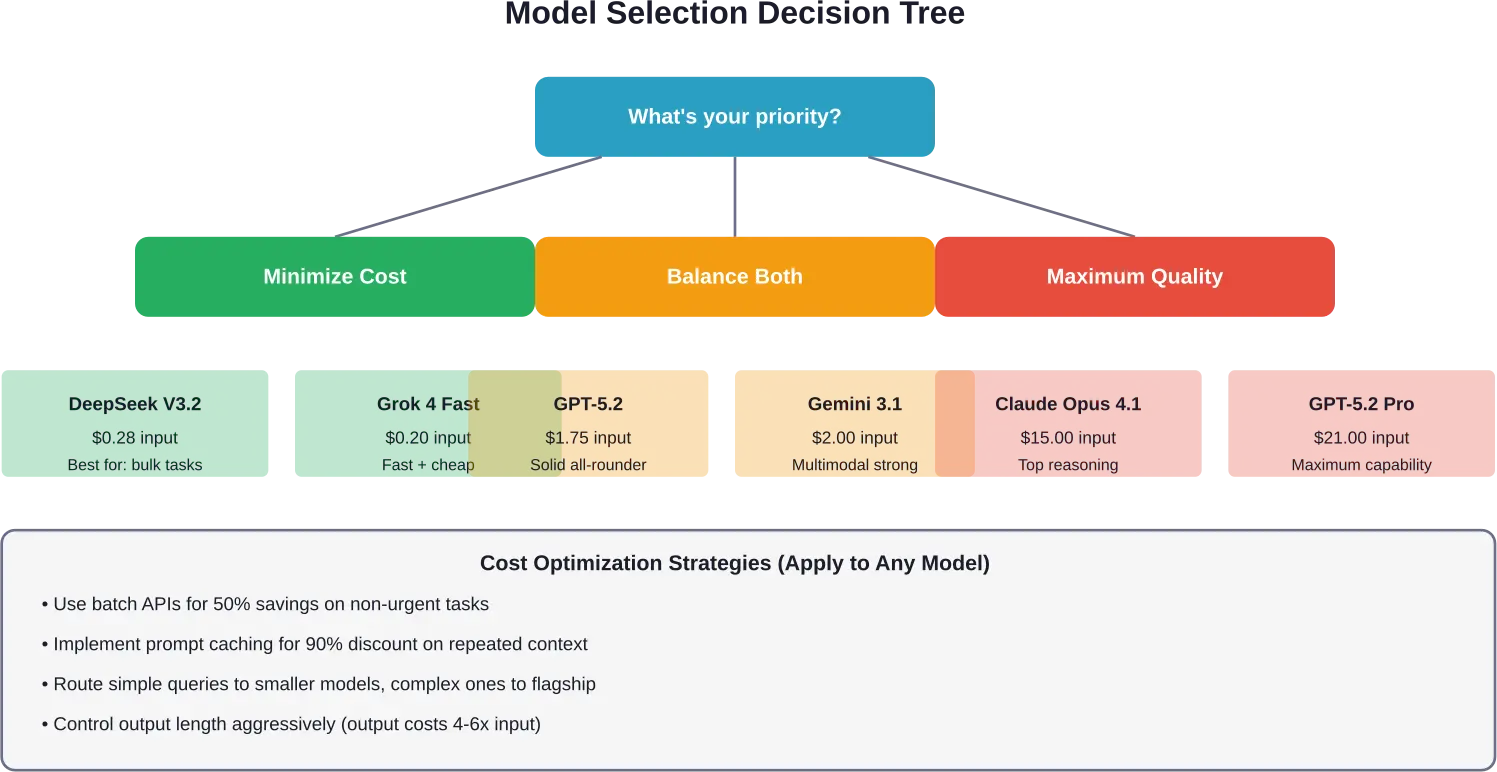
Nicht jede Anfrage erfordert Ihr leistungsstärkstes Modell. Leiten Sie einfache Fragen an kleinere Modelle weiter und komplexe Reasoning-Aufgaben an Flaggschiffmodelle.
Laut AWS-Dokumentation kann intelligentes Prompt-Routing die Kosten um bis zu 30 % senken, ohne die Genauigkeit zu beeinträchtigen. Implementieren Sie eine Klassifizierungslogik, die Anfragen anhand ihrer Komplexität den passenden Modellen zuordnet.
Amazon Bedrock unterstützt dies durch seine intelligente Prompt-Routing-Funktion, die automatisch die optimalen Modelle pro Anfrage auswählt.
Aggressives Prompt-Caching
Strukturieren Sie Ihre Prompts so, dass der Cache optimal genutzt wird. Platzieren Sie stabile Kontextinformationen (Systemanweisungen, Auszüge aus der Wissensdatenbank) am Anfang, wo sie zwischengespeichert werden können.
Das Caching-System von Anthropic senkt die Kosten für gecachte Token um bis zu 90 % gegenüber dem Standard-Input-Preis. Für Anwendungen, die auf einen konsistenten Kontext zugreifen, kann diese Optimierung die Ausgaben halbieren.
Batch-Verarbeitung für nicht dringende Aufgaben
Sowohl OpenAI als auch Amazon Bedrock gewähren 50 % Rabatt auf Batch-API-Anfragen. Alle Aufgaben, bei denen eine Bearbeitungszeit von 24 Stunden akzeptabel ist, sollten über Batch-Endpunkte laufen.
Inhaltsgenerierung, Datenanalyse und die Erstellung von Trainingsdaten lassen sich problemlos im Batch-Verfahren verarbeiten. Unternehmen können durch Batch-Verarbeitung erhebliche Kosteneinsparungen erzielen, die in der Regel 50 % günstiger ist als On-Demand.
Output-Token im Griff behalten
Output-Token kosten das 4- bis 6-Fache der Input-Token. Begrenzen Sie die Antwortlänge konsequent über den Parameter max_tokens und durch Prompt Engineering.
Wer 500-Token-Antworten anfordert, obwohl 200 Token genügen, verschwendet bei jedem Aufruf Geld. Setzen Sie konservative Output-Limits und erweitern Sie diese nur für Anfragen, die tatsächlich längere Antworten erfordern.
Modellauswahl nach Aufgabentyp
Stimmen Sie die Fähigkeiten des Modells auf die Anforderungen ab:
- Einfache Klassifizierung/Extraktion: Verwenden Sie Nano-/Mini-Modelle (GPT-5 Nano mit $0,025 Input, $0,20 Output)
- Allgemeine Chatbot-Antworten: Modelle der mittleren Preisklasse (GPT-4.1 Mini, Varianten von Claude Sonnet)
- Komplexes Reasoning/Programmierung: Flaggschiffmodelle (GPT-5.2, Claude Opus)
- Massenverarbeitung: Verwenden Sie stets Batch-APIs, und sparen Sie so 50 %
Ein Kosten-Nutzen-Framework legt nahe, dass sich ein On-Premise-Betrieb von LLMs je nach Nutzungsvolumen, Leistungsanforderungen und Infrastrukturkosten amortisieren kann. Für die meisten Teams bringt die Optimierung der Cloud-API-Nutzung jedoch einen besseren ROI als Self-Hosting.
Tools für Monitoring und Kostenmanagement
Was man nicht misst, kann man nicht optimieren. Verschiedene Ansätze helfen dabei, die LLM-Ausgaben im Blick zu behalten:
Anbietereigene Dashboards
OpenAI, Anthropic und Google bieten alle Nutzungs-Dashboards an, die den Token-Verbrauch nach Modell, Projekt und Zeitraum anzeigen. Diese funktionieren zwar, ermöglichen aber keinen anbieterübergreifenden Vergleich.
Die Usage & Cost API von Anthropic ermöglicht den programmatischen Zugriff auf Verbrauchsdaten mit einer Granularität von einer Minute bis zu einem Tag. Alle Kosten werden in US-Dollar als Dezimal-Strings in Cent ausgegeben.
Monitoring-Plattformen von Drittanbietern
Helicone und ähnliche Dienste aggregieren die Nutzung über mehrere LLM-Anbieter hinweg. Sie verfolgen die Kosten pro Anfrage, identifizieren teure Abfragen und warnen bei Überschreitung von Budgetgrenzen.
Diese Plattformen berechnen üblicherweise 1–2 % der LLM-Ausgaben oder eine monatliche Pauschale. Sie lohnen sich für Teams, die mehrere Anbieter nutzen oder eine detaillierte Zuordnung nach Benutzer/Projekt benötigen.
Budgetwarnungen einrichten
Die meisten Anbieter unterstützen Ausgabenlimits und Warnmeldungen. Richten Sie diese vor dem Produktivstart ein:
- Legen Sie feste Obergrenzen für Entwicklungs- und Testumgebungen fest.
- Konfigurieren Sie Warnungen bei 50 %, 75 % und 90 % des Budgets.
- Implementieren Sie Circuit Breaker, die Anfragen pausieren, wenn Grenzwerte erreicht werden.
AWS Cost Explorer ermöglicht die Budgetverfolgung für die Nutzung von Bedrock. Google Cloud bietet eine ähnliche Funktionalität für die Ausgaben von Vertex AI.
Neue Trends bei LLM-Preisen
Das Wettbewerbsumfeld entwickelt sich weiterhin rasant.
Preiskampf bei Standardaufgaben
Die Preise für einfache Textgenerierung und -klassifizierung sind seit 2023 um 80–90 % gesunken. Modelle wie GPT-5 Nano ($0,025 Input) und DeepSeek ($0,28 Input) treiben die Preise für einfache Aufgaben in Richtung Null.
Durch diese Kommodifizierung findet die Differenzierung eher bei spezialisierten Fähigkeiten statt – Reasoning, multimodales Verständnis, Tool-Nutzung – als bei der einfachen Textgenerierung.
Premiumpreise für Reasoning-Modelle
Bei fortgeschrittenem Reasoning gilt der umgekehrte Trend. GPT-5.2 Pro verlangt mit $21 Input / $168 Output deutliche Aufschläge gegenüber Standardmodellen.
Diese „Slow Thinking“-Modelle wenden vor der Antwort mehr Rechenzeit für das Reasoning auf, was höhere Preise für komplexe Probleme rechtfertigt, bei denen Genauigkeit wichtiger ist als Geschwindigkeit.
Wirtschaftlichkeit des Kontextfensters
Für Anfragen mit langem Kontext berechnen die Anbieter höhere Gebühren. Googles Schwelle von 200.000 Token führt bei Überschreitung zu höheren Preisen für alle Token in dieser Anfrage.
Mit der Erweiterung der Kontextfenster (OpenAIs GPT-5.2 unterstützt 400.000 Token) dürfte eine gestaffelte Preisgestaltung basierend auf der Kontextnutzung zum Standard werden. Effizientes Kontextmanagement durch Zusammenfassung und Caching wird an Bedeutung gewinnen.
Preisgestaltung für Spezialmodelle
Domänenspezifische Modelle (Medizin, Recht, Finanzen) erzielen aufgrund ihres spezialisierten Trainings Premiumpreise. Es ist mit einer weiteren Expansion von Nischenmodellen zu rechnen, deren Preise das Zwei- bis Dreifache vergleichbarer allgemeiner Modelle betragen werden.
Welchen Anbieter sollten Sie wählen?
Es gibt keine allgemeingültige Antwort, aber hier ist ein Entscheidungsrahmen basierend auf Prioritäten:
Für knappe Budgets
DeepSeek V3.2 bietet die niedrigsten Kosten pro Token bei gleichzeitig angemessener Qualität. Grok 4 Fast ist eine weitere kostengünstige Option mit besserer Supportinfrastruktur.
Kombinieren Sie Budgetmodelle für einfache Aufgaben mit dem strategischen Einsatz von Premiummodellen für kritische Anfragen. Leiten Sie 80 % des Traffics an günstige Modelle und 20 % an teure weiter.
Für maximale Qualität
OpenAIs GPT-5.2 Pro und Claude Opus 4.1 stellen derzeit die Qualitätsobergrenze dar. Rechnen Sie mit einem 10- bis 30-fach höheren Preis als bei Alternativen der Mittelklasse.
Das ist nur gerechtfertigt, wenn die Genauigkeit einen direkten Einfluss auf den Umsatz oder das Risiko hat (Rechtsanalysen, medizinische Anwendungen, kritische Infrastrukturen).
Für eine ausgewogene Leistung
GPT-5.2 ($1,75 Input) und Claude Opus 4.6 ($5,00 Input) treffen für die meisten Produktivanwendungen den Sweet Spot: hohe Leistung ohne extreme Kosten.
Googles Gemini 3.1 Pro mit $2,00 Input bietet wettbewerbsfähige Preise bei gleichzeitig hervorragenden multimodalen Fähigkeiten.
Für Google Cloud-Nutzer
Vertex AI bietet einheitlichen Zugriff auf Gemini sowie auf Drittanbietermodelle. Das integrierte Ökosystem vereinfacht die Bereitstellung, wenn Sie bereits eine GCP-Infrastruktur nutzen.
Nutzen Sie für suchgestützte Anwendungen die 10.000 kostenlosen Grounded Prompts pro Tag von Gemini 2.5 Pro.
Für AWS-Umgebungen
Bedrock bietet die größte Modellauswahl mit einheitlicher Abrechnung. Eine gute Wahl für Unternehmen, die AWS als Standard nutzen und über eine einzige Schnittstelle auf Anthropic, Meta und andere Anbieter zugreifen möchten.
Häufig gestellte Fragen
Welche LLM-API ist 2026 am günstigsten?
DeepSeek V3.2 bietet derzeit die niedrigsten Token-Preise mit ca. $0,28 pro Million Input-Token und $0,40 für Reasoning-Output. Grok 4 Fast von xAI kostet $0,20 Input / $0,50 Output. Für OpenAI-Nutzer kostet GPT-5 Nano $0,025 Input / $0,20 Output pro Million Token.
Wie viel kostet GPT-5 im Vergleich zu GPT-4?
Laut OpenAIs offizieller Preisgestaltung kostet GPT-5.2 $1,75 Input und $14,00 Output pro Million Token. Das ältere GPT-4 kostet dagegen $30,00 Input und $60,00 Output. GPT-5.2 ist deutlich günstiger (94 % weniger beim Input, 77 % weniger beim Output) und bietet gleichzeitig eine bessere Performance.
Sind Batch-APIs wirklich 50 % günstiger?
Ja. Sowohl OpenAI als auch Amazon Bedrock gewähren 50 % Rabatt auf Batch-Verarbeitung mit einer Bearbeitungszeit von 24 Stunden. Die Batch-Preise von OpenAI zeigen, dass GPT-5.2 im Vergleich zum Standard ($1,75 / $14,00) auf $0,875 Input / $7,00 Output sinkt. Für alle nicht dringenden Workloads sollten Batch-Endpunkte genutzt werden.
Was kostet Prompt-Caching?
OpenAI berechnet für gecachte Token 10 % des Standard-Input-Preises. Bei GPT-5.2 kostet gecachter Input $0,175 gegenüber $1,75 regulär. Anthropic gewährt 90 % Rabatt auf Cache-Treffer, berechnet jedoch Gebühren für Cache-Schreibvorgänge. Bei Claude Opus 4.6 kosten Cache-Schreibvorgänge je nach Dauer $6,25–$10,00 pro Million Token, während Cache-Treffer $0,50 gegenüber $5,00 Basis-Input kosten.
Wie berechne ich den Tokenverbrauch für meine Anwendung?
Verwenden Sie anbieterspezifische Tokenisierungstools. OpenAI bietet die tiktoken-Bibliothek an. Ein Token entspricht in der Regel etwa vier Zeichen oder 0,75 Wörtern. Ein Dokument mit 1.000 Wörtern enthält ungefähr 1.333 Token. Testen Sie Ihre tatsächlichen Prompts und Antworten mit Tokenisierungstools, um genaue Token-Zählungen zu erhalten, bevor Sie die Kosten schätzen.
Ist Claude teurer als GPT?
Das hängt von den verglichenen Modellen ab. Claude Opus 4.6 ($5,00 Input) ist teurer als GPT-5.2 ($1,75 Input), aber günstiger als GPT-5.2 Pro ($21,00 Input). Beim Output sind die Unterschiede größer: Claude Opus berechnet $25,00, GPT-5.2 nur $14,00. Die hohen Caching-Rabatte von Claude (90 %) können es bei Anwendungen mit viel wiederverwendetem Kontext jedoch günstiger machen.
Welches ist das kostengünstigste Modell für Chatbots?
Für allgemeine Kundenservice-Chatbots bieten GPT-4.1 Mini ($0,20 Input / $0,80 Output) oder GPT-5 Mini ($0,25 Input / $2,00 Output) das beste Verhältnis von Qualität und Kosten. Für einfachere FAQ-Bots eignet sich GPT-5 Nano ($0,025 Input / $0,20 Output) gut. Implementieren Sie intelligentes Routing, um Nano-/Mini-Modelle für einfache Anfragen zu verwenden und nur bei entsprechender Komplexität auf Flaggschiffmodelle zu wechseln.
Ihre Entscheidung für die LLM-API
Der Preis sollte nicht Ihr einziges Entscheidungskriterium sein. Modellqualität, Latenz, Kontextfenstergröße und das Integrationsökosystem spielen ebenfalls eine Rolle.
Das Verständnis von Kostenstrukturen hilft Ihnen jedoch, die häufige Falle zu vermeiden, für Funktionen zu viel auszugeben, die Sie nicht benötigen. Die meisten Anwendungen erhalten mit Mittelklassemodellen 90 % des Nutzens zu 20 % des Preises der Flaggschiffe.
Beginnen Sie mit diesen Schritten:
Erstellen Sie zunächst ein Profil Ihrer tatsächlichen Nutzungsmuster. Erfassen Sie die Anzahl der Token, die Länge der Antworten und die Komplexität der Abfragen für Ihren spezifischen Anwendungsfall. Reale Daten sind aussagekräftiger als Annahmen.
Zweitens sollten Sie mehrere Anbieter anhand Ihrer tatsächlichen Arbeitslast testen. Leistungsbenchmarks lassen sich nicht immer auf Ihre Domäne übertragen. Führen Sie A/B-Tests durch, um sowohl Qualität als auch Kosten zu messen.
Drittens: Implementieren Sie Kostenkontrollen vor der Skalierung. Richten Sie Budgetwarnungen ein, aktivieren Sie Caching und leiten Sie Anfragen intelligent weiter. Diese Optimierungen führen zu größeren Einsparungen als ein Anbieterwechsel.
Die LLM-Preislandschaft wird sich weiter verändern. Monatlich kommen neue Modelle auf den Markt, die Preise schwanken und die Leistungsfähigkeit verbessert sich kontinuierlich. Die grundlegenden Prinzipien bleiben jedoch unverändert.
Verstehen Sie die tokenbasierte Preisgestaltung. Überwachen Sie die tatsächliche Nutzung. Passen Sie die Modellfunktionen an die Aufgabenanforderungen an. Optimieren Sie die Cache-Wiederverwendung. Nutzen Sie nach Möglichkeit Batch-Verarbeitung.
Unternehmen, die Kostenoptimierungsmaßnahmen umsetzen, können durch eine optimierte Modellauswahl und Nutzungsmuster potenziell erhebliche Einsparungen erzielen – im Vergleich zu Unternehmen, die einfach einen Anbieter auswählen und APIs zum vollen Listenpreis nutzen. Das ist der entscheidende Unterschied zwischen einer nachhaltigen KI-Einführung und kostenintensiven Experimenten, die schnell wieder abgebrochen werden.
Bereit, Ihre LLM-Ausgaben zu optimieren? Beginnen Sie mit einer Überprüfung Ihres aktuellen Verbrauchs und der Implementierung eines intelligenten Prompt-Routings. Die Einsparungen summieren sich schnell.