Überblick: Die Kosten für das Hosting von LLMs hängen stark vom Bereitstellungsmodell ab: Sie reichen von 0,025 $ pro Million Tokens bei API-Diensten wie GPT-5-nano von OpenAI bis zu 1.500–5.000 $ pro Monat für selbst gehostete Infrastruktur. Organisationen mit mehr als 50.000 Anfragen pro Tag sparen durch Self-Hosting oft 25–50 % der Kosten, während kleinere Betriebe von der nutzungsbasierten API-Abrechnung profitieren. Der Hardwarebedarf wächst mit der Modellgröße: Modelle mit 7 Milliarden Parametern benötigen mit 4-Bit-Quantisierung etwa 3,5 GB VRAM, Modelle mit 70 Milliarden Parametern dagegen 35 GB oder ein Multi-GPU-System.
Die Ausgaben von Unternehmen für große Sprachmodelle sind regelrecht explodiert. Allein die Kosten für Modell-APIs haben sich 2025 auf 8,4 Milliarden US-Dollar verdoppelt, und die meisten Unternehmen planen, ihre KI-Budgets in diesem Jahr weiter zu erhöhen.
Doch nicht jede Organisation sollte auf dieselbe Weise bezahlen. Die Wirtschaftlichkeit des LLM-Hostings hängt ganz von Umfang, Nutzungsmustern und technischen Anforderungen ab. API-Dienste sind enorm bequem, doch bei ausreichendem Volumen lassen sich die Kosten durch Self-Hosting um 50 % oder mehr senken.
Dieser Leitfaden schlüsselt die tatsächlichen Kosten aller wichtigen Hosting-Optionen auf, von kommerziellen APIs bis zur vollständig selbst verwalteten Infrastruktur.
API-basierte LLM-Kosten: Abrechnung pro Token
Kommerzielle API-Dienste rechnen nutzungsbasiert ab, und zwar nach den verarbeiteten Input- und Output-Tokens. Laut der Preisdokumentation von OpenAI (Stand 2026) unterscheiden sich die Kosten je nach Modell erheblich.
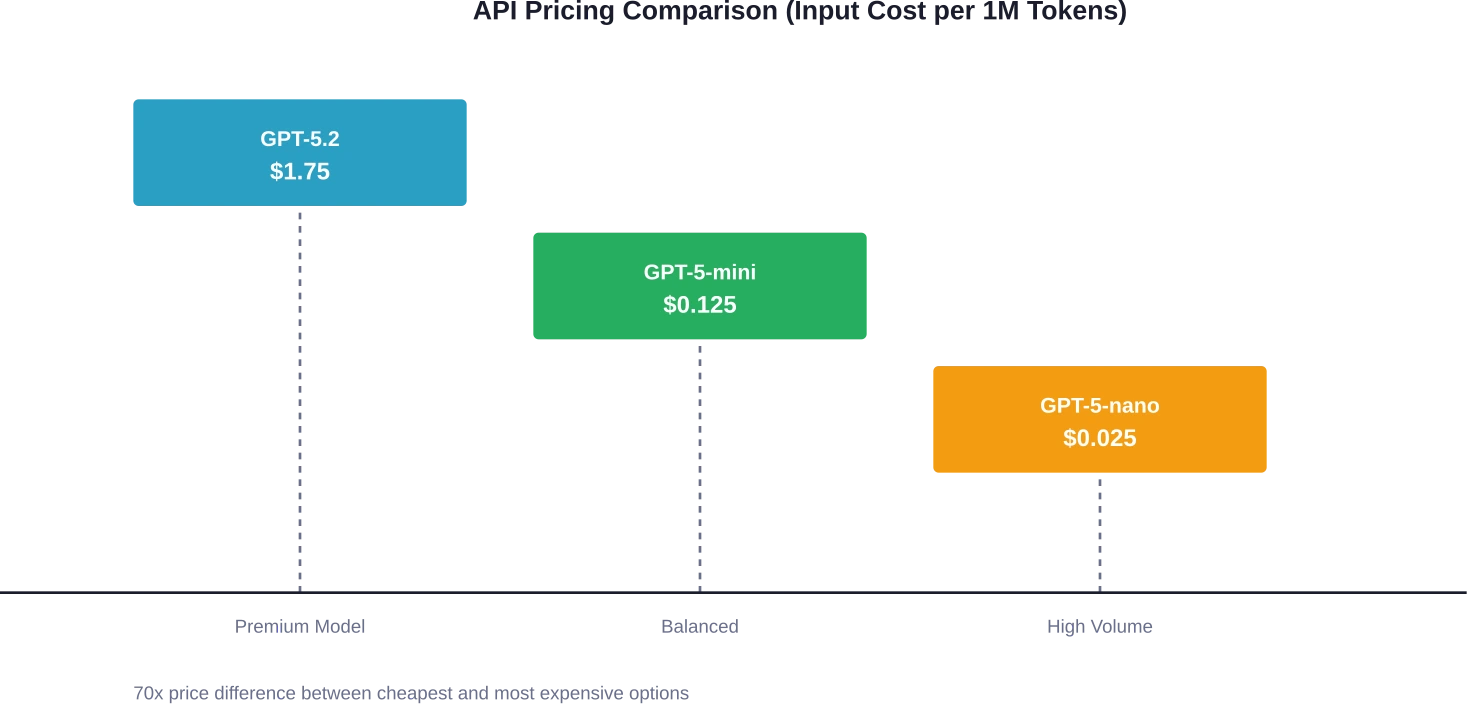
GPT-5.2 kostet 1,75 $ pro Million Input-Tokens und 14,00 $ pro Million Output-Tokens. Das ist das Flaggschiffmodell für komplexes Reasoning und Programmieraufgaben. Zum Vergleich: GPT-5-mini kostet nur 0,125 $ pro Million Input-Tokens und 1,00 $ pro Million Output-Tokens – also 14-mal weniger bei Input und Output.
Das neueste Modell, GPT-5-nano, senkt die Preise nochmals auf 0,025 $ pro Million Input-Tokens und 0,20 $ pro Million Output-Tokens. Für Teams mit vielen einfachen Aufgaben in hohem Volumen bedeutet das eine Kostensenkung um 80 % gegenüber GPT-5-mini.
Einsparungen durch zwischengespeicherte Inputs
OpenAI hat eine Preisstufe für zwischengespeicherte Inputs (Cached Inputs) eingeführt, bei der für wiederholte Inhalte nur 10 % des Standardpreises berechnet werden. Zwischengespeicherte Inputs kosten bei GPT-5.2 0,175 $ statt 1,75 $ pro Million Tokens. Für Anwendungen mit gleichbleibenden System-Prompts oder Referenzdokumenten ist diese Optimierung relevant.
Die Batch-API senkt die Kosten um 50 % für Workloads, die nicht in Echtzeit laufen müssen und asynchron innerhalb von 24 Stunden verarbeitet werden.
Preise von Anthropic und Google
Die Preise von Google Vertex AI für die Gemini-3-Modelle (Stand Februar 2026) folgen einer ähnlichen tokenbasierten Struktur. Für Anfragen mit weniger als 200.000 Input-Tokens gelten Standardpreise, für größere Kontexte und zwischengespeicherte Inputs gelten eigene Tarife.
Diese kommerziellen Dienste berechnen nur erfolgreiche Anfragen, die den Statuscode 200 zurückgeben. Fehlgeschlagene Anfragen kosten nichts, sodass Sie nicht für Fehler bezahlen.
Kosten für das Hosting auf Cloud-Plattformen
AWS SageMaker, Google Vertex AI und Azure Foundry bieten verwaltetes LLM-Hosting mit mehr Kontrolle als reine API-Dienste. Diese Plattformen berechnen Rechenressourcen statt Tokens.
Preisstruktur von AWS SageMaker
Laut der AWS-Dokumentation (Stand Februar 2026) berechnet SageMaker Instanzstunden, Speicher und Datenübertragung. Das AWS Free Tier umfasst in den ersten zwei Monaten 250 Stunden auf ml.t3.medium-Instanzen sowie 4.000 kostenlose API-Anfragen pro Monat.
Bei Produktions-Workloads steigt der Instanzpreis mit der GPU-Leistung. Organisationen, die Inferenz auf ml.g5.xlarge-Instanzen (NVIDIA-A10G-GPUs) ausführen, zahlen je nach Region und Laufzeitbindung unterschiedliche Preise.
Reservierte AWS-Instanzen bieten gegenüber On-Demand-Preisen deutliche Einsparungen. Einjährige Reservierungen können die Kosten bei planbaren Workloads erheblich senken.
Wirtschaftlichkeit von Google Vertex AI
Laut der Preisdokumentation von Google Vertex AI richten sich die Gebühren nach Rechenstunden, Bereitstellungsdauer des Modells und Vorhersageanfragen. Für Modelle, deren Bereitstellung fehlschlägt, fallen keine Gebühren an, und fehlgeschlagene Trainingsläufe (außer vom Nutzer selbst abgebrochene) werden nicht berechnet.
Dieses verbrauchsbasierte Modell verhindert, dass Sie für fehlgeschlagene Vorgänge bezahlen – ein Vorteil beim Experimentieren mit Modellkonfigurationen.
Kosten für selbst gehostete LLM-Infrastruktur
Beim Self-Hosting verlagern sich die Kosten von variablen Nutzungsgebühren hin zu festen Infrastrukturinvestitionen. Für Organisationen mit mehr als 50.000 Anfragen pro Tag ist das oft wirtschaftlich sinnvoll.
Der Hardwarebedarf hängt ganz von der Modellgröße ab. Als Faustregel gilt: etwa 0,5 GB VRAM pro Milliarde Parameter bei 4-Bit-Quantisierung. Volle Präzision (FP16) verdoppelt diesen Bedarf.
| Modellgröße | Parameter | VRAM (4-Bit) | VRAM (FP16) | Typische Hardware |
|---|---|---|---|---|
| Klein | 7B–13B | 3,5–6,5 GB | 14–26 GB | Eine A100/H100 |
| Mittel | 30B–40B | 15–20 GB | 60–80 GB | A100 80 GB |
| Groß | 70B+ | 35 GB+ | 140 GB+ | Multi-GPU-System |
Passt das Modell nicht in den VRAM, weicht das System auf die CPU aus, die 10- bis 100-mal langsamer ist. Für den Produktivbetrieb ist das keine Option.
Monatliche Infrastrukturkosten nach Stufe
Eine Studie der Carnegie Mellon University zur Wirtschaftlichkeit von On-Premise-LLM-Bereitstellungen zeigt klar abgegrenzte Kostenstufen:
| Stufe | Modellgröße | Hardwarekonfiguration | Monatliche Kosten | Geeignet für |
|---|---|---|---|---|
| Einstieg | 7B–13B | 1x A100/H100 | 1.500–5.000 $ | Prototypen, interne Tools |
| Mittel | 30B–70B | Cluster mit 4–8 GPUs | 8.000–20.000 $ | Produktivanwendungen, mittlerer Umfang |
| Enterprise | 70B+ | Cluster mit 8+ GPUs | 20.000–50.000+ $ | Produktivbetrieb mit hohem Volumen |
Diese Zahlen umfassen Hardwareabschreibung, Strom, Kühlung und grundlegende Wartung. Die auf arxiv.org veröffentlichte Kosten-Nutzen-Analyse gibt an, dass die GPU-Stundenkosten für A800-80G-Karten unter üblichen Annahmen bei etwa 0,79 $ pro Stunde liegen, in der Regel im Bereich von 0,51–0,99 $ pro Stunde.
Einsparungen durch reservierte AWS-EC2-Instanzen
Eine ausführliche Aufschlüsselung der LLM-Hosting-Kosten auf LinkedIn zeigt, dass reservierte AWS-EC2-Instanzen gegenüber On-Demand-Preisen deutliche Einsparungen bieten. Bei g5.xlarge-Instanzen (geeignet für Modelle mit 8 Milliarden Parametern) können einjährige Reservierungen die monatlichen Kosten von etwa 530 $ auf deutlich niedrigere Beträge senken.
Die günstigste ermittelte Option für 8B-Modelle war Deep Infra mit 5,40 $ pro Monat, die teuerste AWS SageMaker mit 529,92 $ pro Monat. Der Median liegt bei etwa 237 $ pro Monat.
Kennen Sie Ihre LLM-Hosting-Kosten
Beim Hosting von LLMs geht es um Entscheidungen zu Latenz, Skalierung, Sicherheit und Budget. AI Superior hilft Ihnen, das passende Hosting-Modell (Cloud, Edge oder hybrid) zu wählen, den Ressourcenbedarf abzuschätzen und die laufenden Kosten in Abhängigkeit von Traffic und Performance zu berechnen. Die Bewertung berücksichtigt Speicher, Monitoring, Skalierung und laufende Wartung. So erhalten Sie eine verlässliche Prognose Ihrer Hosting-Kosten.
Möchten Sie Ihr Budget für LLM-Hosting planen?
Sprechen Sie mit AI Superior, um:
- die richtige Hosting-Architektur auszuwählen
- Ressourcen- und Betriebskosten abzuschätzen
- eine klare Aufschlüsselung der Hosting-Kosten zu erhalten
👉 Fordern Sie bei AI Superior eine Schätzung Ihrer LLM-Hosting-Kosten an.
Die Gewinnschwelle: Wann sich Self-Hosting lohnt
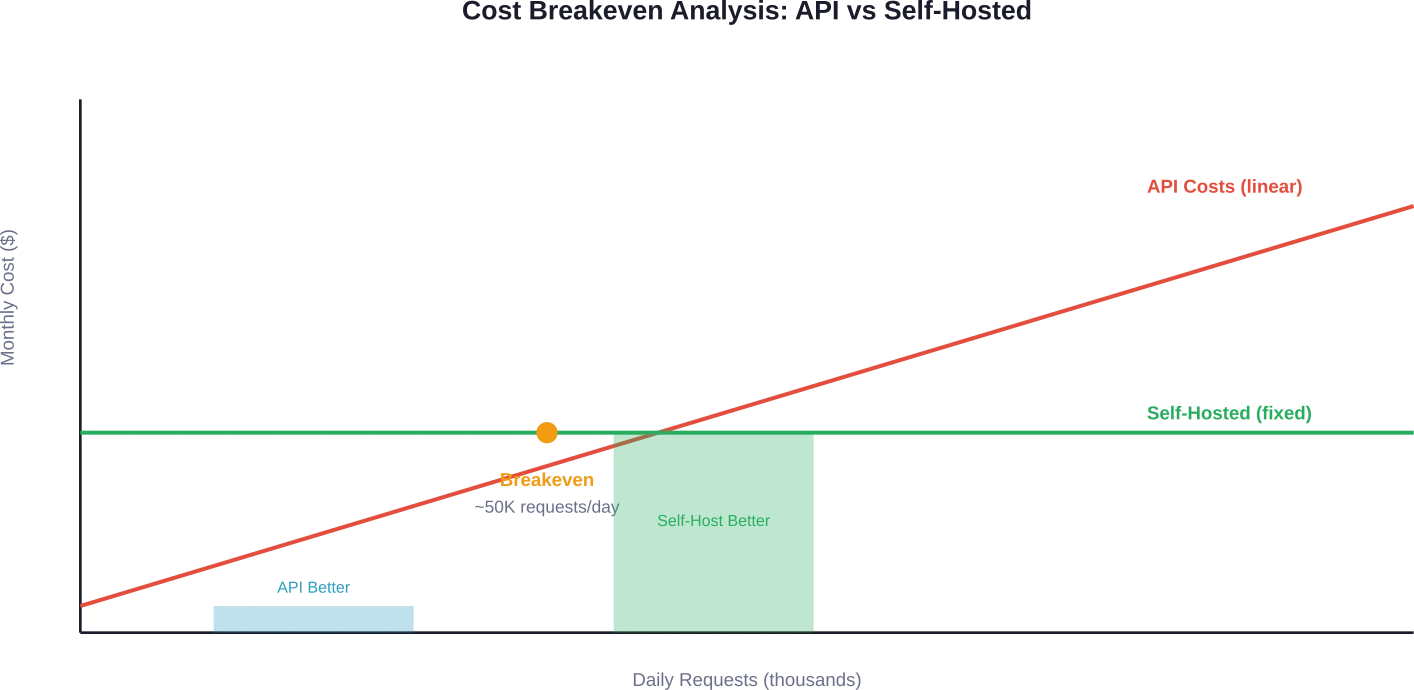
Der Break-even-Punkt hängt vom Anfragevolumen ab. Diskussionen in der Community und Kostenanalysen nennen übereinstimmend 50.000 Anfragen pro Tag als Schwelle, ab der Self-Hosting wirtschaftlich attraktiv wird.
Der Grund: API-Kosten wachsen linear mit der Nutzung. Feste Infrastrukturkosten bleiben dagegen unabhängig vom Anfragevolumen gleich (innerhalb der Kapazitätsgrenzen).
Eine Organisation, die täglich 50.000 Anfragen mit je 500 Input- und 500 Output-Tokens über GPT-5-mini verarbeitet, würde allein für API-Aufrufe etwa 3.125 $ pro Monat ausgeben. Anwendungsinfrastruktur, Caching-Schichten und Monitoring sind darin noch nicht enthalten.
Ein selbst gehostetes 7B-Modell auf Einstiegshardware (1.500–5.000 $ pro Monat) bewältigt ähnliche Volumen und bietet dabei vollständige Kontrolle über die Daten. Ab 100.000 Anfragen pro Tag verbessert sich die Wirtschaftlichkeit deutlich.
Versteckte Kosten, über die kaum jemand spricht
Der Listenpreis erzählt nur einen Teil der Geschichte. Sowohl API-basierte als auch selbst gehostete Ansätze bringen versteckte Kosten mit sich, die die Gesamtbetriebskosten beeinflussen.
Versteckte Kosten von API-Diensten
Rate Limits erzwingen Architekturentscheidungen. Stoßen Anwendungen an Durchsatzgrenzen, brauchen sie Warteschlangen, Retry-Logik und Fallback-Mechanismen. Das kostet Entwicklungszeit und Infrastruktur.
Bei Anwendungen mit hohem Volumen summieren sich Gebühren für ausgehenden Datenverkehr (Egress). Die Tokenverarbeitung selbst kostet einen bestimmten Betrag, doch für die Übertragung großer Datensätze zu und von API-Anbietern fallen zusätzliche Gebühren an.
Die Bindung an einen Anbieter (Vendor Lock-in) verursacht Wechselkosten. Anwendungen, die auf bestimmte API-Antwortformate, Tool-Integrationen oder Prompt-Engineering-Techniken zugeschnitten sind, lassen sich nicht ohne Weiteres zu einem anderen Anbieter migrieren.
Versteckte Kosten beim Self-Hosting
Der DevOps-Aufwand fällt ins Gewicht. Jemand muss sich um Modell-Updates, Sicherheitspatches, Monitoring und die Reaktion auf Vorfälle kümmern. Laut dem Enterprise AI Report 2025 von Kong nennen 44 % der Organisationen Datenschutz und Sicherheit als größte Hürden – Self-Hosting erfordert eigene Ressourcen, um diese Anforderungen angemessen zu erfüllen.
Strom und Kühlung übersteigen die reinen Rechenkosten. Rechenzentren berichten, dass der tatsächliche Stromverbrauch unter Berücksichtigung von Kühlung und Verlusten in der Stromversorgung beim 1,5- bis 2-Fachen der Nennleistungsaufnahme der GPU liegt.
Skalierung geschieht nicht automatisch. Zusätzliche Kapazität bedeutet Lieferzeiten für Hardware, Überlegungen zum Rack-Platz und Planung der Netzwerkinfrastruktur. API-Dienste skalieren dagegen sofort.
Optimierungsstrategien, die tatsächlich funktionieren
Unabhängig vom gewählten Hosting senken mehrere Techniken die LLM-Kosten zuverlässig, ohne die Leistung zu beeinträchtigen.
Modellauswahl und Quantisierung
Kleinere Modelle schneiden bei domänenspezifischen Aufgaben oft besser ab als erwartet. Laut einer Studie von Together AI kann ein auf spezialisierte Aufgaben feinabgestimmtes Open-Source-Modell mit 27 Milliarden Parametern Claude Sonnet 4 um 60 % übertreffen und dabei 10- bis 100-mal günstiger laufen.
4-Bit-Quantisierung halbiert den Speicherbedarf bei für die meisten Anwendungen minimalen Qualitätseinbußen. So lassen sich größere Modelle auf derselben Hardware oder dasselbe Modell auf günstigerer Hardware betreiben.
Batch-Verarbeitung
Die Batch-API von OpenAI spart durch asynchrone Verarbeitung innerhalb von 24 Stunden 50 % bei Input und Output. Die Dokumentation der Batch-API von Together AI zeigt ähnliche Einsparungen – Aufgaben, die keine Echtzeitantwort erfordern, sollten immer über Batch-Endpunkte laufen.
Untersuchungen von AWS zur Optimierung von SageMaker zeigen, dass das Bündeln von Inferenzanfragen die GPU-Auslastung drastisch verbessert und die Kosten pro Vorhersage senkt.
Caching und Deduplizierung von Anfragen
System-Prompts, Referenzdokumente und wiederholte Abfragen kosten unnötig Geld. Prompt-Caching auf Anwendungsebene vermeidet die redundante Verarbeitung von Tokens.
Bei selbst gehosteten Bereitstellungen kann eine Middleware zur Deduplizierung identische Anfragen abfangen, bevor sie das Modell erreichen, und stattdessen zwischengespeicherte Antworten ausliefern.
Traffic-Prognose und Auto-Scaling
Eine Microsoft-Studie zur Effizienz beim Betrieb von LLMs (SageServe) erzielte durch prognosebasiertes Auto-Scaling Einsparungen von bis zu 25 % der GPU-Stunden, mit potenziellen monatlichen Kosteneinsparungen von bis zu 2,5 Millionen $. Das System analysiert historische Anfragemuster und passt die Kapazität vorausschauend an.
Im Vergleich zu reaktiver Skalierung verringert sich die Verschwendung von GPU-Stunden durch ineffizientes Auto-Scaling so um bis zu 80 %.
Regionale Kostenunterschiede
Die Kosten für LLM-Hosting unterscheiden sich je nach Region erheblich. AWS, Google Cloud und Azure arbeiten mit regionalen Preisen, die lokale Infrastrukturkosten, Energiepreise und Marktbedingungen widerspiegeln.
Reale Produktionsdaten aus der Analyse von 10 Millionen Anfragen in mehreren Regionen belegen diese regionalen Kostenunterschiede. Bei API-Diensten bleiben diese Unterschiede für Sie meist unsichtbar. Bei selbst gehosteter Infrastruktur wirkt sich die Wahl der richtigen Region dagegen erheblich auf die monatlichen Kosten aus.
Kostentrends 2026
Mehrere Faktoren drücken die Kosten für LLM-Hosting in diesem Jahr.
Verbesserungen der algorithmischen Effizienz sind wichtiger als Fortschritte bei der Hardware. Laut einer Studie von MIT FutureTech zur algorithmischen Effizienz haben Verbesserungen der Speicherkomplexität bei großen Problemen (n = 1 Milliarde) in 20 % der untersuchten Fälle die Fortschritte bei DRAM übertroffen.
Neue Modellarchitekturen wie Mixture-of-Experts (MoE) haben andere Kostenprofile. Untersuchungen zur sogenannten MoE-Steuer zeigen, dass diese Modelle eigene Ineffizienzen aufweisen – ungleichmäßige Lastverteilung beim Prefill und mehr Speichertransfers beim Decoding. Optimierte MoE-Implementierungen können dennoch ein besseres Preis-Leistungs-Verhältnis bieten als dichte Modelle.
AWS stellte 2023 neue Large-Model-Inference-Container vor, die die Latenz bei Llama-2-70B-Workloads um 33 % senkten. Neuere Versionen verbessern die Effizienz weiter. Bei Llama 2 70B mit 16 gleichzeitigen Anfragen sank die Latenz mit TensorRT-LLM-Containern um 28 %, der Durchsatz stieg um 44 %.
Häufig gestellte Fragen
Wie hostet man ein LLM im Jahr 2026 am günstigsten?
Bei geringem Volumen (unter 10.000 Anfragen pro Tag) bietet GPT-5-nano von OpenAI mit 0,025 $ pro Million Input-Tokens den niedrigsten Einstieg ohne jeden Infrastrukturaufwand. Bei hohem Produktionsvolumen (mehr als 50.000 Anfragen pro Tag) ist das Self-Hosting von Modellen mit 7 bis 13 Milliarden Parametern auf Einstiegshardware (1.500–5.000 $ pro Monat) in der Regel günstiger als eine vergleichbare API-Nutzung.
Wie viel VRAM brauche ich für ein Modell mit 70 Milliarden Parametern?
Ein Modell mit 70 Milliarden Parametern benötigt mit 4-Bit-Quantisierung etwa 35 GB VRAM, mit voller FP16-Präzision 140 GB. Das bedeutet in der Regel entweder eine A100-GPU mit 80 GB (mit Quantisierung knapp ausreichend) oder ein Multi-GPU-System für einen komfortablen Betrieb. Ohne ausreichend VRAM weicht das Modell auf die CPU aus und läuft 10- bis 100-mal langsamer.
Lohnen sich reservierte AWS-Instanzen für das LLM-Hosting?
Reservierte Instanzen sind sinnvoll für planbare, dauerhafte Workloads, die rund um die Uhr laufen. Einjährige Reservierungen für AWS EC2 bieten bei GPU-Instanzen deutliche Einsparungen gegenüber On-Demand-Preisen. Allerdings binden Sie sich an die Kapazität – Organisationen mit schwankender Nutzung zahlen in Phasen geringer Nachfrage womöglich zu viel.
Können sich kleine Organisationen selbst gehostete LLMs leisten?
Self-Hosting im Einstiegssegment beginnt bei etwa 1.500–5.000 $ pro Monat für Modelle mit 7 bis 13 Milliarden Parametern. Organisationen mit mehr als 50.000 Anfragen pro Tag erreichen in dieser Größenordnung gegenüber den API-Kosten oft die Gewinnschwelle. Unterhalb dieser Schwelle sind API-Dienste meist günstiger, wenn man DevOps-Aufwand, Wartung und Verwaltung einrechnet.
Wie groß ist der tatsächliche Kostenunterschied zwischen GPT-5.2 und GPT-5-mini?
Laut den Preisen von OpenAI für 2026 kostet GPT-5.2 1,75 $ pro Million Input-Tokens und 14,00 $ pro Million Output-Tokens, GPT-5-mini dagegen 0,125 $ für Input und 1,00 $ für Output – ein Unterschied um das 14-Fache bei Input und Output. Für eine typische Anwendung, die täglich 1 Million Tokens verarbeitet (500.000 Input, 500.000 Output), kostet GPT-5.2 etwa 7.875 $ pro Monat, GPT-5-mini dagegen 562,50 $.
Spart Caching bei LLM-Kosten wirklich Geld?
Ja, und zwar erheblich. OpenAI berechnet für zwischengespeicherte Inputs bei wiederholten Inhalten nur 10 % des Standardpreises. Bei Anwendungen mit gleichbleibenden System-Prompts oder Referenzdokumenten kosten zwischengespeicherte Inputs von GPT-5.2 damit 0,175 $ statt 1,75 $ pro Million Tokens. Anwendungen, deren Inhalte zu 50 % zwischengespeichert werden können, senken ihre API-Kosten um rund 45 %.
Woran erkenne ich, wann ich von einer API auf Self-Hosting umsteigen sollte?
Berechnen Sie Ihre aktuellen monatlichen API-Kosten und das erwartete Wachstum. Vergleichen Sie diese mit einer Self-Hosting-Infrastruktur im Einstiegssegment (1.500–5.000 $ pro Monat) zuzüglich DevOps-Aufwand (typischerweise 0,25–0,5 Vollzeitstellen im Engineering). Liegen die API-Kosten über 5.000 $ pro Monat und ist die Nutzung planbar, ist Self-Hosting in der Regel wirtschaftlich sinnvoll. Neben den reinen Kosten spielen auch Datenschutz, Compliance und Anpassungsbedarf eine Rolle.
Fazit
Bei den Kosten für LLM-Hosting gibt es keine Einheitslösung. Die richtige Wahl hängt von Anfragevolumen, Leistungsanforderungen, Datensensibilität und technischen Fähigkeiten ab.
API-Dienste eignen sich hervorragend für einen schnellen Start, für schwankende Workloads und wenn Sie keine Infrastruktur verwalten möchten. Unter 50.000 Anfragen pro Tag sind sie fast immer günstiger.
Self-Hosting lohnt sich bei großem Volumen, besonders wenn Datenschutz wichtig ist oder domänenspezifisches Fine-Tuning bessere Ergebnisse liefert als allgemeine Modelle. Es erfordert jedoch DevOps-Kapazitäten und Vorabinvestitionen in die Infrastruktur.
Der beste Ansatz? Beginnen Sie mit APIs, um den Product-Market-Fit zu validieren, und prüfen Sie Self-Hosting, sobald sich die Nutzungsmuster stabilisiert haben und die Kosten die Investition in Infrastruktur rechtfertigen. Viele Organisationen setzen auf hybride Modelle: APIs für Experimente und Lastspitzen, selbst gehostete Infrastruktur für die zentralen Produktions-Workloads.
Welcher Weg auch immer für Ihre aktuellen Anforderungen passt: Bauen Sie flexibel. Die Wirtschaftlichkeit und die Möglichkeiten des LLM-Hostings entwickeln sich weiterhin rasant.