Korte samenvatting: Ideeën voor AI-projecten lopen van eenvoudige chatbots en beeldclassificatie tot aanbevelingssystemen, fraudedetectie en generatieve AI-toepassingen. De wereldwijde AI-markt was in 2024 $233,46 miljard waard en groeit naar verwachting tot $1.771,62 miljard in 2032, waardoor de vraag naar praktische AI-vaardigheden sterk toeneemt. Wie machine learning, deep learning en neurale netwerken echt wil beheersen, leert dat het best door zelf projecten te bouwen, van sentimentanalyse tot medische diagnosetools. Zo ontstaat meteen een portfolio dat laat zien dat u echte problemen kunt oplossen.
Tutorials lezen is niet meer genoeg. Recruiters en hiring managers willen zien wat u daadwerkelijk hebt gebouwd.
Of iemand een AI-functie krijgt, hangt vaak af van zijn portfolio. Theoretische kennis en certificaten alleen overtuigen minder dan werkende systemen die een concreet probleem oplossen.
Deze gids bespreekt meer dan 50 projectideeën op het gebied van kunstmatige intelligentie, ingedeeld naar moeilijkheidsgraad. Schrijft u uw eerste Python-script of bent u al transformermodellen aan het finetunen? In beide gevallen vindt u projecten die bij uw huidige niveau passen en u een stap verder brengen.
Waarom AI-projecten in 2026 belangrijker zijn dan ooit
Een analyse van de projectportefeuille van de National Institutes of Health laat zien dat AI-projecten een meetbare financieringspremie van 13,4% krijgen ten opzichte van projecten zonder AI. Dat geldt niet alleen voor de academische wereld: organisaties in alle sectoren waarderen aantoonbare AI-vaardigheden.
De wereldwijde AI-markt bereikte in 2024 een waarde van $233,46 miljard en zal naar verwachting in 2032 uitkomen op $1.771,62 miljard, een samengestelde jaarlijkse groei van 29,20%. Organisaties experimenteren niet meer alleen met AI; ze zetten het op grote schaal in.
Voor ontwikkelaars en studenten telt vooral dit: 79% van de AI-projecten zit nog in de onderzoeks- en ontwikkelingsfase, terwijl slechts 14,7% klinische inzet of implementatie bereikt. In die kloof liggen kansen. Bedrijven zoeken mensen die modellen van een notebook naar productie kunnen brengen.
Wie projecten bouwt, krijgt te maken met de rommelige praktijk van AI-ontwikkeling. Data komt nooit perfect opgeschoond binnen. Modellen convergeren niet bij de eerste poging. Productieomgevingen hebben beperkingen die een Jupyter-notebook niet kent.
Juist daarom werken projecten: u stuit op dezelfde problemen die u later in de praktijk moet oplossen.
AI-projectideeën testen met AI Superior
AI Superior ontwikkelt AI-software op maat, waaronder machine learning-modellen, AI-toepassingen, web- en mobiele apps en maatwerksoftware. Het team kan projecten begeleiden vanaf de verkenning en databeoordeling tot de ontwikkeling van een PoC of MVP, integratie en evaluatie van de resultaten.
Hulp nodig bij het bouwen van een AI-project?
AI Superior kan u helpen met:
- het beoordelen van ideeën voor AI-projecten
- het bouwen van AI- en ML-tools op maat
- het testen van concepten met een PoC of MVP
- het integreren van AI in bestaande systemen
Neem contact op met AI Superior om uw project te bespreken.
AI-projecten voor beginners: de basis leggen
Deze projecten introduceren de kernconcepten (supervised learning, classificatie, regressie, eenvoudige neurale netwerken) zonder dat de complexiteit u overweldigt.
1. Systeem voor spamdetectie in e-mail
Bouw een classifier die spam scheidt van legitieme e-mails met behulp van natural language processing. U werkt met tekstvoorbewerking, feature-extractie met TF-IDF of word embeddings en binaire classificatie met algoritmen als Naive Bayes of logistische regressie.
De dataset is vrij beschikbaar (het openbare SpamAssassin-corpus) en het probleem is goed afgebakend. U leert omgaan met onevenwichtige datasets, want spam is meestal de minderheidsklasse, en prestaties meten met precision, recall en F1-score in plaats van alleen accuracy.
2. Herkenning van handgeschreven cijfers
Train een neuraal netwerk dat cijfers uit de MNIST-dataset herkent. Dit klassieke project introduceert convolutionele neurale netwerken, beeldvoorbewerking en de basis van deep learning-frameworks zoals TensorFlow of PyTorch.
Het is een standaard beginnersproject, maar u leert er wezenlijke dingen: hoe convolutielagen features extraheren, hoe poolinglagen de dimensionaliteit verlagen en hoe u overfitting voorkomt met dropout en data-augmentatie.
3. Model voor het voorspellen van huizenprijzen
Voorspel vastgoedprijzen op basis van kenmerken als oppervlakte, locatie, aantal slaapkamers en bouwjaar. Dit regressieproject leert u feature engineering, het verwerken van categorische variabelen en het evalueren van modellen met metrics als mean absolute error en R-kwadraat.
Gebruik de Kaggle-dataset Housing Prices of verzamel lokale vastgoedgegevens. U leert uitschieters opsporen en verwerken, features normaliseren en meerdere algoritmen (lineaire regressie, decision trees, random forests) op hetzelfde probleem vergelijken.
4. Aanbevelingssysteem voor films
Bouw een systeem dat films voorstelt op basis van gebruikersvoorkeuren met collaborative filtering. Begin eenvoudig: raad films aan die vergelijkbare gebruikers goed vonden.
De MovieLens-dataset bevat beoordelingen van duizenden gebruikers. Het project introduceert matrixfactorisatie, similariteitsmaten (cosine similarity, Pearson-correlatie) en het cold-startprobleem: wat raadt u nieuwe gebruikers zonder geschiedenis aan?
5. Tool voor sentimentanalyse
Bouw een classifier die bepaalt of productrecensies, tweets of reacties een positief, negatief of neutraal sentiment hebben. Gebruik voor een snelle start een kant-en-klaar model als VADER en train daarna een eigen model op domeinspecifieke data.
U ziet het verschil tussen regelgebaseerde en machine learning-benaderingen, hoe context het sentiment verandert ("niet slecht" tegenover "niet goed") en hoe u sarcasme en ontkenning in tekst verwerkt.
6. Systeem voor weersvoorspelling
Voorspel temperatuur, neerslag of weersomstandigheden met historische gegevens. Dit tijdreeksproject introduceert seizoenspatronen, trendanalyse en afhankelijkheden in de tijd.
Begin met eenvoudige voortschrijdende gemiddelden en stap daarna over op ARIMA-modellen of recurrente neurale netwerken (RNN's). U leert omgaan met ontbrekende gegevens, lag-features maken en voorspellingen beoordelen met metrics die specifiek zijn voor tijdreeksen.
| Project | Belangrijkste techniek | Wat u leert | Gebruikelijke duur |
|---|---|---|---|
| Spamdetectie | Tekstclassificatie | Basis van NLP, onevenwichtige data | 1-2 weken |
| Cijferherkenning | CNN | Basis van deep learning | 1-2 weken |
| Huizenprijsvoorspelling | Regressie | Feature engineering | 1-2 weken |
| Filmaanbevelingen | Collaborative filtering | Similariteitsmaten | 2-3 weken |
| Sentimentanalyse | Tekstclassificatie | NLP, voorgetrainde modellen | 1-2 weken |
| Weersvoorspelling | Tijdreeksen | Patronen in de tijd | 2-3 weken |
AI-projecten op gemiddeld niveau
Zodra de basis zit, voegen projecten op gemiddeld niveau complexiteit toe: meerdere databronnen, geavanceerdere architecturen en aandacht voor deployment.
7. Detectie van creditcardfraude
Spoor frauduleuze transacties op in sterk onevenwichtige datasets, waarin fraude minder dan 1% van de gevallen uitmaakt. Daarvoor zijn technieken nodig als SMOTE tegen klassenonevenwicht, algoritmen voor anomaliedetectie en zorgvuldig afgestelde drempelwaarden om fout-positieven en fout-negatieven tegen elkaar af te wegen.
Gebruik de Kaggle-dataset Credit Card Fraud. U leert waarom accuracy bij onevenwichtige problemen misleidt en hoe precision-recall-curves de keuze van de drempelwaarde in productiesystemen sturen.
8. Chatbot met natural language understanding
Bouw een conversational agent die de intentie van de gebruiker begrijpt en passende antwoorden geeft. Begin met regelgebaseerde patronen en voeg daarna intentclassificatie en entity-extractie toe met bibliotheken als spaCy of Rasa.
Het project introduceert dialoogbeheer, het vasthouden van context over meerdere gespreksbeurten en het omgaan met dubbelzinnige vragen of vragen buiten het domein. Een koppeling met een kennisbank of API maakt dynamische antwoorden mogelijk.
9. Gezichtsherkenningssysteem
Detecteer en herken gezichten in afbeeldingen of videostreams. Gebruik voorgetrainde modellen als FaceNet of bouw een eigen model met CNN's en triplet loss om face embeddings te leren.
U leert transfer learning, one-shot en few-shot learning (personen herkennen op basis van weinig voorbeelden) en de beperkingen van realtime verwerking. Variaties in belichting, houding en beeldkwaliteit moet het systeem aankunnen.
10. Tool voor het voorspellen van aandelenkoersen
Voorspel aandelenkoersen of markttrends op basis van historische gegevens, technische indicatoren en eventueel externe signalen zoals het sentiment in nieuwsberichten. Het project laat de grenzen van AI net zo goed zien als de mogelijkheden, want markten zijn berucht lastig te voorspellen.
Haal data op via API's als Alpha Vantage of Yahoo Finance. Experimenteer met LSTM-netwerken voor sequentiemodellering en ontdek waarom backtesting op historische data geen garantie is voor toekomstige resultaten.
11. Assistent voor medische diagnose
Bouw een systeem dat ziekten of aandoeningen voorspelt op basis van symptomen, medische beelden of laboratoriumuitslagen. Gebruik bijvoorbeeld de Heart Disease-dataset of thoraxfoto's voor de detectie van longontsteking.
Hier komen ethische vragen bij kijken: medische AI moet vooral fout-negatieven zo veel mogelijk beperken. Ook de interpreteerbaarheid van het model telt, want zorgprofessionals moeten begrijpen waarom een model tot een bepaalde voorspelling komt.
12. Voorspelling van klantverloop
Spoor klanten op die waarschijnlijk hun abonnement opzeggen of met een dienst stoppen. Dit classificatieprobleem komt voor in telecom, SaaS, het bankwezen en andere sectoren, en raakt direct aan de bedrijfscijfers.
Feature engineering bepaalt hier veel: gebruikspatronen, het aantal supporttickets, betalingsgeschiedenis en engagementcijfers leveren allemaal signalen. U leert modelvoorspellingen omzetten in concrete maatregelen om klanten te behouden.
13. Content-based image retrieval
Bouw een systeem dat visueel vergelijkbare afbeeldingen in een database vindt. Gebruikers uploaden een afbeelding en het systeem geeft de meest gelijkende resultaten terug op basis van visuele kenmerken in plaats van teksttags.
Gebruik voorgetrainde CNN's als ResNet of VGG als feature-extractor en bereken de gelijkenis met de cosine distance in de embedding-ruimte. U maakt kennis met dimensiereductie via PCA en met snelle nearest-neighbor-zoekopdrachten via bibliotheken als FAISS.
Geavanceerde AI-projecten voor ervaren ontwikkelaars
Geavanceerde projecten hebben geen vastomlijnde oplossing, vragen om architectuurkeuzes en combineren vaak meerdere AI-technieken.
14. Autonoom navigatiesysteem
Ontwikkel een agent die met reinforcement learning door een omgeving navigeert. Begin met gesimuleerde omgevingen als OpenAI Gym en ga daarna naar complexere scenario's met obstakels, meerdere agents of continue actieruimtes.
Het project introduceert Q-learning, policy gradients en actor-critic-methoden. U weegt exploratie af tegen exploitatie en ontwerpt beloningsfuncties die het gewenste gedrag stimuleren zonder onbedoelde neveneffecten.
15. Neurale machinevertaling
Bouw een model dat tekst tussen talen vertaalt met sequence-to-sequence-architecturen en attention-mechanismen. Gebruik parallelle corpora uit bronnen als Europarl of de Tatoeba-dataset.
U leert encoder-decoderarchitecturen kennen, attention-mechanismen waarmee een model zich op de relevante inputtokens richt, en evaluatiemaatstaven als de BLEU-score. Met beperkte data levert het finetunen van voorgetrainde modellen als mBART of T5 meestal betere resultaten op.
16. Generatieve AI voor beeldende kunst
Maak originele afbeeldingen met generative adversarial networks (GAN's) of diffusiemodellen. Train op een specifiek domein, zoals portretten, landschappen of abstracte kunst, om nieuwe beelden in die stijl te genereren.
U krijgt te maken met adversarial training, waarbij een generator en een discriminator tegen elkaar strijden, met mode collapse, waarbij de generator te weinig variatie produceert, en met technieken als progressive growing voor beelden in hoge resolutie.
17. Realtime objectdetectie in video
Detecteer en volg meerdere objecten in videostreams met modellen als YOLO of Faster R-CNN. Optimaliseer voor realtime prestaties, dat wil zeggen 25 frames per seconde of meer, op consumentenhardware.
U weegt nauwkeurigheid af tegen snelheid, verwerkt overlappende objecten met non-maximum suppression en volgt objecten over meerdere frames. Voor deployment op edge-apparaten kunt u quantization en pruning van het model inzetten.
18. Question-answering-systeem
Bouw een systeem dat vragen beantwoordt door informatie uit documenten of kennisbanken te halen. Gebruik voorgetrainde transformers als BERT, gefinetuned op de datasets SQuAD of Natural Questions.
U werkt met modellen voor tekstbegrip, strategieën om de juiste passages te vinden in grote documentverzamelingen en hybride benaderingen die information retrieval combineren met deep learning.
19. Spraakassistent met wake-word-detectie
Bouw een spraakgestuurde assistent die op een wake word reageert, spraak transcribeert, opdrachten verwerkt en antwoord geeft. Combineer spraakherkenning (met modellen als Wav2Vec of Whisper), intentclassificatie en text-to-speech.
In dit end-to-endproject brengt u meerdere AI-componenten samen in één pipeline. U krijgt te maken met realtime audioverwerking, achtergrondgeluid en uiteenlopende accenten en spreekstijlen.
20. AI-assistent voor code review
Ontwikkel een tool die code met machine learning controleert op bugs, stijlfouten of beveiligingsproblemen. Train op datasets met codewijzigingen en bijbehorend commentaar van reviewers, of finetune een codemodel als CodeBERT.
Het project past NLP-technieken toe op een gestructureerd domein (programmeertalen), leert u werken met abstract syntax trees (AST) en laat zien hoe AI menselijke expertise aanvult in plaats van vervangt.
AI-projecten per domein
Wie zich specialiseert in een domein, zoals de zorg, de financiële sector of de retail, onderscheidt zijn portfolio en sluit beter aan bij zijn carrièredoelen.
AI-projecten in de zorg
Classificatie van medische beelden (tumoren opsporen op MRI-scans), voorspelling van geneesmiddelinteracties, voorspelling van heropnames en analyse van elektronische patiëntendossiers pakken allemaal echte problemen in de zorg aan.
Deze projecten vragen aandacht voor regelgeving, de privacy van patiënten (HIPAA-compliance) en de gevolgen van fouten. Volgens een analyse van de NIH gaat 50,1% van alle AI-financiering naar kanker, veroudering en geestelijke gezondheid, terwijl onderzoek naar gezondheidsverschillen met slechts 5,7% sterk ondervertegenwoordigd is. Dat is een ethisch probleem en tegelijk een kans.
Financiële AI-projecten
Algoritmische handelssystemen, voorspelling van wanbetaling op leningen, detectie van verzekeringsfraude en portefeuilleoptimalisatie maken de zakelijke waarde van AI zichtbaar. Financiële projecten hebben vaak duidelijke maatstaven voor succes, zoals rendement op investering, het percentage fout-positieven en de verwerkingstijd, en daar letten werkgevers op.
Ze hebben ook hun eigen problemen: markten reageren op u (andere algoritmen passen zich aan uw algoritme aan), regelgeving beperkt welke data u mag gebruiken en goede backtestresultaten garanderen geen goede resultaten in live handel.
Retail en e-commerce
Productaanbevelingen, dynamische prijsstelling, vraagvoorspelling, visueel zoeken en voorspelling van de customer lifetime value lossen problemen op waar retailers dagelijks mee te maken hebben.
Deze projecten werken met uiteenlopende datatypen (transactiegegevens, productcatalogi, logs van klantgedrag, afbeeldingen) en moeten schalen naar miljoenen gebruikers en producten.
Content en media
Automatische tagging van content, videosamenvattingen, deepfakedetectie, het opsporen van auteursrechtinbreuk en contentmoderatie spelen allemaal in op problemen in de digitale media.
In discussies in de community komen zowel technische problemen aan bod (adversarial examples, schalen naar miljoenen berichten) als ethische (bias in moderatiebeslissingen, transparantie bij automatische verwijderingen).
Projectideeën voor AI-agents en automatisering
Agentic AI, systemen die zelfstandig plannen, redeneren en handelen, is een belangrijke trend in 2026. NIST kondigde in februari 2026 het "AI Agent Standards Initiative" aan om interoperabiliteit en beveiliging te waarborgen nu deze systemen zich verspreiden.
21. Samenvatter van wetenschappelijke artikelen
Bouw een agent die artikelen van arXiv ophaalt, de belangrijkste bevindingen samenvat en ze per onderwerp ordent. Combineer PDF-parsing, extractieve en abstractieve samenvatting en topic modeling.
22. Geautomatiseerde sollicitatieassistent
Bouw een systeem dat vacaturesites scrapet, vacatures koppelt aan een cv en per vacature een motivatiebrief genereert. Het project combineert webscraping, NLP om vaardigheden te matchen met functiebeschrijvingen, en tekstgeneratie.
23. Analyse van financieel nieuws
Ontwikkel een agent die financieel nieuws volgt, vermeldingen van bedrijven en het bijbehorende sentiment extraheert en het nieuws naast koersbewegingen legt. Koppel API's van nieuwsbronnen, pas named entity recognition toe en analyseer trends in sentiment.
24. Planner voor socialemediacontent
Bouw een tool die berichten voor sociale media schrijft, de publicatietijden afstemt op engagementdata en de content automatisch publiceert. Combineer tekstgeneratie, tijdreeksanalyse van engagementpatronen en API-integratie.
25. Extractie van vergadernotities en actiepunten
Bouw een systeem dat vergaderingen transcribeert, de besprekingen samenvat en actiepunten met eigenaar en deadline eruit haalt. Gebruik spraakherkenning, samenvattingsmodellen en technieken voor informatie-extractie.
Projectideeën met de nieuwste AI-technieken voor 2026
Deze projecten werken met technieken en trends die nu opkomen in AI-ontwikkeling.
26. Multimodaal AI-systeem
Bouw een systeem dat content over meerdere modaliteiten heen begrijpt en genereert: tekst, beeld en audio. Denk aan een model dat een productfoto en een productbeschrijving krijgt en daar een reclamevideo met voice-over van maakt.
Multimodale modellen als CLIP, Flamingo en GPT-4V laten zien hoe verschillende datatypen elkaar kunnen aanvullen. U leert cross-modal attention, het op elkaar afstemmen van modaliteiten en het verwerken van input met sterk verschillende dimensies.
27. Federated learning-systeem
Implementeer een systeem waarin meerdere clients samen een model trainen zonder hun ruwe data te delen. Deze privacybeschermende aanpak is van belang in de zorg, de financiële sector en elk ander domein met gevoelige gegevens.
U leert gedistribueerde optimalisatie, het aggregeren van modelupdates en technieken voor non-IID-data (clients met verschillende dataverdelingen).
28. Few-shot learning-classifier
Bouw een model dat nieuwe categorieën leert uit slechts een paar voorbeelden. Dat is nodig wanneer gelabelde data schaars is. Gebruik meta-learningmethoden als MAML of prototypical networks.
U maakt kennis met learning to learn: modellen die worden geoptimaliseerd om zich snel aan te passen, niet om zo goed mogelijk te presteren op één vaste taak.
29. Dashboard voor explainable AI
Bouw een systeem dat voorspellingen doet en de redenering erachter toelicht met technieken als SHAP-waarden, LIME of visualisatie van attention. Pas het toe op een domein waar veel op het spel staat, zoals kredietaanvragen of medische diagnoses.
Volgens het standaardisatiewerk van IEEE zijn transparantie en uitlegbaarheid fundamenten van ethische AI. Organisaties vragen steeds vaker om interpreteerbare modellen, vooral in gereguleerde sectoren.
30. Prestatiemonitor voor AI-modellen
Ontwikkel een systeem dat de prestaties van modellen in productie volgt, data drift detecteert en een melding geeft wanneer opnieuw trainen nodig is. Dit MLOps-project maakt het verschil tussen ontwikkeling en deployment tastbaar.
Modellen gaan in de loop van de tijd achteruit doordat de dataverdeling verschuift. Monitoringsystemen volgen de zekerheid van voorspellingen, de verdeling van features en de werkelijke labels (als die beschikbaar zijn) om vast te stellen wanneer een model de werkelijkheid niet meer weerspiegelt.
Tools en technologieën voor AI-projecten
Met de juiste stack werkt u sneller en leert u de tools die in de sector gangbaar zijn.
Programmeertalen
Python domineert AI-ontwikkeling, en niet zonder reden: veel bibliotheken, een leesbare syntaxis en een grote community. R is geschikt voor statistische modellering en data-analyse. Julia wint terrein bij numeriek rekenwerk en toepassingen waar prestaties zwaar wegen.
De resultaten op benchmarks voor codegeneratie laten zien hoe snel het gaat. Volgens onderzoek naar de capaciteiten van modellen haalde de eerste versie van Codex 28,8% op HumanEval, terwijl GPT-5 (versie niet gespecificeerd) in 2025 op 93,5% uitkwam en het open-weights-model Kimi-K2 dat overtrof met 94,5%.
Machine learning-frameworks
Voor deep learning zijn TensorFlow en PyTorch de standaard. Scikit-learn is sterk in klassieke machine learning-algoritmen. JAX biedt snel numeriek rekenwerk met automatische differentiatie.
De keuze van het framework doet er minder toe dan u misschien denkt: werkgevers kijken meer naar probleemoplossend vermogen en ML-basiskennis dan naar ervaring met een specifieke bibliotheek. Wel heeft PyTorch de wind mee in onderzoek, terwijl TensorFlow sterke tools voor productie-deployment heeft.
Cloudplatforms en rekenkracht
Google Cloud, AWS en Azure bieden allemaal AI/ML-diensten aan: voorgetrainde modellen, beheerde trainingsinfrastructuur en deploymentplatforms. Google Colab geeft kosteloos toegang tot GPU's om te leren en prototypes te bouwen.
Voor kleine projecten volstaat lokale ontwikkeling. Grotere modellen en datasets vragen om cloudresources, en voor productie-deployment moet u cloudplatforms kennen.
Datatools en databases
Pandas is de standaard voor het bewerken van tabeldata en NumPy voor numerieke bewerkingen. Voor data op grote schaal maken Spark en Dask gedistribueerde verwerking mogelijk.
Vectordatabases als Pinecone, Weaviate en ChromaDB zijn onmisbaar geworden voor similarity search en retrieval-augmented generation (RAG).
Aanpak bij de ontwikkeling van AI-projecten
Of een project een werkend prototype wordt of een verlaten notebook, hangt vaak af van een paar vaste werkwijzen.
Begin met een duidelijke probleemstelling
Leg vast wat succes is voordat u code schrijft. Welk concreet probleem lost het project op? Welke metrics tellen? Wie zou het gebruiken?
Vage doelen als "iets bouwen met neurale netwerken" leiden tot projecten die stranden. Een specifiek doel als "klantenservicetickets met 85% nauwkeurigheid in vijf categorieën indelen" geeft richting.
Gebruik vanaf dag één versiebeheer
Git is niet alleen voor software engineers. Houd uw code, experimenten en modelversies bij. Gebruik branches voor experimenten en schrijf commitberichten die uitleggen wat er is veranderd en waarom.
Tools als DVC (Data Version Control) breiden Git uit voor grote datasets en modelbestanden.
Documenteer uw proces
Houd een projectlogboek bij met beslissingen, experimenten en resultaten. Toekomstige werkgevers willen uw denkproces begrijpen, niet alleen het uiteindelijke model zien.
Leg ook doodlopende wegen vast. Uitleggen waarom een aanpak niet werkte, toont net zoveel begrip als een geslaagde implementatie.
Let op de datakwaliteit
Een model leert alleen patronen die in de trainingsdata zitten. Garbage in, garbage out: dat geldt ongeacht hoe geavanceerd de architectuur is.
Neem de tijd voor verkennende data-analyse. Bekijk de verdelingen, spoor uitschieters op en controleer op leakage (testdata die per ongeluk de training beïnvloedt). Datawerk is niet spectaculair, maar het bepaalt het succes van een project meer dan de keuze van de modelarchitectuur.
Begin eenvoudig en bouw stap voor stap uit
Kies eerst de eenvoudigste aanpak die zou kunnen werken: logistische regressie vóór neurale netwerken, kleine modellen vóór grote. Leg een baseline vast en voeg alleen complexiteit toe als de resultaten daardoor beter worden.
Eenvoudige modellen trainen sneller, zijn makkelijker te debuggen en presteren vaak verrassend goed. Een complex model is pas zinvol als de eenvoudigere aanpak tekortschiet.
Denk vanaf het begin aan deployment
Hoe gaat iemand het resultaat echt gebruiken? Een notebook waarin u cellen handmatig moet uitvoeren, is niet in gebruik genomen. Een REST API, webinterface of command-line-tool maakt een project bruikbaar.
Deployment legt beperkingen bloot die tijdens de ontwikkeling onzichtbaar bleven: eisen aan latency, geheugenlimieten, conflicterende dependencies en foutafhandeling. Dat zijn geen bijzaken, ze horen bij AI in productie.
Ethische aspecten van AI-projecten
AI-governance is een omvangrijke markt geworden. Volgens onderzoek dat de IEEE Standards Association publiceerde, is de markt voor AI-governance meer dan $308 miljoen waard en groeit die naar schatting met 35,7% in de komende 5 jaar.
Organisaties wereldwijd zien ethische AI als voorwaarde voor vertrouwen, naleving van regelgeving en levensvatbaarheid op lange termijn.
Bias en eerlijkheid
Modellen nemen de vooroordelen over die in de trainingsdata zitten. Denk aan gezichtsherkenning die voor sommige bevolkingsgroepen beter werkt dan voor andere, wervingsalgoritmen die bepaalde achtergronden bevoordelen of kredietscores die historische ongelijkheid in stand houden.
Test de prestaties van het model per demografische groep. Gebruik fairness-metrics naast de totale nauwkeurigheid. Ga na of uw trainingsdata representatief is voor de populatie waarvoor het model bedoeld is.
Privacy en gegevensbescherming
Persoonsgegevens vragen om zorgvuldige omgang. De AVG in Europa, de CCPA in Californië en nieuwe regelgeving elders stellen strenge eisen.
Verzamel zo min mogelijk gegevens en gebruik alleen wat nodig is. Anonimiseer waar dat kan. Ken de bewaartermijnen. Voor projecten in de zorg is HIPAA-compliance verplicht.
Transparantie en uitlegbaarheid
Beslissingen met grote gevolgen, zoals het goedkeuren van leningen, medische diagnoses of strafrechtspraak, moeten uitlegbaar zijn. "Het algoritme zegt het" is niet genoeg wanneer het leven van mensen erdoor wordt geraakt.
In het werk van IEEE aan standaarden voor ethische AI zijn transparantie en uitlegbaarheid basisprincipes. Neem in projecten interpretatiemethoden op die voorspellingen voor belanghebbenden verklaren.
Beveiliging en robuustheid
De cybersecurityrichtlijnen van NIST voor AI-systemen, gepubliceerd in december 2025, behandelen nieuwe dreigingen zoals adversarial examples, model-inversion-aanvallen en data poisoning.
Neem beveiliging mee in de hele ontwikkeling. Valideer de input. Test de robuustheid tegen adversarial examples. Richt monitoring in om aanvallen of verslechtering van het model op te merken.
| Ethisch aandachtspunt | Gevolg voor het project | Maatregelen |
|---|---|---|
| Bias en eerlijkheid | Ongelijke prestaties tussen groepen | Diverse trainingsdata, fairness-metrics, biastests |
| Privacy | Onbevoegde blootstelling van gegevens | Dataminimalisatie, anonimisering, compliancecontroles |
| Transparantie | Onverklaarbare beslissingen | Interpretatietools, documentatie, audit trails |
| Beveiliging | Adversarial aanvallen, data poisoning | Inputvalidatie, robuustheidstests, monitoring |
| Milieu | Energieverbruik van training | Efficiënte architecturen, CO2-bewust rekenen |
Uw AI-portfolio opbouwen
Projecten laten zien wat u kunt, maar de presentatie telt even zwaar als de technische uitvoering.
Kies projecten bewust
Kwaliteit gaat voor kwantiteit. Drie goed uitgevoerde en goed gedocumenteerde projecten maken meer indruk dan tien half afgemaakte notebooks. Kies projecten die verschillende vaardigheden laten zien: een classificatieprobleem, een generatief model en een complete end-to-endtoepassing.
Stem projecten af op uw carrièredoelen. Mikt u op AI-functies in de zorg? Geef dan voorrang aan projecten met medische beeldvorming of klinische voorspellingen. Interesseert NLP u? Bouw dan conversationele systemen, tekstgeneratie of tools voor informatie-extractie.
Documenteer grondig
Elk project heeft duidelijke documentatie nodig: probleemstelling, aanpak, resultaten en lessen. Voeg visualisaties toe, zoals leercurves, confusion matrices en voorbeelduitvoer.
Schrijf voor iemand die het probleem niet kent. Leg uit waarom u voor een bepaalde architectuur hebt gekozen. Beschrijf wat niet werkte en wat u als volgende zou proberen. Daarmee laat u kritisch denkvermogen zien en niet alleen programmeervaardigheid.
Maak projecten toegankelijk
Zet de code op GitHub met uitgebreide README-bestanden: installatie-instructies, dependencies en gebruiksvoorbeelden. Lever bij modellen de voorgetrainde gewichten mee, zodat anderen kunnen testen zonder opnieuw te trainen.
Zet projecten waar mogelijk online. Een live demo, al is het een eenvoudige webinterface, laat inzet zien die verder gaat dan een cursusopdracht. Met diensten als Streamlit, Gradio of Hugging Face Spaces is deployment goed te doen.
Schrijf over uw werk
Blogposts, artikelen of technische verslagen vergroten het bereik van een project. Wie zijn werk aan anderen uitlegt, begrijpt het zelf beter en bouwt zichtbaarheid op.
In discussies in de community komt steeds terug dat kandidaten die hun leerproces documenteren en delen, bij sollicitaties opvallen.
Veelgemaakte fouten
Leren van de fouten van anderen bespaart tijd.
Vastzitten in tutorials
Tutorials volgen voelt productief, maar levert weinig vaardigheid op. Het leren zit in het worstelen: fouten debuggen, ontwerpkeuzes maken, onverwachte problemen oplossen.
Gebruik tutorials voor de basis en pas de concepten daarna meteen toe in eigen projecten. Pas de code uit tutorials aan. Combineer technieken uit verschillende bronnen. Maak dingen kapot en repareer ze.
Eerste projecten te complex maken
Ambitie is prima, maar wie als eerste project een systeem op onderzoeksniveau wil bouwen, raakt vaak gefrustreerd en haakt af.
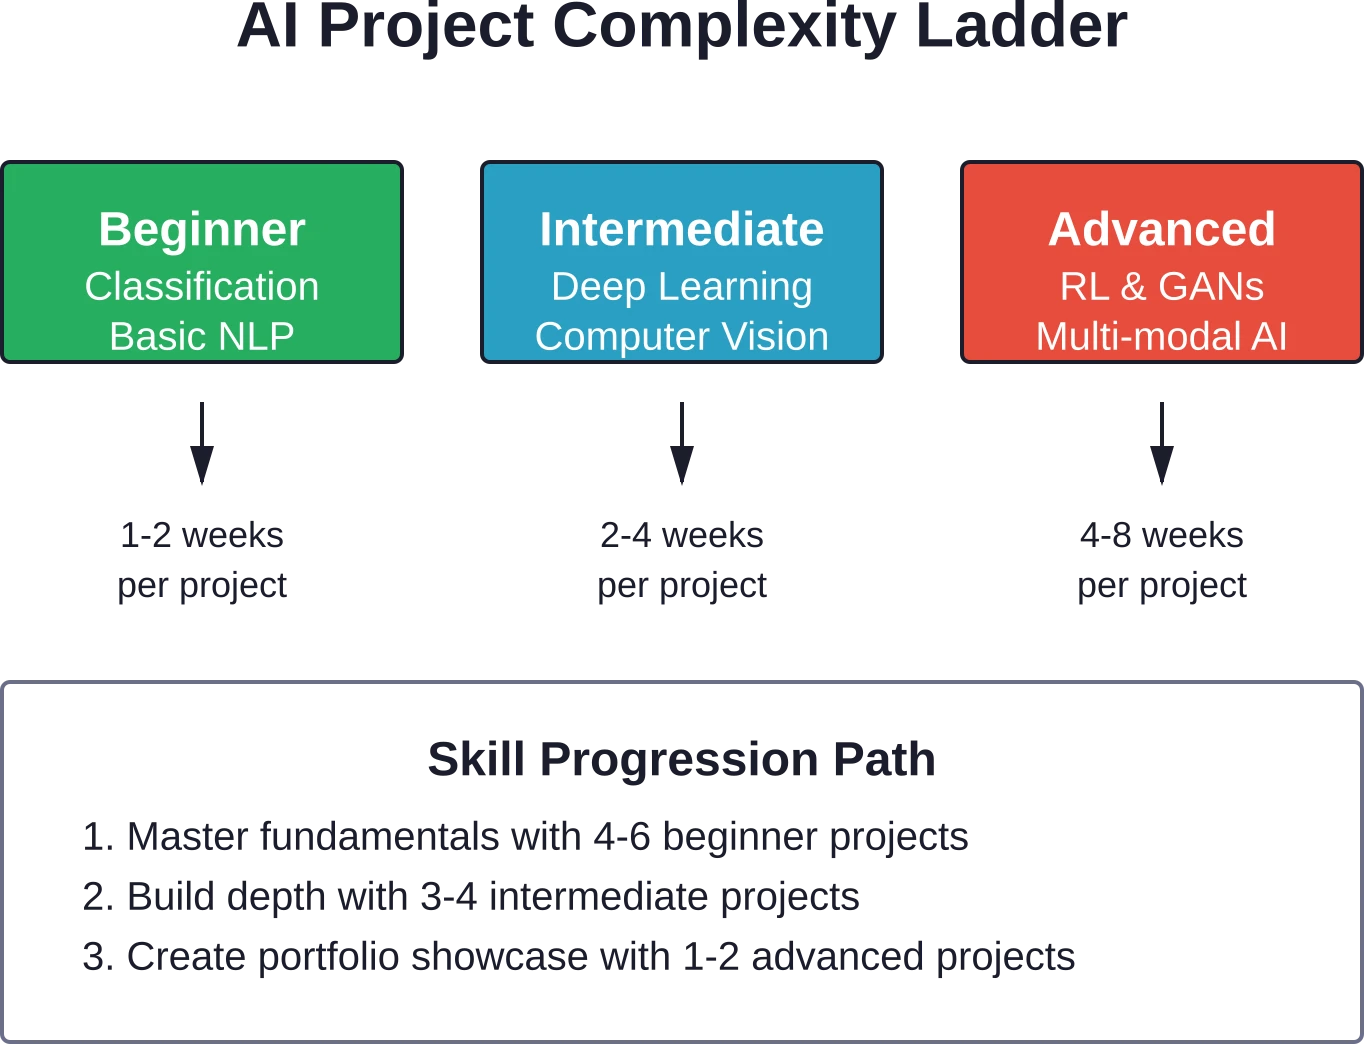
Stem de complexiteit af op uw huidige niveau. Succes geeft vaart: drie afgeronde beginnersprojecten leveren meer zelfvertrouwen op dan één half afgemaakt geavanceerd project.
Datakwaliteit negeren
Wie zich alleen op de modelarchitectuur richt en dataproblemen over het hoofd ziet, krijgt gegarandeerd slechte resultaten. Slechte data valt niet te repareren met een beter model.
Besteed tijd aan het opschonen, verkennen en valideren van uw data. Ken de beperkingen ervan. Leg aannames en beslissingen over voorbewerking vast.
Onvoldoende testen
Een hoge nauwkeurigheid op een testset zegt niets als die testset niet representatief is voor de echte data. Data leakage, waarbij informatie uit de testset de training beïnvloedt, geeft vals vertrouwen.
Splits train- en testdata op de juiste manier. Test bij tijdreeksen op toekomstige data, niet op willekeurig gekozen punten. Gebruik cross-validatie bij kleine datasets. Wantrouw resultaten die te mooi lijken om waar te zijn.
Productie uit het oog verliezen
Een model dat in een notebook werkt maar in productie faalt, heeft weinig waarde. Houd vanaf het begin rekening met latency, geheugen, dependencies en foutafhandeling.
Test op representatieve hardware. Meet de inferentietijd. Vang randgevallen af. Productierijpe code hoort bij het project en is geen bijzaak.
Bronnen voor AI-projecten
Goede bronnen versnellen het leren en leveren ideeën voor projecten op.
Datasets
Kaggle heeft duizenden datasets uit allerlei domeinen, plus competities met duidelijk afgebakende problemen. De UCI Machine Learning Repository bevat klassieke datasets voor benchmarking. Hugging Face Datasets maakt NLP- en multimodale data makkelijk toegankelijk.
Dataportalen van overheden, zoals data.gov en de datasets van NIH en NASA, bieden echte data voor projecten van maatschappelijk nut.
Voorgetrainde modellen
De Hugging Face Model Hub biedt duizenden voorgetrainde modellen voor NLP, computer vision en audio. TensorFlow Hub en PyTorch Hub zijn vergelijkbaar.
Met transfer learning, waarbij u een voorgetraind model finetunet op een specifieke taak, haalt u betere resultaten met minder data en rekenkracht dan wanneer u vanaf nul traint.
Leerplatforms
De cursussen van Fast.ai richten zich op praktische implementatie. Coursera en edX bieden stof op universitair niveau. YouTube-kanalen als StatQuest leggen concepten helder uit.
Op arXiv staan de nieuwste wetenschappelijke artikelen. Wie ze leest, krijgt zicht op actuele technieken en onderzoeksrichtingen.
Community's
Reddit-community's als r/MachineLearning en r/learnmachinelearning bieden steun en feedback. Stack Overflow helpt bij concrete bugs. Op Discord-servers en in Slack-community's wordt realtime gediscussieerd.
Wie vragen stelt, anderen helpt en projecten deelt, leert sneller dankzij de kennis van de groep.
AI-projecten per doel
Kies projecten die passen bij wat u wilt bereiken.
Voor uw eerste AI-baan
Richt u op end-to-endprojecten die praktische vaardigheden laten zien: dataverzameling, voorbewerking, modeltraining, evaluatie en deployment. Kies bij voorkeur problemen met duidelijke zakelijke waarde, zoals voorspelling van klantverloop, aanbevelingssystemen of fraudedetectie.
Neem minstens één project op dat met de rommel van de praktijk omgaat: ontbrekende data, klassenonevenwicht, onbetrouwbare labels.
Voor academisch onderzoek
Kies problemen die het vakgebied verder helpen: nieuwe architecturen, nieuwe toepassingen van bestaande technieken of grondige empirische vergelijkingen. Documenteer de methodologie nauwkeurig. Vergelijk met gevestigde baselines. Overweeg om het werk in te dienen bij conferenties of tijdschriften.
Voor freelancewerk of consultancy
Bouw projecten die gangbare zakelijke problemen oplossen: geautomatiseerde gegevensverwerking, predictive analytics, natural language understanding voor klantenservice. Maak de ROI zichtbaar: laat zien hoeveel tijd of geld uw oplossing bespaart.
Zorg voor verzorgde demo's en documentatie die ook niet-technische klanten begrijpen.
Voor het starten van een AI-product
Ga na of het probleem de moeite waard is voordat u een complexe oplossing bouwt. Begin met een minimum viable product. Richt u op één use case en één gebruikerssegment. Verzamel vroeg en vaak feedback.
Veel succesvolle AI-producten begonnen als persoonlijk project dat een probleem van de maker zelf oploste.
Veelgestelde vragen
Welke programmeertalen heb ik nodig voor AI-projecten?
Python is de belangrijkste taal voor AI-projecten, dankzij bibliotheken als TensorFlow, PyTorch, scikit-learn en pandas. R is geschikt voor statistische analyse en data science. Voor productiesystemen die hoge prestaties vragen, bieden talen als C++ of Julia snelheidsvoordelen. De meeste beginners doen er goed aan met Python te starten: het biedt de beste balans tussen mogelijkheden, leermateriaal en vraag op de arbeidsmarkt. Met JavaScript-frameworks als TensorFlow.js kunt u zo nodig AI-toepassingen in de browser bouwen.
Hoe lang duurt het om een AI-project af te ronden?
Dat hangt af van de complexiteit en uw ervaring. Beginnersprojecten zoals spamdetectie of eenvoudige beeldclassificatie kosten doorgaans 1-2 weken bij parttime werk. Projecten op gemiddeld niveau, met deep learning of meerdere databronnen, vragen 2-4 weken. Geavanceerde projecten zoals reinforcement learning-agents of multimodale systemen kunnen 4-8 weken of langer duren. Regelmaat telt: elke dag een paar uur gericht werken levert meer op dan af en toe een intensieve sessie. Door een project op te delen in mijlpalen (dataverzameling, baselinemodel, optimalisatie, deployment) houdt u de voortgang bij en blijft er vaart in.
Heb ik dure hardware nodig om AI-projecten te bouwen?
Niet per se. Veel projecten voor beginners en op gemiddeld niveau draaien op een gewone laptop, zeker met kleine tot middelgrote datasets en voorgetrainde modellen. Google Colab geeft kosteloos toegang tot GPU's om deep learning-modellen te trainen zonder te investeren in hardware. Cloudplatforms (AWS, Google Cloud, Azure) rekenen af per gebruik voor grotere experimenten. Geavanceerde projecten met enorme datasets of het vanaf nul trainen van grote modellen vragen wel veel rekenkracht, maar met transfer learning en kleinere problemen is AI toegankelijk zonder dure hardware. U leert vooral door problemen op te lossen en te experimenteren, niet door ruwe rekenkracht.
Waar vind ik datasets voor AI-projecten?
Kaggle heeft duizenden datasets voor uiteenlopende domeinen en niveaus, plus gestructureerde competities. De UCI Machine Learning Repository bevat klassieke benchmarkdatasets. Hugging Face Datasets geeft eenvoudig toegang tot NLP-corpora en multimodale collecties. Overheidsportalen zoals data.gov en de datasets van NASA en NIH bieden openbare data uit de praktijk. Met Google Dataset Search vindt u datasets op het web. Wetenschappelijke artikelen verwijzen vaak naar hun datasets. Voor domeinspecifieke projecten bestaan sectorgerichte bronnen: financiële data van Alpha Vantage of FRED, medische beelden van NIH, satellietbeelden van NASA. Met webscraping kunt u een eigen dataset samenstellen als openbare bronnen tekortschieten, mits u de gebruiksvoorwaarden en robots.txt-bestanden respecteert.
Moet ik me specialiseren in één AI-richting of breed leren?
Begin breed om te ontdekken wat u aanspreekt en specialiseer u daarna op basis van uw interesses en carrièredoelen. Door uiteenlopende beginnersprojecten te bouwen (classificatie, regressie, NLP, computer vision) maakt u kennis met verschillende soorten problemen en technieken. Zodra duidelijk wordt wat u leuk vindt en wat u goed afgaat, kunt u zich daarin verdiepen. Een specialisatie (computer vision, NLP, reinforcement learning, generatieve modellen) onderscheidt u op de arbeidsmarkt en laat u echte expertise opbouwen. Basisvaardigheden zoals datavoorbewerking, modelevaluatie, debuggen en deployment zijn echter in elk domein bruikbaar, en in de praktijk combineren projecten vaak meerdere specialisaties. Een brede basis met diepgang op één terrein geeft de beste mix van flexibiliteit en expertise.
Hoe weet ik of mijn AI-project goed genoeg is voor mijn portfolio?
Een goed portfolioproject laat zien dat u problemen kunt oplossen; perfect hoeft het niet te zijn. Let op: een goed gedefinieerde probleemstelling, een systematische aanpak van data en modellering, een degelijke evaluatiemethode, een eerlijke bespreking van de beperkingen en heldere documentatie. Het project moet betrouwbaar werken, ook als de prestaties niet op het niveau van de nieuwste onderzoeksresultaten liggen. Een project van begin tot eind afronden weegt zwaarder dan topscores op benchmarks. Documentatie die uw proces, beslissingen en lessen uitlegt, is vaak belangrijker dan technische verfijning. Hebt u er iets van geleerd en kunt u uitleggen wat u hebt gebouwd en waarom, dan hoort het in uw portfolio. Een verzorgde presentatie (een duidelijke README, geordende code, visualisaties) maakt elk project sterker, ongeacht de complexiteit.
Wat is het verschil tussen AI-projecten om te leren en projecten voor sollicitaties?
Leerprojecten draaien om het begrijpen van concepten en technieken: tutorials doorlopen, algoritmen vanaf nul implementeren, resultaten uit papers reproduceren. Projecten voor sollicitaties leggen de nadruk op praktisch probleemoplossen en productierijpheid: omgaan met rommelige echte data, rekening houden met beperkingen bij deployment, grondig documenteren en zakelijke waarde aantonen. Geef in een portfolio voorrang aan projecten die een afgebakend probleem van begin tot eind oplossen, duidelijke documentatie en visualisaties bevatten, betrouwbaar werken (niet alleen onder ideale omstandigheden), vaardigheden tonen die relevant zijn voor de functies waarop u solliciteert en een groei in complexiteit laten zien. Een leerproject wordt een portfolioproject als u er grondige documentatie, deployment (al is het een eenvoudige webinterface) en een bespreking van praktijkzaken als schaalbaarheid, latency en foutafhandeling aan toevoegt.
De eerste stap
Tussen lezen over AI en AI-systemen bouwen zit alleen de daad zelf. Theorie geeft een basis, maar vaardigheid bouwt u op met projecten.
Begin eenvoudig. Kies een project uit de lijst voor beginners dat u aanspreekt en zorg dat er deze week een basisversie werkt. Mik niet op perfectie, maar op iets dat af is.
In AI worden de mensen beloond die bouwen. Modellen worden beter door iteratie, vaardigheden door oefening, en een portfolio groeit project voor project.
Volgens AI-strategieën van overheden wedijveren organisaties wereldwijd om AI-capaciteiten op te bouwen. Het ecosysteem dat wint, bepaalt de wereldwijde standaarden en plukt de economische vruchten. Dat biedt kansen voor ontwikkelaars die met echte projecten kunnen laten zien wat ze praktisch met AI kunnen.
De tools zijn er, de data is beschikbaar en de kennis is toegankelijk. Wat ontwikkelaars met geslaagde AI-projecten onderscheidt van de rest, is geen talent of budget. Ze zijn gewoon begonnen.
Kies een project. Schrijf de eerste regel code. Los de eerste fout op. U leert door te doen, niet door te plannen.