Korte samenvatting: De prijzen van LLM's lopen sterk uiteen tussen aanbieders: inputtokens kosten van $0,10 tot $5 per miljoen en outputtokens van $0,40 tot $25 per miljoen (stand maart 2026). De GPT-modellen van OpenAI, Claude van Anthropic en Gemini van Google domineren de markt, elk met eigen prijs-prestatieniveaus. Inzicht in prijsstelling op basis van tokens, contextvensters en gebruikspatronen is essentieel om de kosten te optimaliseren zonder in te leveren op kwaliteit.
De explosieve groei van API's voor grote taalmodellen heeft een complex prijslandschap opgeleverd. Organisaties moeten cruciale beslissingen nemen over welke modellen voor hun specifieke toepassingen de beste prijs-kwaliteitverhouding bieden.
Maar let op: de keuze voor een model draait niet alleen om het vinden van de goedkoopste optie. De economie van LLM-inferentie hangt af van meerdere factoren: tokenprijzen, de grenzen van het contextvenster, latentie-eisen en verborgen kosten die uw rekening met een factor 2 tot 3 kunnen verhogen.
Deze vergelijking analyseert de prijzen van de grote aanbieders, waaronder OpenAI, Anthropic en Google, en van opkomende alternatieven. De gegevens geven de prijzen weer per maart 2026; aanbieders passen hun tarieven echter regelmatig aan.
Prijsmodellen op basis van tokens
LLM-aanbieders rekenen af op basis van het aantal verwerkte tokens. Een token staat voor ongeveer 4 tekens tekst, of circa 0,75 woord in het Engels. De string "ChatGPT is great!" wordt bijvoorbeeld opgesplitst in zes tokens: ["Chat", "G", "PT", " is", " great", "!"].
De meeste aanbieders splitsen de prijs op in twee componenten: inputtokens (wat ontwikkelaars naar het model sturen) en outputtokens (wat het model genereert). Outputtokens kosten doorgaans 3 tot 5 keer zoveel als inputtokens, omdat het genereren van tekst meer rekenkracht vergt.
Het totale aantal tokens in een API-aanroep bepaalt drie cruciale factoren: wat de aanroep kost, hoe lang de verwerking duurt en of de aanroep binnen het contextvenster van het model past.
Contextvensters en caching
Het contextvenster bepaalt het maximale aantal tokens dat een model in één verzoek kan verwerken. Begin 2026 zijn contextvensters sterk gegroeid. Claude Opus 4.6 van Anthropic heeft in bèta een contextvenster van 1 miljoen tokens, terwijl de meeste productiemodellen vensters van 128K tot 200K tokens bieden.
Grotere contextvensters maken geavanceerdere toepassingen mogelijk, maar verhogen de kosten evenredig. Een input van 100K tokens tegen $3 per miljoen tokens kost $0,30 per verzoek. Vermenigvuldig dat met duizenden verzoeken per dag en de kosten lopen snel op.
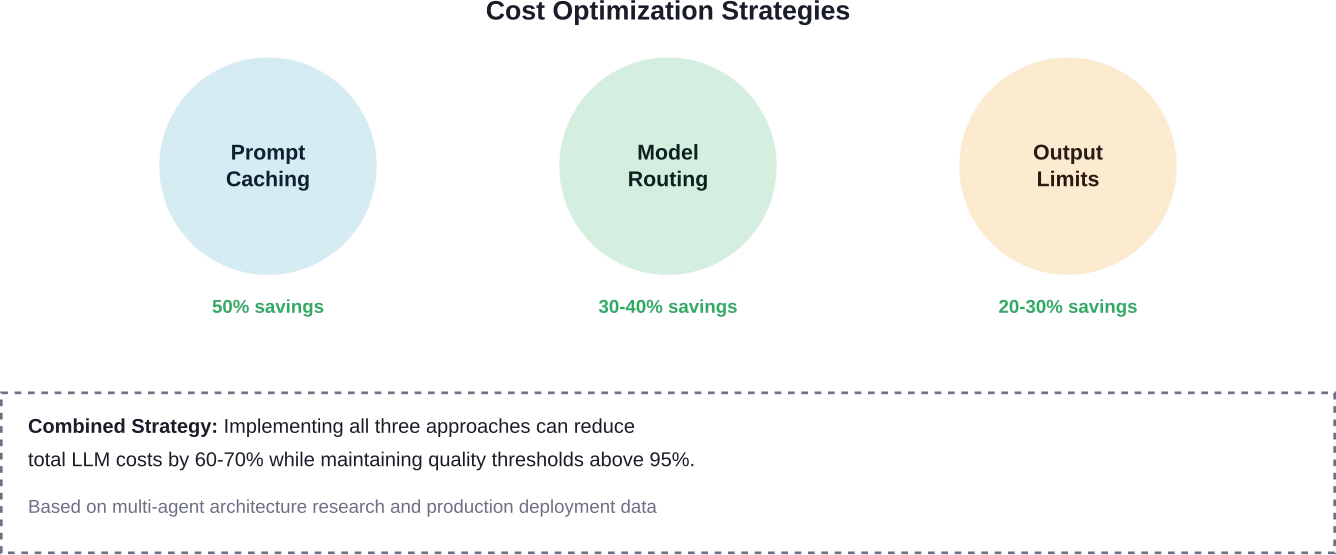
Prompt caching levert aanzienlijke besparingen op. OpenAI rekent voor gecachete input 50% van de standaard inputprijs. Volgens de prijsdocumentatie van OpenAI kost GPT-4.1 $2,00 per miljoen inputtokens, maar slechts $0,50 per miljoen gecachete inputtokens.
Prijzen van de belangrijkste aanbieders
Het speelveld bestaat uit drie dominante spelers en diverse opkomende alternatieven. Elke aanbieder biedt meerdere modelniveaus, geoptimaliseerd voor verschillende toepassingen.
Prijsstructuur van OpenAI
De GPT-modellen van OpenAI beslaan verschillende niveaus van intelligentie en kosten. Zoals besproken in communitydiscussies van januari 2026, blijven de prijzen veranderen naarmate er nieuwe modellen verschijnen.
| Model | Input (per 1M tokens) | Gecachete input (per 1M) | Output (per 1M tokens) | Contextvenster |
|---|---|---|---|---|
| GPT-4.1 | $2,00 | $0,50 | $8,00 | 128K |
| GPT-4o | $2,50 | $1,25 | $10,00 | 128K |
| GPT-4-32k (uitgefaseerd) | $60,00 | n.v.t. | $120,00 | 32K |
OpenAI heeft de GPT-4-32k-modellen uitgefaseerd, met stopzetting gepland op 6 juni 2025. Volgens de uitfaseringsdocumentatie van OpenAI hadden bestaande gebruikers beperkte tijd om over te stappen naar nieuwere modellen zoals GPT-4o.
De GPT-5.4-modelfamilie is de nieuwste stap van OpenAI. GPT-5.4 mini verscheen in maart 2026 en werd voor Free- en Go-gebruikers beschikbaar via de functie "Thinking" in ChatGPT. Voor betalende gebruikers dient GPT-5.4 mini als terugvaloptie wanneer de rate limit van GPT-5.4 Thinking is bereikt.
Prijzen van Anthropic Claude
De Claude-modellen van Anthropic zijn uitgegroeid tot sterke concurrenten van OpenAI, vooral voor programmeertaken en agentische taken. Het bedrijf bracht Claude Opus 4.6 uit in februari 2026 en kort daarna Claude Sonnet 4.6.
Claude Opus 4.6 blijft geprijsd op $5 per miljoen inputtokens en $25 per miljoen outputtokens, ondanks aanzienlijk betere prestaties. Volgens de aankondiging van Anthropic is deze prijs ongewijzigd ten opzichte van de vorige versie, Opus 4.5.
Claude Sonnet 4.6 is toegankelijker geprijsd met $3 per miljoen inputtokens en $15 per miljoen outputtokens, hetzelfde tarief als Sonnet 4.5. Anthropic beschrijft Sonnet 4.6 als een model dat de intelligentie van Opus benadert, tegen een praktischere prijs voor alledaagse taken.
| Model | Input (per 1M tokens) | Output (per 1M tokens) | Contextvenster | Het meest geschikt voor |
|---|---|---|---|---|
| Claude Opus 4.6 | $5,00 | $25,00 | 1M (bèta) | Complex redeneren, programmeren, agents |
| Claude Sonnet 4.6 | $3,00 | $15,00 | 1M (bèta) | Balans tussen prestaties en kosten |
| Claude Opus 4.5 | $5,00 | $25,00 | 200K | Bestaande (legacy) toepassingen |
Het contextvenster van 1 miljoen tokens in Claude Opus 4.6 is een primeur voor de Opus-modellen van Anthropic. Hierdoor kunnen complete codebases of omvangrijke documenten in één verzoek worden verwerkt.
Prijzen van Google Gemini
De Gemini-modellen van Google concurreren scherp op prijs, vooral voor toepassingen met hoge volumes. De Gemini-familie omvat meerdere niveaus die zijn geoptimaliseerd voor verschillende prestatie-eisen.
De prijsstructuur van Gemini-modellen varieert sterk per niveau en gebruiksvolume. Google positioneert Gemini als een kosteneffectief alternatief voor toepassingen die sterke prestaties vereisen zonder premiumprijs. 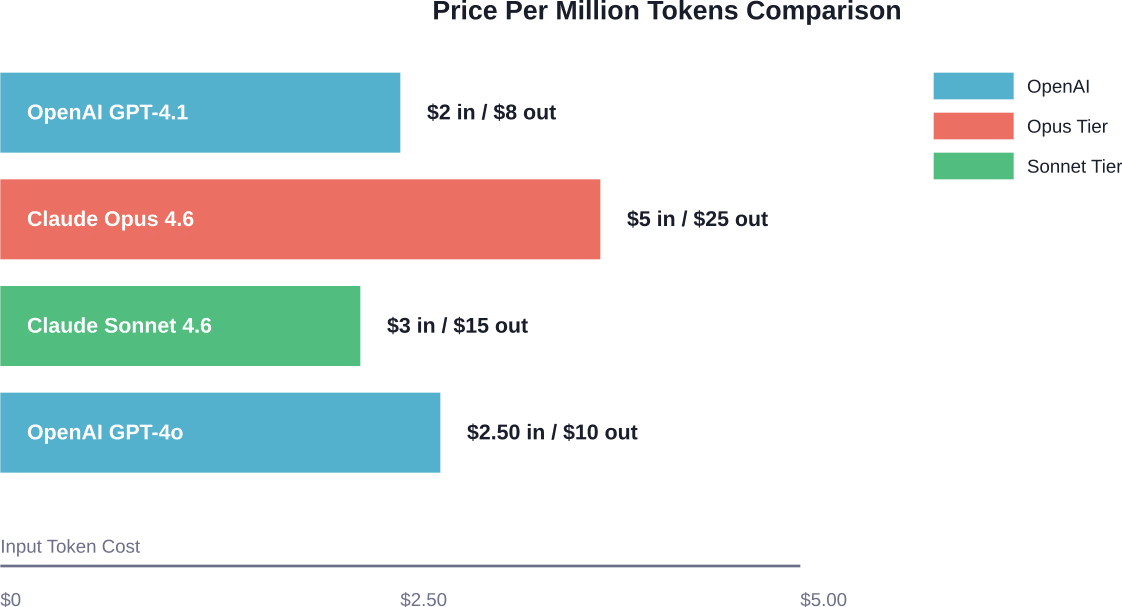
Verborgen kosten en prijsmechanismen
De geadverteerde prijs per token vertelt maar een deel van het verhaal. Diverse verborgen factoren kunnen de werkelijke kosten flink opdrijven.
De meerprijs van outputtokens
Bij alle aanbieders kosten outputtokens steevast 3 tot 5 keer zoveel als inputtokens. Een toepassing die lange antwoorden genereert, heeft daardoor onevenredig hogere kosten dan een toepassing die veel input verwerkt maar beknopte output geeft.
Het instellen van een maximum aantal outputtokens (de parameter max_tokens) helpt de kosten te beheersen. Staat deze te laag, dan worden antwoorden afgebroken voordat ze af zijn. Staat deze te hoog, dan kan het model overbodige tekst genereren, vooral bij een hogere temperature-instelling die creativiteit stimuleert.
Rate limits en kosten van terugvalmodellen
De meeste aanbieders hanteren rate limits op basis van verzoeken per minuut, tokens per minuut of beide. Bereikt een toepassing deze limieten, dan mislukken verzoeken of wordt overgeschakeld op alternatieve modellen.
De implementatie van GPT-5.4 door OpenAI illustreert dit patroon. Volgens de release notes van OpenAI uit maart 2026 krijgen betalende gebruikers GPT-5.4 mini als terugvaloptie wanneer de rate limits van GPT-5.4 Thinking zijn bereikt. Zo blijft de dienst beschikbaar, maar mogelijk met een andere kostenstructuur.
De economie van contextvensters
Grotere contextvensters maken geavanceerdere toepassingen mogelijk, maar de kosten stijgen lineair mee. Bij een contextlengte van 128K tokens bereikt de KV-cache van LLama2-7B in half precision 64 GB, berekend als: num_layers × num_kv_head × head_dim × seqlen × sizeof(fp16) × 2.
Onderzoek naar de efficiëntie van LLM-decoding laat zien dat de KV-cache lineair meegroeit met de sequentielengte. Dat veroorzaakt geheugenknelpunten tijdens het decoderen, die zich vertalen in hogere operationele kosten.
Prijsoverwegingen voor ondernemingen
Voor enterprise-implementaties gelden andere economische wetten dan voor individuele ontwikkelaars of kleine teams. Volumekortingen, prijzen op maat en implementatieopties hebben grote invloed op de total cost of ownership.
Cloud-API of zelf hosten
Organisaties kunnen een abonnement nemen op commerciële LLM-diensten of modellen op hun eigen infrastructuur draaien. Onderzoek op arXiv naar on-premise implementatie van LLM's toont aan dat voor het bereiken van het break-evenpunt ten opzichte van commerciële diensten een zorgvuldige analyse van gebruikspatronen en infrastructuurkosten nodig is.
De studie hanteerde vier criteria voor modelselectie: prestaties binnen 20% van de beste commerciële modellen, operationele compatibiliteit, beveiligingseisen en kostenefficiëntie op schaal. Bij toepassingen met hoge volumes kan zelf hosten de kosten verlagen, maar de initiële investering in infrastructuur blijft aanzienlijk.
Kostenoptimalisatie met hiërarchische architecturen
Recent benchmarkonderzoek naar multi-agent LLM-architecturen voor de verwerking van financiële documenten liet zien dat hiërarchische architecturen de beste balans tussen kosten en nauwkeurigheid bieden. Deze systemen haalden 97,7% van de nauwkeurigheid van reflexieve architecturen, tegen 60,9% van de kosten.
Het onderzoek toonde aan dat semantische caching, model routing en adaptieve verwerking de operationele kosten sterk kunnen verlagen zonder in te leveren op kwaliteit. Deze technieken worden steeds belangrijker naarmate toepassingen opschalen naar miljoenen verzoeken per dag.
Opkomende alternatieven en regionale prijzen
Naast de drie grote aanbieders zijn er diverse alternatieven met concurrerende prijzen voor specifieke toepassingen.
DeepSeek en open-sourcemodellen
DeepSeek trekt de aandacht met scherpe prijzen voor capabele modellen. Het bedrijf positioneert zich als kosteneffectief alternatief voor toepassingen die niet per se de allerbeste prestaties vereisen.
Open-sourcemodellen die via cloud-GPU-aanbieders zoals RunPod worden gedraaid, bieden een andere route. Deze diensten rekenen per GPU-uur in plaats van per token, waardoor de kosten bij hoge volumes beter voorspelbaar zijn.
Gespecialiseerde modelaanbieders
Mistral, de Llama-familie van Meta en de modellen van NVIDIA bedienen elk een eigen niche. Volgens een modelvergelijking uit augustus 2025 moet bij de modelkeuze niet alleen naar de prijs worden gekeken, maar ook naar het beoogde doel van het model, de technische specificaties en de toepassingen waarvoor het het meest geschikt is.
De analyse benadrukt dat verschillende modellen in verschillende taken uitblinken. Wie uitsluitend op de laagste kosten kiest, krijgt vaak slechte resultaten en dure herverwerking.
Praktisch kader voor kostenberekening
Om de werkelijke kosten te schatten, moet u de gebruikspatronen van uw specifieke toepassing kennen. De vier belangrijkste parameters zijn: het gemiddelde aantal inputtokens per verzoek, het gemiddelde aantal outputtokens per verzoek, het verwachte aantal verzoeken per dag en het gekozen modelniveau.
Een eenvoudige berekening: (inputtokens × inputprijs + outputtokens × outputprijs) × verzoeken per dag × 30 dagen = maandelijkse kosten.
Een voorbeeld: een toepassing die per verzoek 10.000 inputtokens verwerkt en 2.000 outputtokens genereert, met 1.000 verzoeken per dag op Claude Sonnet 4.6: (10.000 × $0,000003 + 2.000 × $0,000015) × 1.000 × 30 = $1.800 per maand.
Eerlijk gezegd: de meeste toepassingen onderschatten het werkelijke tokengebruik in de planningsfase met een factor 2 tot 3. Neem dus een ruime marge in uw schattingen.
Prestaties versus prijs
Het goedkoopste model biedt zelden de beste prijs-kwaliteitverhouding. Volgens onderzoek naar de economie van AI-inferentie lopen de "marginale kosten" van LLM-inferentie sterk uiteen, afhankelijk van de rekenefficiëntie en de modelarchitectuur.
Studies naar query-benadering met lichtgewicht proxymodellen toonden aan dat een strategische modelkeuze kosten en latentie tot een factor 100 kan verlagen. De proxymodellen haalden in het onderzoek een nauwkeurigheid van meer dan 90%, terwijl de kosten voor specifieke typen query's drastisch daalden.
Lokale implementatie op consumentenhardware is een andere optie. Onderzoek naar de efficiëntie van lokale taalmodellen wees uit dat lokale LM's 88,7% van de chat- en redeneervragen met één beurt correct kunnen beantwoorden, al gaat dat gepaard met een aanzienlijk hogere latentie dan bij implementaties in datacenters.
Afweging tussen latentie en kosten
Snellere modellen kosten doorgaans meer of vereisen een premiumniveau. Toepassingen met strenge latentie-eisen moeten mogelijk hogere kosten per token accepteren om aan de prestatie-SLA's te voldoen.
De verwachte latentie verschilt per model en implementatie: topmodellen leveren doorgaans 20 tot 40 tokens per seconde, middenklassemodellen 40 tot 80 tokens per seconde, en geoptimaliseerde modellen kunnen op dedicated infrastructuur meer dan 100 tokens per seconde halen.
Vergelijk modellen zorgvuldig en bouw rond het juiste model
Meer dan 15 LLM's alleen op prijs vergelijken geeft zelden het volledige beeld. De werkelijke kosten worden bepaald door de manier waarop modellen worden geïmplementeerd: datakwaliteit, fine-tuningstrategie en infrastructuurkeuzes bepalen samen wat u op termijn daadwerkelijk betaalt. AI Superior ondersteunt de volledige levenscyclus, van datavoorbereiding en modelselectie tot training, optimalisatie en implementatie, en helpt teams modellen te kiezen en te configureren op basis van concrete toepassingen in plaats van oppervlakkige prijsinformatie.
In de praktijk betekent dit vaak dat u te zware modellen vermijdt waar ze niet nodig zijn, of benaderingen zoals fine-tuning en hybride opstellingen combineert in plaats van op één model of API te vertrouwen. De nadruk ligt op systemen die efficiënt draaien in productie, niet alleen op het vergelijken van benchmarks. Evalueert u meerdere LLM's en wilt u weten wat ze in de praktijk werkelijk kosten, dan is het verstandig uw opzet in een vroeg stadium te laten beoordelen. Neem contact op met AI Superior om uw modelkeuze af te stemmen op de werkelijke kosten, en niet alleen op de catalogusprijs.
Toekomstige prijstrends
De prijzen van LLM's blijven zich snel ontwikkelen. In 2025 en begin 2026 tekenden zich enkele duidelijke trends af.
Contextvensters werden veel groter, terwijl de prijzen per token daalden. Claude Opus 4.6 en Sonnet 4.6 bieden allebei contextvensters van 1 miljoen tokens tegen dezelfde prijs als de eerdere modellen met een venster van 200K. Dat is een aanzienlijke uitbreiding van het contextvenster zonder evenredige prijsstijging.
Modellen worden sneller uitgefaseerd. Dat OpenAI de GPT-4-32k-varianten binnen 12 tot 18 maanden na de release uitfaseerde, wijst op snellere iteratiecycli. Organisaties moeten rekening houden met regelmatige modelmigraties en de bijbehorende ontwikkelkosten.
Het verschil tussen topmodellen en middenklassemodellen is kleiner geworden. Volgens Anthropic benadert Claude Sonnet 4.6 het intelligentieniveau van Opus tegen 60% van de kosten. Deze kleinere capaciteitsverschillen tussen prijsniveaus zijn gunstig voor kostenbewuste implementaties.
Veelgestelde vragen
Wat is in 2026 het goedkoopste LLM voor productiegebruik?
DeepSeek en Google Gemini hebben de laagste kosten per token van de grote aanbieders, maar "goedkoopst" betekent niet altijd de beste prijs-kwaliteitverhouding. De totale kosten hangen af van de eisen aan nauwkeurigheid, de behoefte aan herverwerking en de benodigde grootte van het contextvenster. Voor veel toepassingen zijn middenklassemodellen zoals Claude Sonnet 4.6, met $3/$15 per miljoen tokens, economisch voordeliger dan de allerlaagste prijzen met output van mindere kwaliteit.
Hoeveel bespaart prompt caching werkelijk?
Met de prijzen van OpenAI voor gecachete input bespaart u 50% op herhaalde promptsegmenten. Voor toepassingen met vaste systeemprompts of referentiedocumenten betekent dit een totale kostenbesparing van 30 tot 50%. De besparing is het grootst bij toepassingen die duizenden vergelijkbare verzoeken met gedeelde context verwerken.
Moeten ondernemingen LLM's zelf hosten of API's gebruiken?
Onderzoek naar de economie van on-premise implementaties wijst erop dat het break-evenpunt alleen haalbaar is bij consistent hoge volumes en een geschikte technische infrastructuur. Toepassingen die minder dan 100 miljoen tokens per maand verwerken, zijn met API-prijzen doorgaans voordeliger uit. Boven die drempel wordt zelf hosten een reële optie, maar houd naast de pure rekenkosten ook rekening met DevOps-overhead, modelupdates en de kosten van infrastructuurbeheer.
Waarom kosten outputtokens meer dan inputtokens?
Genereren vergt aanzienlijk meer rekenkracht dan verwerken. Inputtokens gaan één keer door het model voor de codering, terwijl voor elk outputtoken een volledige forward pass nodig is om het volgende token te voorspellen. Dat levert een verschil in rekenkracht van 3 tot 5 keer op, wat bij alle aanbieders terug te zien is in de prijsstructuur.
Hoe schat ik het tokengebruik van mijn toepassing in?
Gebruik de tokenizer-tools van de betreffende modelleverancier om typische verzoeken te meten. OpenAI, Anthropic en Google bieden allemaal tokenizer-API's of webtools. Test met representatieve voorbeelddata, vermenigvuldig met het verwachte aantal verzoeken en tel er een buffer van 50% bij op voor schommelingen. De meeste planningsschattingen onderschatten het werkelijke gebruik met een factor 2 tot 3.
Wat gebeurt er als ik de rate limits bereik?
Dat hangt af van de aanbieder en het niveau. Sommige implementaties zetten verzoeken in een wachtrij, andere geven een rate-limitfout terug waardoor retrylogica nodig is, en bij premiumniveaus kan worden teruggevallen op alternatieve modellen. GPT-5.4 van OpenAI valt voor betalende gebruikers terug op GPT-5.4 mini wanneer de rate limits zijn bereikt. Raadpleeg de documentatie van de aanbieder voor de afhandeling van rate limits per niveau.
Zijn er volumekortingen voor LLM-API's?
De meeste aanbieders hebben zakelijke tarieven met volumekortingen, al worden de voorwaarden niet openbaar gemaakt. Organisaties die per maand meer dan 1 miljard tokens verwerken, doen er goed aan rechtstreeks contact op te nemen met het salesteam. Kortingen liggen doorgaans tussen 10 en 30%, afhankelijk van de afnameverplichting en het gebruiksvolume. Anthropic, OpenAI en Google hebben allemaal enterprise-salesprogramma's met prijzen op maat.
Conclusie
Het prijslandschap van LLM's blijft complex en verandert snel. Per maart 2026 lopen de kosten per token uiteen van minder dan $1 per miljoen tot $25 per miljoen, afhankelijk van het modelniveau en het type token.
Economisch loont een strategische modelkeuze meer dan simpelweg de goedkoopste optie kiezen. Claude Sonnet 4.6 levert voor $3/$15 per miljoen tokens bijna topprestaties voor alledaagse taken. GPT-4.1 van OpenAI biedt voor $2/$8 sterk algemeen redeneervermogen tegen concurrerende tarieven. Claude Opus 4.6 hanteert met $5/$25 een premiumprijs, maar is toonaangevend bij complexe programmeertaken en agentische taken.
Verborgen kosten zijn net zo belangrijk als de vermelde prijs. Prompt caching bespaart 50% op herhaalde input. Beheer van outputtokens voorkomt dat uitvoerige antwoorden de kosten laten exploderen. Hiërarchische architecturen verlagen de totale kosten met 60% met behoud van kwaliteit.
Organisaties moeten de total cost of ownership berekenen, inclusief de afhandeling van rate limits, de uitfaseringscycli van modellen en herverwerking vanwege kwaliteitsproblemen. De laagste prijs per token leidt vaak tot de hoogste totale kosten.
Begin met het benchmarken van representatieve workloads op de kandidaatmodellen. Meet niet alleen de nauwkeurigheid, maar ook het totale aantal verbruikte tokens per succesvol afgeronde taak. Houd rekening met uw specifieke gebruikspatronen, latentie-eisen en benodigde contextvensters. Neem vervolgens een weloverwogen beslissing op basis van de werkelijke waarde in plaats van alleen de vermelde prijs.