En bref : les tarifs des LLM varient fortement d'un fournisseur à l'autre. En mars 2026, les tokens d'entrée coûtent de 0,10 $ à 5 $ par million et les tokens de sortie de 0,40 $ à 25 $ par million. Les modèles GPT d'OpenAI, Claude d'Anthropic et Gemini de Google dominent le marché, chacun avec plusieurs niveaux de prix et de performance. Pour réduire les coûts sans perdre en qualité, il faut comprendre la tarification au token, les fenêtres de contexte et vos propres volumes d'utilisation.
Avec la multiplication des API de grands modèles de langage, la grille tarifaire est devenue difficile à lire. Les organisations doivent choisir les modèles qui offrent le meilleur rapport qualité-prix pour leurs cas d'usage.
Le modèle le moins cher n'est pas forcément le bon choix. Le coût de l'inférence LLM dépend de plusieurs facteurs : le prix des tokens, la taille de la fenêtre de contexte, les exigences de latence et des coûts cachés qui peuvent multiplier la facture par 2 ou 3.
Cette comparaison couvre les tarifs des principaux fournisseurs, dont OpenAI, Anthropic et Google, ainsi que des alternatives plus récentes. Les données correspondent aux prix de mars 2026 ; les fournisseurs ajustent régulièrement leurs tarifs.
Comment fonctionne la tarification au token
Les fournisseurs de LLM facturent en fonction des tokens traités. Un token correspond à environ 4 caractères de texte, soit environ 0,75 mot en anglais. La chaîne « ChatGPT is great! », par exemple, est découpée en six tokens : ["Chat", "G", "PT", " is", " great", "!"].
La plupart des fournisseurs distinguent deux postes : les tokens d'entrée (ce que les développeurs envoient au modèle) et les tokens de sortie (ce que le modèle génère). Les tokens de sortie coûtent en général 3 à 5 fois plus cher, car la génération demande plus de puissance de calcul.
Le nombre total de tokens d'un appel API détermine trois choses : son coût, sa durée et le fait qu'il tienne ou non dans la fenêtre de contexte du modèle.
Fenêtres de contexte et mise en cache
La fenêtre de contexte fixe le nombre maximal de tokens qu'un modèle peut traiter en une seule requête. Début 2026, ces fenêtres se sont nettement agrandies. Claude Opus 4.6 d'Anthropic dispose d'une fenêtre d'un million de tokens en bêta, alors que la plupart des modèles en production proposent entre 128 000 et 200 000 tokens.
Une fenêtre plus grande permet des applications plus ambitieuses, mais le coût augmente proportionnellement. Une entrée de 100 000 tokens à 3 $ par million coûte 0,30 $ par requête ; avec des milliers de requêtes par jour, la facture grimpe vite.
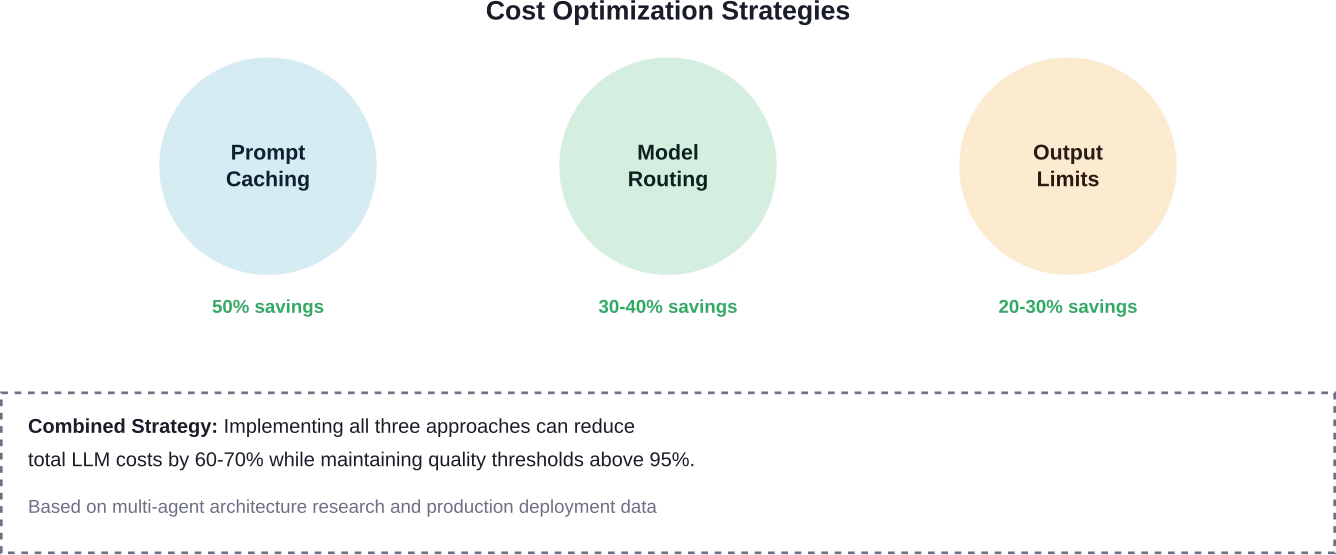
La mise en cache des prompts (prompt caching) permet de réelles économies. Chez OpenAI, les entrées mises en cache sont facturées 50 % du prix d'entrée standard. D'après la documentation tarifaire d'OpenAI, GPT-4.1 coûte 2,00 $ par million de tokens d'entrée, mais seulement 0,50 $ par million de tokens d'entrée en cache.
Tarifs des principaux fournisseurs
Le marché compte trois acteurs dominants et plusieurs alternatives plus récentes. Chaque fournisseur propose plusieurs niveaux de modèles selon les cas d'usage.
Tarifs d'OpenAI
Les modèles GPT d'OpenAI se répartissent sur plusieurs niveaux de capacité et de prix. Comme le montrent des discussions de la communauté de janvier 2026, les tarifs évoluent à chaque lancement de modèle.
| Modèle | Entrée (par million de tokens) | Entrée en cache (par million) | Sortie (par million de tokens) | Fenêtre de contexte |
|---|---|---|---|---|
| GPT-4.1 | 2,00 $ | 0,50 $ | 8,00 $ | 128K |
| GPT-4o | 2,50 $ | 1,25 $ | 10,00 $ | 128K |
| GPT-4-32k (obsolète) | 60,00 $ | N/A | 120,00 $ | 32K |
OpenAI a déclaré obsolètes les modèles GPT-4-32k, dont l'arrêt était prévu le 6 juin 2025. Selon la documentation d'OpenAI sur les dépréciations, les utilisateurs existants disposaient d'un délai limité pour migrer vers des modèles plus récents comme GPT-4o.
La famille GPT-5.4 est la plus récente d'OpenAI. Lancé en mars 2026, GPT-5.4 mini est accessible aux utilisateurs des offres Free et Go via la fonction « Thinking » de ChatGPT. Pour les utilisateurs payants, GPT-5.4 mini prend le relais lorsque les limites de débit de GPT-5.4 Thinking sont atteintes.
Tarifs de Claude (Anthropic)
Les modèles Claude d'Anthropic sont devenus de sérieux concurrents d'OpenAI, en particulier pour le code et les tâches agentiques. Anthropic a lancé Claude Opus 4.6 en février 2026, puis Claude Sonnet 4.6 peu après.
Malgré des capacités nettement améliorées, Claude Opus 4.6 reste à 5 $ par million de tokens d'entrée et 25 $ par million de tokens de sortie. D'après l'annonce d'Anthropic, c'est le même tarif que pour la version précédente, Opus 4.5.
Claude Sonnet 4.6 est plus abordable : 3 $ par million de tokens d'entrée et 15 $ par million de tokens de sortie, comme Sonnet 4.5. Anthropic présente Sonnet 4.6 comme proche du niveau d'Opus, à un prix plus adapté aux tâches courantes.
| Modèle | Entrée (par million de tokens) | Sortie (par million de tokens) | Fenêtre de contexte | Usage recommandé |
|---|---|---|---|---|
| Claude Opus 4.6 | 5,00 $ | 25,00 $ | 1M (bêta) | Raisonnement complexe, code, agents |
| Claude Sonnet 4.6 | 3,00 $ | 15,00 $ | 1M (bêta) | Équilibre performance/coût |
| Claude Opus 4.5 | 5,00 $ | 25,00 $ | 200K | Applications existantes |
Avec sa fenêtre d'un million de tokens, Claude Opus 4.6 est le premier modèle de la classe Opus à atteindre cette taille. Il peut ainsi traiter une base de code entière ou de longs documents en une seule requête.
Tarifs de Google Gemini
Les modèles Gemini de Google se positionnent de manière agressive sur les prix, surtout pour les gros volumes. La famille Gemini comprend plusieurs niveaux selon les performances recherchées.
Les tarifs de Gemini varient beaucoup selon le niveau et le volume d'utilisation. Google présente Gemini comme une alternative économique pour les applications qui ont besoin de bonnes performances sans payer un tarif premium. 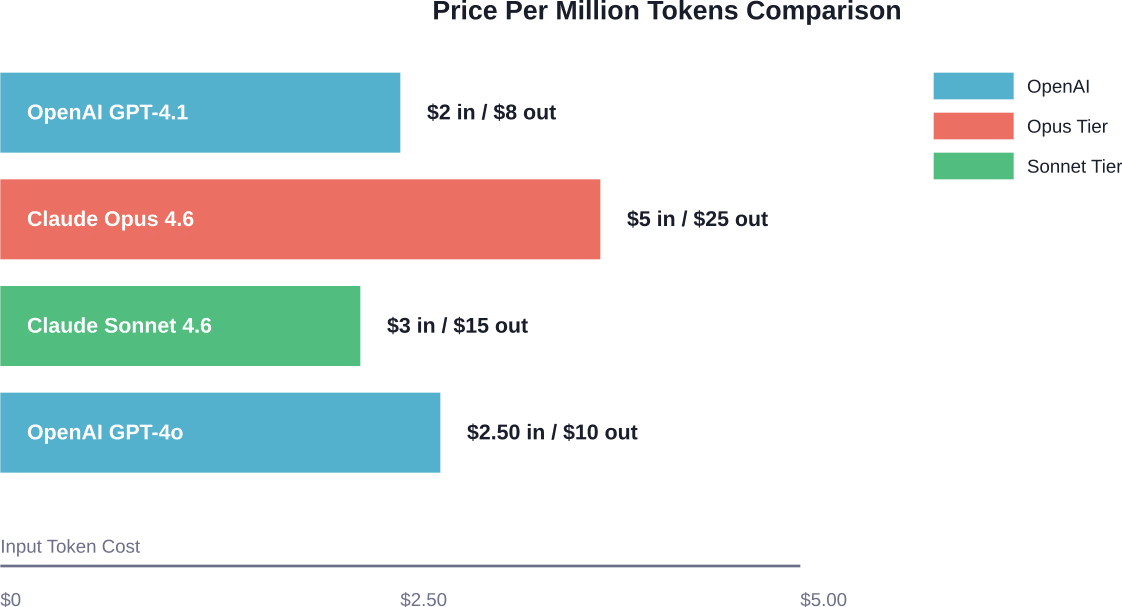
Coûts cachés et mécanismes de facturation
Le prix affiché par token ne dit pas tout. Plusieurs facteurs moins visibles peuvent faire nettement monter le coût réel.
Le poids des tokens de sortie
Chez tous les fournisseurs, les tokens de sortie coûtent 3 à 5 fois plus cher que les tokens d'entrée. Une application qui génère de longues réponses paiera donc beaucoup plus qu'une application qui traite de gros volumes en entrée mais produit des réponses courtes.
Fixer un nombre maximal de tokens de sortie (paramètre max_tokens) aide à maîtriser les coûts. Trop bas, les réponses sont coupées avant la fin. Trop haut, le modèle peut produire du contenu inutile, surtout avec une température élevée qui favorise la créativité.
Limites de débit et modèles de repli
La plupart des fournisseurs imposent des limites de débit en requêtes par minute, en tokens par minute, ou les deux. Quand une application atteint ces limites, elle échoue ou bascule vers un autre modèle.
GPT-5.4 en est un exemple. D'après les notes de version d'OpenAI de mars 2026, les utilisateurs payants passent sur GPT-5.4 mini lorsque les limites de GPT-5.4 Thinking sont atteintes. Le service continue de fonctionner, mais la structure de coûts peut changer.
Ce que coûte une grande fenêtre de contexte
Une fenêtre de contexte plus grande permet des applications plus ambitieuses, mais le coût augmente de façon linéaire. Avec un contexte de 128 000 tokens, le cache KV de Llama2-7B en demi-précision atteint 64 Go, selon la formule : num_layers × num_kv_head × head_dim × seqlen × sizeof(fp16) × 2.
Les travaux de recherche sur l'efficacité du décodage des LLM montrent que la taille du cache KV croît linéairement avec la longueur de séquence. Il en résulte des goulots d'étranglement mémoire pendant le décodage, et donc des coûts d'exploitation plus élevés.
Tarification pour les entreprises
Pour une entreprise, le calcul n'est pas le même que pour un développeur seul ou une petite équipe. Les remises sur volume, les tarifs négociés et les options de déploiement pèsent lourd sur le coût total de possession.
API cloud ou auto-hébergement
Une organisation peut s'abonner à un service LLM commercial ou déployer des modèles sur sa propre infrastructure. Une étude publiée sur arXiv sur le déploiement de LLM sur site conclut que le seuil de rentabilité face aux services commerciaux ne se détermine qu'après une analyse précise des volumes d'utilisation et des coûts d'infrastructure.
L'étude retient quatre critères de choix du modèle : des performances à moins de 20 % des meilleurs modèles commerciaux, la compatibilité opérationnelle, les exigences de sécurité et la rentabilité à grande échelle. Pour les applications à fort volume, l'auto-hébergement peut réduire les coûts, mais l'investissement initial en infrastructure reste important.
Réduire les coûts avec une architecture hiérarchique
Un benchmark récent d'architectures LLM multi-agents pour le traitement de documents financiers montre que les architectures hiérarchiques offrent le meilleur compromis coût/précision. Elles atteignent 97,7 % de la précision d'une architecture réflexive pour 60,9 % de son coût.
La même étude montre que la mise en cache sémantique, le routage entre modèles et le traitement adaptatif réduisent sensiblement les coûts d'exploitation sans perte de qualité. Ces techniques prennent tout leur poids quand une application traite des millions de requêtes par jour.
Autres fournisseurs et tarification régionale
En dehors des trois grands fournisseurs, plusieurs alternatives proposent des prix compétitifs pour des usages précis.
DeepSeek et les modèles open source
DeepSeek s'est fait remarquer par des prix très bas sur des modèles performants. L'entreprise se positionne comme une option économique pour les applications qui n'ont pas besoin des toutes meilleures performances du marché.
Les modèles open source déployés chez des fournisseurs de GPU cloud comme RunPod sont une autre option. Ces services facturent à l'heure de GPU et non au token, ce qui rend les coûts plus prévisibles pour les gros volumes.
Fournisseurs de modèles spécialisés
Mistral, la famille Llama de Meta et les modèles de NVIDIA occupent chacun des niches précises. Selon une analyse comparative publiée en août 2025, le choix d'un modèle doit tenir compte de sa finalité, de ses caractéristiques techniques et des cas d'usage pour lesquels il est le plus adapté, pas seulement de son prix.
Chaque modèle a ses points forts. Choisir uniquement sur le prix le plus bas mène souvent à de mauvais résultats et à des retraitements coûteux.
Méthode pratique de calcul des coûts
Pour estimer le coût réel, il faut connaître l'usage propre à votre application. Quatre paramètres comptent : le nombre moyen de tokens d'entrée par requête, le nombre moyen de tokens de sortie par requête, le nombre de requêtes prévu par jour et le niveau de modèle choisi.
Le calcul de base : (tokens d'entrée × prix d'entrée + tokens de sortie × prix de sortie) × requêtes par jour × 30 jours = coût mensuel.
Prenons une application qui traite 10 000 tokens d'entrée et génère 2 000 tokens de sortie par requête, avec 1 000 requêtes par jour sur Claude Sonnet 4.6 : (10 000 × 0,000003 $ + 2 000 × 0,000015 $) × 1 000 × 30 = 1 800 $ par mois.
En pratique, la plupart des projets sous-estiment d'un facteur 2 à 3 leur consommation réelle de tokens lors de la planification. Prévoyez une marge en conséquence.
Performance et prix
Le modèle le moins cher offre rarement le meilleur rapport qualité-prix. Selon une étude sur l'économie de l'inférence en IA, le « coût marginal » de l'inférence LLM varie fortement selon l'efficacité de calcul et l'architecture du modèle.
Des travaux sur l'approximation de requêtes à l'aide de modèles proxy légers montrent qu'un choix de modèle réfléchi peut diviser par 100 le coût et la latence. Dans ces études, les modèles proxy dépassent 90 % de précision tout en réduisant fortement les coûts pour certains types de requêtes.
Le déploiement local sur du matériel grand public est une autre option. Une étude sur l'efficacité des modèles de langage locaux montre qu'ils répondent correctement à 88,7 % des requêtes de conversation et de raisonnement en un seul tour, mais avec une latence nettement plus élevée qu'en centre de données.
Latence et coût
Les modèles plus rapides coûtent en général plus cher ou exigent un niveau de service premium. Une application soumise à des exigences de latence strictes devra parfois accepter un coût par token plus élevé pour respecter ses SLA.
La vitesse varie selon le modèle et le déploiement : les modèles phares produisent en général 20 à 40 tokens par seconde, les modèles de milieu de gamme 40 à 80 tokens par seconde, et les modèles optimisés peuvent dépasser 100 tokens par seconde sur une infrastructure dédiée.
Comparer les modèles avec soin et construire autour du bon
Comparer plus de 15 LLM sur le seul critère du prix donne rarement une image complète. Le coût réel dépend de la mise en œuvre : la qualité des données, la stratégie de fine-tuning et les choix d'infrastructure déterminent ce que vous payez dans la durée. AI Superior intervient sur tout le cycle de vie, de la préparation des données et du choix du modèle à l'entraînement, à l'optimisation et au déploiement. Nous aidons les équipes à choisir et à configurer leurs modèles en fonction de leurs cas d'usage réels, pas du seul prix affiché.
Concrètement, cela revient souvent à éviter des modèles surdimensionnés là où ils ne servent à rien, ou à combiner fine-tuning et configurations hybrides au lieu de dépendre d'un seul modèle ou d'une seule API. L'objectif est un système qui tourne efficacement en production, pas un bon score de benchmark. Si vous évaluez plusieurs LLM et voulez savoir ce qu'ils coûteront réellement à l'usage, mieux vaut revoir votre configuration tôt. Contactez AI Superior pour aligner le choix du modèle sur le coût réel, et non sur le seul prix catalogue.
Évolution des prix
Les tarifs des LLM évoluent vite. Plusieurs tendances nettes se sont dessinées en 2025 et début 2026.
Les fenêtres de contexte se sont fortement agrandies alors que le prix par token baissait. Claude Opus 4.6 et Sonnet 4.6 offrent tous deux une fenêtre d'un million de tokens au même prix que les modèles précédents limités à 200 000 tokens. La capacité de contexte a donc beaucoup augmenté sans hausse proportionnelle des coûts.
Les cycles de dépréciation se sont raccourcis. OpenAI a retiré les variantes GPT-4-32k 12 à 18 mois après leur sortie, signe d'itérations plus rapides. Les organisations doivent prévoir des migrations de modèles régulières et les coûts de développement qui vont avec.
L'écart entre modèles haut de gamme et milieu de gamme s'est réduit. Selon Anthropic, Claude Sonnet 4.6 approche le niveau d'Opus pour 60 % du coût. Pour les déploiements attentifs au budget, ce resserrement des performances entre niveaux de prix est une bonne nouvelle.
FAQ
Quel est le LLM le moins cher pour la production en 2026 ?
Parmi les grands fournisseurs, DeepSeek et Google Gemini ont les coûts par token les plus bas, mais le moins cher n'est pas toujours le plus rentable. Le coût total dépend de la précision exigée, des retraitements nécessaires et de la taille de contexte requise. Pour beaucoup d'applications, un modèle de milieu de gamme comme Claude Sonnet 4.6, à 3 $/15 $ par million de tokens, revient moins cher au final qu'un modèle à prix plancher dont les réponses sont de moindre qualité.
Combien fait réellement économiser la mise en cache des prompts ?
Chez OpenAI, les entrées en cache coûtent 50 % de moins sur les parties de prompt répétées. Pour une application avec des prompts système ou des documents de référence stables, cela représente une baisse de 30 à 50 % du coût total. Le gain est le plus net pour les applications qui envoient des milliers de requêtes similaires avec un contexte commun.
Faut-il auto-héberger ses LLM ou passer par des API ?
Selon les études sur l'économie du déploiement sur site, la rentabilité suppose un volume élevé et régulier ainsi qu'une infrastructure technique adaptée. En dessous de 100 millions de tokens par mois, les API sont en général plus économiques. Au-delà, l'auto-hébergement devient envisageable, mais il faut compter, en plus du calcul brut, les coûts DevOps, les mises à jour des modèles et la gestion de l'infrastructure.
Pourquoi les tokens de sortie coûtent-ils plus cher que les tokens d'entrée ?
La génération demande beaucoup plus de calcul que le traitement de l'entrée. Les tokens d'entrée traversent le modèle une seule fois pour l'encodage, alors que chaque token de sortie exige une passe complète pour prédire le token suivant. Cet écart de calcul, de l'ordre de 3 à 5 fois, se retrouve dans les grilles tarifaires de tous les fournisseurs.
Comment estimer la consommation de tokens de mon application ?
Utilisez les outils de tokenisation de chaque fournisseur pour mesurer des requêtes typiques. OpenAI, Anthropic et Google proposent tous des API ou des outils web de tokenisation. Faites vos tests sur des données représentatives, multipliez par le volume de requêtes prévu et ajoutez une marge de 50 % pour les variations. La plupart des estimations sous-évaluent la consommation réelle d'un facteur 2 à 3.
Que se passe-t-il quand j'atteins les limites de débit ?
Cela dépend du fournisseur et du niveau d'abonnement. Certaines implémentations mettent les requêtes en file d'attente, d'autres renvoient une erreur qui impose une logique de nouvelle tentative, et les niveaux premium peuvent basculer vers un autre modèle. Chez OpenAI, les utilisateurs payants de GPT-5.4 passent sur GPT-5.4 mini une fois les limites atteintes. La documentation de chaque fournisseur précise la gestion des limites par niveau.
Existe-t-il des remises sur volume pour les API LLM ?
La plupart des fournisseurs proposent des tarifs entreprise avec remises sur volume, mais les conditions ne sont pas publiques. Au-delà d'un milliard de tokens par mois, il vaut la peine de contacter directement les équipes commerciales. Les remises se situent en général entre 10 et 30 % selon l'engagement et les volumes. Anthropic, OpenAI et Google ont tous des programmes commerciaux pour les entreprises, avec des tarifs négociés.
Conclusion
La tarification des LLM reste complexe et change vite. En mars 2026, le coût par token allait de moins de 1 $ à 25 $ par million, selon le niveau du modèle et le type de token.
Un choix de modèle réfléchi est plus rentable que le simple choix du moins cher. Claude Sonnet 4.6, à 3 $/15 $ par million de tokens, offre des performances proches des modèles phares pour les tâches courantes. GPT-4.1 d'OpenAI, à 2 $/8 $, raisonne bien sur des tâches générales à un prix compétitif. Claude Opus 4.6 est plus cher (5 $/25 $) mais reste en tête pour le code complexe et les tâches agentiques.
Les coûts cachés comptent autant que le prix affiché. La mise en cache des prompts fait économiser 50 % sur les entrées répétées. Limiter les tokens de sortie évite l'explosion des coûts due aux réponses trop longues. Les architectures hiérarchiques réduisent le coût total de 60 % sans perte de qualité.
Calculez le coût total de possession, en incluant la gestion des limites de débit, les cycles de dépréciation des modèles et les retraitements liés à la qualité. Le prix par token le plus bas aboutit souvent au coût total le plus élevé.
Commencez par tester des charges de travail représentatives sur les modèles candidats. Mesurez la précision, mais aussi le nombre total de tokens consommés par tâche réussie. Tenez compte de vos volumes, de vos exigences de latence et de la taille de contexte nécessaire, puis décidez sur la base de la valeur réelle et pas du seul prix affiché.