Kurzzusammenfassung: Die LLM-Preise unterscheiden sich stark zwischen den Anbietern: Input-Token kosteten im März 2026 zwischen $0,10 und $5 pro Million, Output-Token zwischen $0,40 und $25 pro Million. Die GPT-Modelle von OpenAI, Claude von Anthropic und Gemini von Google dominieren den Markt mit unterschiedlichen Preis-Leistungs-Verhältnissen. Um die Kosten zu optimieren und gleichzeitig die Qualität zu sichern, ist es unerlässlich, die tokenbasierte Preisgestaltung, die Kontextfenster und die Nutzungsmuster zu verstehen.
Die explosionsartige Zunahme von APIs für große Sprachmodelle hat eine komplexe Preislandschaft geschaffen. Unternehmen stehen vor der wichtigen Entscheidung, welche Modelle den besten Nutzen für ihre spezifischen Anwendungsfälle bieten.
Doch eines ist wichtig: Bei der Modellwahl geht es nicht nur darum, die günstigste Option zu finden. Die Wirtschaftlichkeit der LLM-Inferenz hängt von mehreren Faktoren ab: Token-Preisen, Grenzen des Kontextfensters, Latenzanforderungen und versteckten Kosten, die Ihre Rechnung um das Zwei- bis Dreifache erhöhen können.
Dieser Vergleich analysiert die Preise führender Anbieter wie OpenAI, Anthropic, Google und neuerer Alternativen. Die Daten geben den Preisstand vom März 2026 wieder; die Anbieter passen ihre Preise jedoch regelmäßig an.
Tokenbasierte Preismodelle verstehen
LLM-Anbieter berechnen die Gebühren anhand der verarbeiteten Token. Ein Token entspricht etwa vier Zeichen Text oder ungefähr 0,75 Wörtern im Englischen. Beispielsweise wird die Zeichenkette „ChatGPT is great!“ in sechs Token kodiert: ["Chat", "G", "PT", " is", " great", "!"].
Die meisten Anbieter unterteilen die Preisgestaltung in zwei Komponenten: Input-Token (was Entwickler an das Modell senden) und Output-Token (was das Modell generiert). Output-Token kosten in der Regel das 3- bis 5-Fache der Input-Token, da ihre Generierung mehr Rechenressourcen erfordert.
Die Gesamtzahl der Token in einem API-Aufruf beeinflusst drei entscheidende Faktoren: die Kosten des Aufrufs, die Dauer der Ausführung und ob er in das Kontextfenster des Modells passt.
Kontextfenster und Caching
Kontextfenster definieren die maximale Anzahl an Token, die ein Modell in einer einzelnen Anfrage verarbeiten kann. Bis Anfang 2026 sind die Kontextfenster deutlich gewachsen. Claude Opus 4.6 von Anthropic bietet in der Beta ein Kontextfenster von 1 Million Token, während die meisten produktiv eingesetzten Modelle 128.000 bis 200.000 Token verarbeiten.
Größere Kontextfenster ermöglichen komplexere Anwendungen, erhöhen aber die Kosten proportional. Eine Eingabe von 100.000 Token zu $3 pro Million Token kostet $0,30 pro Anfrage – multipliziert man dies mit Tausenden von täglichen Anfragen, steigen die Kosten schnell an.
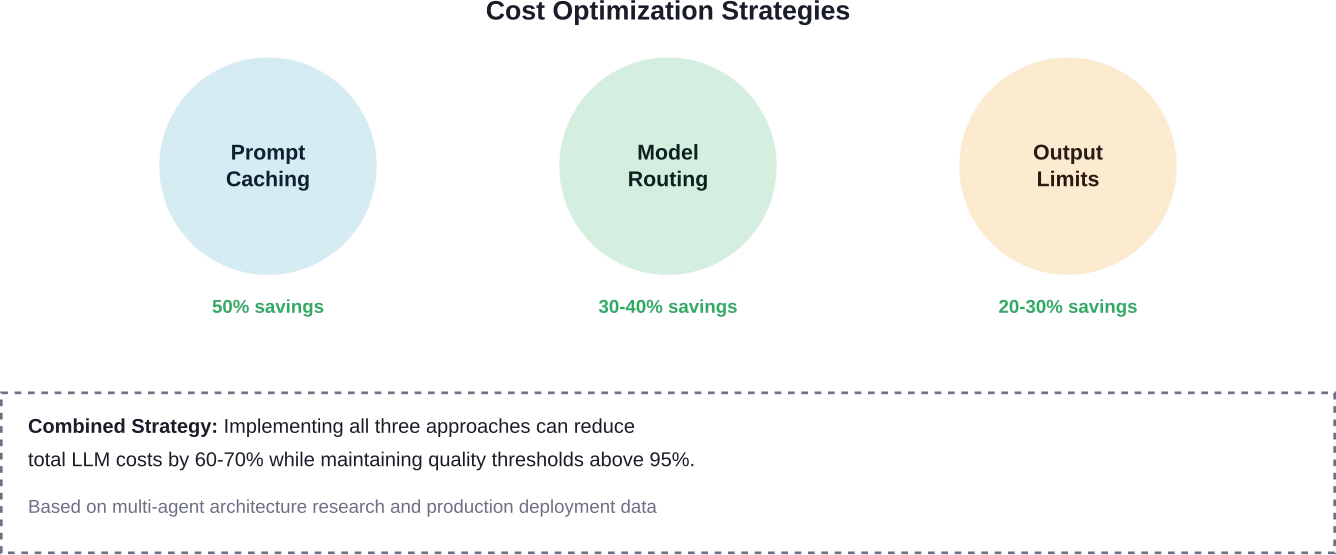
Prompt-Caching ermöglicht erhebliche Einsparungen. OpenAI berechnet für zwischengespeicherte Eingaben 50 % des Standard-Input-Preises. Laut der Preisdokumentation von OpenAI kostet GPT-4.1 $2,00 pro Million Input-Token, aber nur $0,50 pro Million zwischengespeicherter Input-Token.
Aufschlüsselung der Preise der wichtigsten Anbieter
Der Markt umfasst drei dominante Anbieter und mehrere aufstrebende Alternativen. Jeder Anbieter bietet verschiedene Modellstufen an, die für unterschiedliche Anwendungsfälle optimiert sind.
OpenAI-Preisstruktur
Die GPT-Modelle von OpenAI decken verschiedene Intelligenz- und Kostenstufen ab. Wie in Community-Diskussionen vom Januar 2026 dargelegt, entwickeln sich die Preise mit der Einführung neuer Modelle stetig weiter.
| Modell | Input (pro 1 Mio. Token) | Gecachter Input (pro 1 Mio.) | Output (pro 1 Mio. Token) | Kontextfenster |
|---|---|---|---|---|
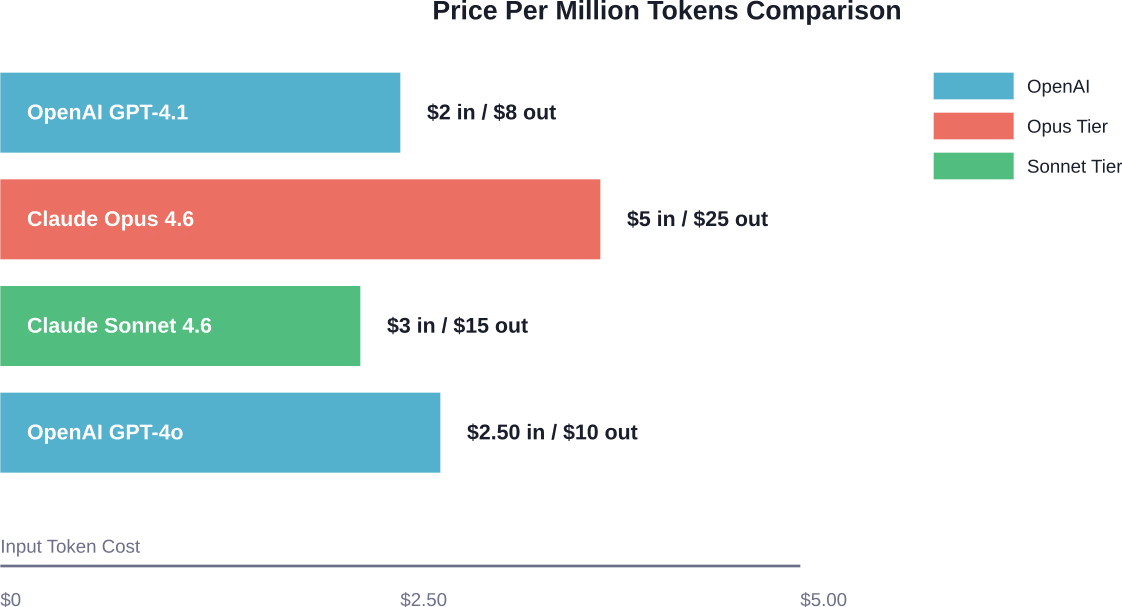
| GPT-4.1 | $2,00 | $0,50 | $8,00 | 128K |
| GPT-4o | $2,50 | $1,25 | $10,00 | 128K |
| GPT-4-32k (eingestellt) | $60,00 | k. A. | $120,00 | 32K |
OpenAI hat die GPT-4-32k-Modelle abgekündigt; die Abschaltung war für den 6. Juni 2025 angesetzt. Laut der Abkündigungsdokumentation von OpenAI hatten bestehende Benutzer nur begrenzt Zeit, auf neuere Modelle wie GPT-4o umzusteigen.
Die GPT-5.4-Modellfamilie stellt die neueste Entwicklung von OpenAI dar. GPT-5.4 mini wurde im März 2026 veröffentlicht und ist für Free- und Go-Nutzer über die Funktion „Thinking“ von ChatGPT verfügbar. Für zahlende Nutzer dient GPT-5.4 mini als Fallback, wenn die Rate Limits von GPT-5.4 Thinking erreicht sind.
Preise von Anthropic Claude
Die Claude-Modelle von Anthropic haben sich als starke Konkurrenten von OpenAI etabliert, insbesondere bei Programmier- und Agentic-Aufgaben. Das Unternehmen veröffentlichte Claude Opus 4.6 im Februar 2026 und Claude Sonnet 4.6 kurz darauf.
Claude Opus 4.6 behält trotz deutlich verbesserter Fähigkeiten den Preis von $5 pro Million Input-Token und $25 pro Million Output-Token bei. Laut der Ankündigung von Anthropic bleibt diese Preisgestaltung gegenüber der Vorgängerversion Opus 4.5 unverändert.
Claude Sonnet 4.6 bietet mit $3 pro Million Input-Token und $15 pro Million Output-Token günstigere Preise, also denselben Preis wie Sonnet 4.5. Anthropic beschreibt Sonnet 4.6 als nahezu so intelligent wie Opus, jedoch zu einem praktischeren Preis für alltägliche Aufgaben.
| Modell | Input (pro 1 Mio. Token) | Output (pro 1 Mio. Token) | Kontextfenster | Am besten geeignet für |
|---|---|---|---|---|
| Claude Opus 4.6 | $5,00 | $25,00 | 1M (Beta) | Komplexes Reasoning, Programmierung, Agenten |
| Claude Sonnet 4.6 | $3,00 | $15,00 | 1M (Beta) | Ausgewogenes Verhältnis von Leistung und Kosten |
| Claude Opus 4.5 | $5,00 | $25,00 | 200K | Legacy-Anwendungen |
Das 1-Millionen-Token-Kontextfenster in Claude Opus 4.6 ist ein Novum für die Modelle der Opus-Klasse von Anthropic. Diese Erweiterung ermöglicht die Verarbeitung ganzer Codebasen oder umfangreicher Dokumente in einzelnen Anfragen.
Preise von Google Gemini
Googles Gemini-Modelle konkurrieren aggressiv über den Preis, insbesondere bei Anwendungen mit hohem Volumen. Die Gemini-Familie umfasst mehrere Stufen, die für unterschiedliche Leistungsanforderungen optimiert sind.
Die Preisstrukturen für Gemini-Modelle variieren je nach Tarif und Nutzungsvolumen erheblich. Google positioniert Gemini als kostengünstige Alternative für Anwendungen, die hohe Leistung ohne Premiumpreise benötigen.
Versteckte Kosten und Preismechanismen
Der angegebene Preis pro Token erzählt nur einen Teil der Geschichte. Mehrere versteckte Faktoren können die tatsächlichen Kosten drastisch erhöhen.
Output-Token als Kostentreiber
Output-Token sind bei allen Anbietern durchweg 3- bis 5-mal so teuer wie Input-Token. Eine Anwendung, die lange Antworten generiert, hat unverhältnismäßig höhere Kosten als eine, die große Eingaben verarbeitet, aber kurze Ausgaben erzeugt.
Die Begrenzung der Output-Token (Parameter max_tokens) hilft, die Kosten zu kontrollieren. Ist der Wert zu niedrig, werden Antworten vor Abschluss abgeschnitten. Ist er zu hoch, kann das Modell unnötige Inhalte generieren, insbesondere bei höheren Temperatureinstellungen, die Kreativität fördern.
Rate Limits und Fallback-Kosten
Die meisten Anbieter setzen Rate Limits auf Basis von Anfragen pro Minute, Token pro Minute oder beidem ein. Wenn Anwendungen diese Grenzwerte erreichen, schlagen sie entweder fehl oder greifen auf alternative Modelle zurück.
Die GPT-5.4-Implementierung von OpenAI veranschaulicht dieses Muster. Laut den Release Notes von OpenAI vom März 2026 erhalten zahlende Nutzer GPT-5.4 mini als Fallback, sobald die Rate Limits von GPT-5.4 Thinking erreicht sind. Das sichert die Verfügbarkeit, möglicherweise aber zu anderen Kostenstrukturen.
Wirtschaftlichkeit des Kontextfensters
Größere Kontextfenster ermöglichen komplexere Anwendungen, erhöhen aber die Kosten linear. Bei einer Kontextlänge von 128K Token erreicht der KV-Cache von Llama2-7B in halber Präzision 64 GB, berechnet als: num_layers × num_kv_head × head_dim × seqlen × sizeof(fp16) × 2.
Untersuchungen zur Effizienz der LLM-Dekodierung zeigen, dass die Größe des KV-Caches linear mit der Sequenzlänge wächst, was während der Dekodierung zu Speicherengpässen führt, die wiederum höhere Betriebskosten nach sich ziehen.
Überlegungen zur Preisgestaltung für Unternehmen
Für Deployments in Unternehmen gelten andere wirtschaftliche Rahmenbedingungen als bei einzelnen Entwicklern oder kleinen Teams. Mengenrabatte, individuelle Preisgestaltung und Bereitstellungsoptionen beeinflussen die Gesamtbetriebskosten erheblich.
Cloud-API vs. Self-Hosting
Organisationen können kommerzielle LLM-Dienste abonnieren oder Modelle auf ihrer eigenen Infrastruktur betreiben. Eine auf arXiv veröffentlichte Studie zum On-Premise-Betrieb von LLMs kam zu dem Ergebnis, dass die Frage, ab wann sich der Eigenbetrieb gegenüber kommerziellen Diensten rechnet, eine sorgfältige Analyse der Nutzungsmuster und Infrastrukturkosten erfordert.
Die Studie definierte vier Kriterien für die Modellauswahl: eine Leistung, die höchstens 20 % hinter führenden kommerziellen Modellen liegt, betriebliche Kompatibilität, Sicherheitsanforderungen und Kosteneffizienz im großen Maßstab. Bei Anwendungen mit hohem Datenvolumen kann Self-Hosting die Kosten senken, die anfänglichen Investitionen in die Infrastruktur bleiben jedoch beträchtlich.
Kostenoptimierung hierarchischer Architekturen
Aktuelle Benchmark-Studien zu Multi-Agenten-LLM-Architekturen für die Finanzdokumentenverarbeitung haben gezeigt, dass hierarchische Architekturen das beste Kosten-Genauigkeits-Verhältnis bieten. Diese Systeme erreichten 97,7 % der Genauigkeit reflexiver Architekturen bei 60,9 % der Kosten.
Die Forschung hat gezeigt, dass semantisches Caching, Modellrouting und adaptive Verarbeitung die Betriebskosten deutlich senken können, ohne die Qualität zu beeinträchtigen. Diese Techniken gewinnen zunehmend an Bedeutung, wenn Anwendungen Millionen von Anfragen pro Tag verarbeiten.
Neue Alternativen und regionale Preise
Neben den drei großen Anbietern bieten mehrere Alternativen wettbewerbsfähige Preise für bestimmte Anwendungsfälle.
DeepSeek und Open-Source-Modelle
DeepSeek hat durch aggressive Preisgestaltung bei leistungsstarken Modellen Aufmerksamkeit erregt. Das Unternehmen positioniert sich als kostengünstige Alternative für Anwendungen, die keine absolute Spitzenleistung erfordern.
Open-Source-Modelle, die über Cloud-GPU-Anbieter wie RunPod bereitgestellt werden, bieten eine weitere Möglichkeit. Diese Dienste berechnen die Kosten pro GPU-Stunde anstatt pro Token, wodurch die Kosten bei Anwendungen mit hohem Volumen besser planbar werden.
Anbieter spezialisierter Modelle
Mistral, die Llama-Familie von Meta und die Modelle von NVIDIA bedienen jeweils spezifische Nischen. Laut einer im August 2025 veröffentlichten Modellvergleichsanalyse sollten bei der Modellauswahl neben dem Preis auch der Verwendungszweck, die technischen Spezifikationen und die optimalen Anwendungsfälle berücksichtigt werden.
Die Analyse unterstreicht, dass unterschiedliche Modelle für unterschiedliche Aufgaben hervorragend geeignet sind. Die Auswahl allein aufgrund der niedrigsten Kosten führt oft zu schlechten Ergebnissen und teurer Nachbearbeitung.
Praktisches Schema zur Kostenberechnung
Um die tatsächlichen Kosten abzuschätzen, ist es notwendig, die anwendungsspezifischen Nutzungsmuster zu verstehen. Die vier entscheidenden Parameter sind: durchschnittliche Input-Token pro Anfrage, durchschnittliche Output-Token pro Anfrage, erwartete Anfragen pro Tag und die gewählte Modellstufe.
Eine einfache Berechnung: (Input-Token × Input-Preis + Output-Token × Output-Preis) × tägliche Anfragen × 30 Tage = monatliche Kosten.
Beispiel: Eine Anwendung verarbeitet pro Anfrage 10.000 Input-Token, erzeugt 2.000 Output-Token und führt täglich 1.000 Anfragen mit Claude Sonnet 4.6 aus: (10.000 × $0,000003 + 2.000 × $0,000015) × 1.000 × 30 = $1.800 pro Monat.
Mal ehrlich: Die meisten Anwendungen unterschätzen den tatsächlichen Tokenverbrauch in der Planungsphase um das Zwei- bis Dreifache. Planen Sie deshalb einen entsprechenden Puffer ein.
Leistung vs. Preis
Das günstigste Modell bietet selten das beste Preis-Leistungs-Verhältnis. Laut einer Studie zur Ökonomie der KI-Inferenz variieren die Grenzkosten der LLM-Inferenz erheblich in Abhängigkeit von der Recheneffizienz und der Modellarchitektur.
Studien zur Approximation von Abfragen mit leichtgewichtigen Proxy-Modellen zeigten, dass eine strategische Modellauswahl eine Kosten- und Latenzreduzierung um das Hundertfache ermöglicht. Die Forschung ergab, dass Proxy-Modelle eine Genauigkeit von über 90 % erreichen und gleichzeitig die Kosten für bestimmte Abfragetypen drastisch senken.
Der lokale Betrieb auf Consumer-Hardware ist eine weitere Option. Untersuchungen zur Effizienz lokaler Sprachmodelle ergaben, dass lokale LMs 88,7 % der Single-Turn-Chat- und Reasoning-Anfragen korrekt beantworten können, allerdings mit deutlichen Latenznachteilen gegenüber dem Betrieb im Rechenzentrum.
Abwägung von Latenz und Kosten
Schnellere Modelle sind in der Regel teurer oder erfordern Premium-Tarife. Anwendungen mit strengen Latenzanforderungen müssen unter Umständen höhere Kosten pro Token in Kauf nehmen, um die Leistungs-SLAs zu erfüllen.
Die Latenzerwartungen variieren je nach Modell und Bereitstellung: Flaggschiffmodelle erreichen typischerweise 20–40 Token/Sekunde, Modelle der Mittelklasse 40–80 Token/Sekunde und optimierte Modelle können auf dedizierter Infrastruktur 100 Token/Sekunde überschreiten.
Modelle sorgfältig vergleichen und auf das richtige setzen
Ein Preisvergleich von mehr als 15 LLMs allein liefert selten ein vollständiges Bild. Die tatsächlichen Kosten entstehen durch die Implementierung der Modelle – Datenqualität, Fine-Tuning-Strategie und Infrastrukturentscheidungen bestimmen, was Sie langfristig tatsächlich zahlen. AI Superior arbeitet über den gesamten Lebenszyklus hinweg, von der Datenaufbereitung und Modellauswahl bis hin zu Training, Optimierung und Bereitstellung, und hilft Teams dabei, Modelle auf der Grundlage realer Anwendungsfälle und nicht auf der Grundlage oberflächlicher Preisinformationen auszuwählen und zu konfigurieren.
In der Praxis bedeutet dies oft, überdimensionierte Modelle zu vermeiden, wo sie nicht benötigt werden, oder Ansätze wie Fine-Tuning und hybride Setups zu kombinieren, anstatt sich auf ein einzelnes Modell oder eine API zu verlassen. Der Fokus liegt auf dem Aufbau von Systemen, die im Produktivbetrieb effizient laufen, nicht nur auf dem Vergleich von Benchmarks. Wenn Sie mehrere LLMs evaluieren und deren tatsächliche Kosten im Einsatz ermitteln möchten, ist es sinnvoll, Ihre Konfiguration frühzeitig zu überprüfen. Wenden Sie sich an AI Superior, um die Modellwahl an den tatsächlichen Kosten auszurichten, nicht nur an den Listenpreisen.
Zukünftige Preistrends
Die LLM-Preise entwickeln sich weiterhin rasant. Im Laufe des Jahres 2025 und bis ins Jahr 2026 zeichneten sich mehrere klare Trends ab.
Die Kontextfenster wuchsen deutlich, während die Preise pro Token sanken. Claude Opus 4.6 und Sonnet 4.6 bieten beide Kontextfenster mit 1 Million Token zum gleichen Preis wie die Vorgängermodelle mit 200.000 Token. Dies bedeutet eine signifikante Steigerung der Kontextfensterkapazität ohne proportionale Kostensteigerungen.
Die Abkündigungszyklen von Modellen wurden kürzer. OpenAIs Entscheidung, GPT-4-32k-Varianten innerhalb von 12 bis 18 Monaten nach Veröffentlichung abzukündigen, deutet auf schnellere Iterationszyklen hin. Unternehmen müssen regelmäßige Modellmigrationen und die damit verbundenen Entwicklungskosten einplanen.
Die Kluft zwischen Flaggschiff- und Mittelklassemodellen verringerte sich. Laut den Ankündigungen von Anthropic kommt Claude Sonnet 4.6 an die Intelligenz von Opus heran, und das zu 60 % der Kosten. Diese Annäherung der Fähigkeiten über die Preisstufen hinweg ist vorteilhaft für kostenbewusste Anwender.
Häufig gestellte Fragen
Welches LLM ist 2026 für den Produktiveinsatz am günstigsten?
DeepSeek und Google Gemini bieten die niedrigsten Kosten pro Token unter den großen Anbietern, aber „am günstigsten“ bedeutet nicht immer das beste Preis-Leistungs-Verhältnis. Die Gesamtkosten hängen von den Genauigkeitsanforderungen, dem Nachbearbeitungsaufwand und den Anforderungen an das Kontextfenster ab. Für viele Anwendungen bieten Modelle der mittleren Preisklasse wie Claude Sonnet 4.6 mit $3/$15 pro Million Token eine insgesamt bessere Wirtschaftlichkeit als extrem niedrige Preise bei geringerer Ausgabequalität.
Wie viel spart Prompt-Caching tatsächlich?
Die Preisgestaltung von OpenAI für zwischengespeicherte Eingaben spart 50 % bei wiederholten Prompt-Abschnitten. Bei Anwendungen mit gleichbleibenden System-Prompts oder Referenzdokumenten entspricht das einer Senkung der Gesamtkosten um 30–50 %. Die Einsparungen sind besonders hoch bei Anwendungen, die Tausende ähnlicher Anfragen mit gemeinsamem Kontext stellen.
Sollten Unternehmen LLMs selbst hosten oder APIs nutzen?
Untersuchungen zur Wirtschaftlichkeit von On-Premise-Bereitstellungen legen nahe, dass sich der Eigenbetrieb erst bei konstant hohem Nutzungsvolumen und passender technischer Infrastruktur rechnet. Anwendungen, die monatlich weniger als 100 Millionen Token verarbeiten, fahren mit API-Preisen in der Regel günstiger. Oberhalb dieser Schwelle wird Self-Hosting wirtschaftlich interessant, jedoch müssen neben den reinen Rechenkosten auch DevOps-Aufwand, Modellaktualisierungen und Kosten für das Infrastrukturmanagement berücksichtigt werden.
Warum sind Output-Token teurer als Input-Token?
Die Generierung erfordert deutlich mehr Rechenressourcen als die Verarbeitung. Input-Token durchlaufen das Modell zur Kodierung einmal, während für jedes Output-Token ein vollständiger Forward Pass zur Vorhersage des nächsten Tokens notwendig ist. Daraus ergibt sich ein 3- bis 5-facher Unterschied im Rechenaufwand, der sich in den Preisstrukturen aller Anbieter widerspiegelt.
Wie schätze ich den Tokenverbrauch für meine Anwendung ab?
Nutzen Sie die Tokenisierungstools der jeweiligen Modellanbieter, um typische Anfragen zu messen. OpenAI, Anthropic und Google bieten Tokenisierungs-APIs oder Webtools an. Testen Sie mit repräsentativen Beispieldaten, multiplizieren Sie diese mit dem erwarteten Anfragevolumen und fügen Sie einen Puffer von 50 % für Schwankungen hinzu. Die meisten Planungsschätzungen unterschätzen die tatsächliche Nutzung um das Zwei- bis Dreifache.
Was passiert, wenn ich Rate Limits erreiche?
Das hängt vom Anbieter und vom Tarif ab. Einige Implementierungen stellen Anfragen in eine Warteschlange, andere geben Fehler aufgrund von Ratenlimits zurück, die eine Wiederholungslogik erfordern, und Premium-Tarife greifen möglicherweise auf alternative Modelle zurück. OpenAIs GPT-5.4 verwendet für zahlende Nutzer GPT-5.4 mini, sobald die Ratenlimits erreicht sind. Informationen zur tarifspezifischen Handhabung von Ratenlimits finden Sie in der Dokumentation Ihres Anbieters.
Gibt es Mengenrabatte für LLM-APIs?
Die meisten Anbieter bieten Unternehmenspreise mit Mengenrabatten an, die genauen Konditionen sind jedoch nicht öffentlich einsehbar. Organisationen, die monatlich mehr als 1 Milliarde Token verarbeiten, sollten sich direkt an die Vertriebsteams wenden. Die Rabatte liegen üblicherweise zwischen 10 und 30 %, abhängig von der zugesagten Abnahmemenge und dem Nutzungsvolumen. Anthropic, OpenAI und Google bieten alle spezielle Vertriebsprogramme für Unternehmen mit individuellen Preisen an.
Fazit
Die LLM-Preislandschaft bleibt komplex und verändert sich schnell. Stand März 2026 liegen die Kosten je nach Modellstufe und Token-Typ zwischen unter $1 und $25 pro Million Token.
Wirtschaftlich zahlt sich eine strategische Modellauswahl mehr aus als die Wahl der billigsten Option. Claude Sonnet 4.6 bietet mit $3/$15 pro Million Token bei alltäglichen Aufgaben nahezu Flaggschiff-Leistung. GPT-4.1 von OpenAI liefert mit $2/$8 starkes allgemeines Reasoning zu wettbewerbsfähigen Preisen. Claude Opus 4.6 ist mit $5/$25 zwar teurer, führt aber bei komplexen Programmier- und agentenbasierten Aufgaben.
Versteckte Kosten sind genauso wichtig wie der Listenpreis. Prompt-Caching spart 50 % bei wiederholten Eingaben. Ein gezieltes Management der Output-Token verhindert Kostenexplosionen durch ausschweifende Antworten. Hierarchische Architekturen senken die Gesamtkosten bei gleichbleibender Qualität um 60 %.
Organisationen sollten die Gesamtbetriebskosten inklusive Umgang mit Rate Limits, Abkündigungszyklen von Modellen und qualitätsbedingter Nachbearbeitung berechnen. Der niedrigste Preis pro Token führt oft zu den höchsten Gesamtkosten.
Beginnen Sie mit einem Benchmarking repräsentativer Workloads für verschiedene Kandidatenmodelle. Messen Sie dabei nicht nur die Genauigkeit, sondern auch die Anzahl der verbrauchten Token pro erfolgreich abgeschlossener Aufgabe. Berücksichtigen Sie spezifische Nutzungsmuster, Latenzanforderungen und den Bedarf an Kontextfenstern. Treffen Sie anschließend eine fundierte Entscheidung, die auf dem tatsächlichen Wert und nicht nur auf dem Preis basiert.