Resumen rápido: Los costos de las API de LLM de Google varían considerablemente entre los modelos de Vertex AI. En marzo de 2026, Gemini 3.1 Flash-Lite parte de $0.25 por millón de tokens de entrada (hasta 200K tokens) y $0.25 por millón por encima de 200K tokens, mientras que Gemini 3.1 Pro va de $2 a $12 por millón de tokens según el tamaño del contexto. El precio depende del tipo de modelo, el volumen de tokens, el uso de caché y las funciones de grounding, y el procesamiento por lotes ofrece un descuento del 50 %.
El precio de las API de LLM de Google se ha convertido en un factor decisivo para los desarrolladores y las empresas que crean aplicaciones de IA. Con la ampliación de la familia de modelos Gemini de Vertex AI a principios de 2026, comprender la estructura de costos ya no es opcional.
¿El problema? El modelo de precios de Google depende de varias variables: el número de tokens, el tamaño de la ventana de contexto, el estado de la caché y si las solicitudes se procesan por lotes o en tiempo real. Una sola llamada a la API puede costar desde fracciones de centavo hasta varios dólares, según la configuración.
Así son los costos reales en este momento.
Cómo se estructuran los precios de las API de LLM de Google
Google cobra el uso de las API de LLM a través de Vertex AI por token. Pero ahí termina la simplicidad.
Según la página oficial de precios de Vertex AI, los costos se dividen en tokens de entrada (lo que los desarrolladores envían al modelo) y tokens de salida (lo que el modelo genera). Con esta doble tarifa, un prompt de 1000 palabras con una respuesta de 500 palabras se factura dos veces: una por la lectura y otra por la escritura.
Un token es un fragmento de texto, normalmente de 3 a 4 caracteres en inglés. La expresión «artificial intelligence» se divide en unos 4 tokens. Así, un documento empresarial típico de 500 palabras equivale aproximadamente a entre 650 y 750 tokens.
Hablando claro: la mayoría de los desarrolladores subestiman el consumo de tokens entre un 30 y un 40 % al planificar sus presupuestos. Esa diferencia se amplía de forma drástica con entradas multimodales como imágenes o video.
Qué se considera una solicitud facturable
Google cobra todos los tokens procesados en las solicitudes correctas (200 OK). Sin embargo, algunos errores 4xx (como el 429 Too Many Requests) no generan costos, mientras que otros relacionados con el filtrado de contenido durante la generación pueden dar lugar a cargos por los tokens de entrada.
Esto importa más de lo que parece. En las fases de prueba, cuando las tasas de error pueden llegar al 15-20 %, esa protección supone un ahorro considerable.
Desglose de precios de los modelos Gemini 3.1
La familia Gemini 3.1 abarca varios modelos con precios muy distintos. Esta es la estructura vigente en marzo de 2026.
| Modelo | Entrada ≤200K tokens | Salida ≤200K tokens | Entrada >200K tokens | Salida >200K tokens |
|---|---|---|---|---|
| Gemini 3.1 Pro Preview | $2 por 1M | $12 por 1M | $4 por 1M | $18 por 1M |
| Gemini 3.1 Flash Image Preview | $0.50 de entrada, $3 de salida por 1M | Imagen: $60 por 1M | N/D | N/D |
| Gemini 3 Standard | $3 por 1M | $15 por 1M | Se aplican tarifas más altas | Se aplican tarifas más altas |
El precio sube de nivel cuando el contexto de entrada supera los 200 000 tokens. A partir de ese umbral, Google cobra todos los tokens, tanto de entrada como de salida, a la tarifa de contexto largo. En Gemini 3.1 Pro, eso supone un aumento del 100 % en el costo de entrada (de $2 a $4) y del 50 % en el de salida (de $12 a $18).
Los modelos Flash están pensados para aplicaciones sensibles al costo. A la mitad del precio de los modelos Pro, sacrifican algo de profundidad de razonamiento a cambio de velocidad y economía. Para tareas sencillas de clasificación, resumen o extracción, Flash ofrece el 90 % de la calidad de Pro al 25 % del costo.
La ventaja del precio de la entrada en caché
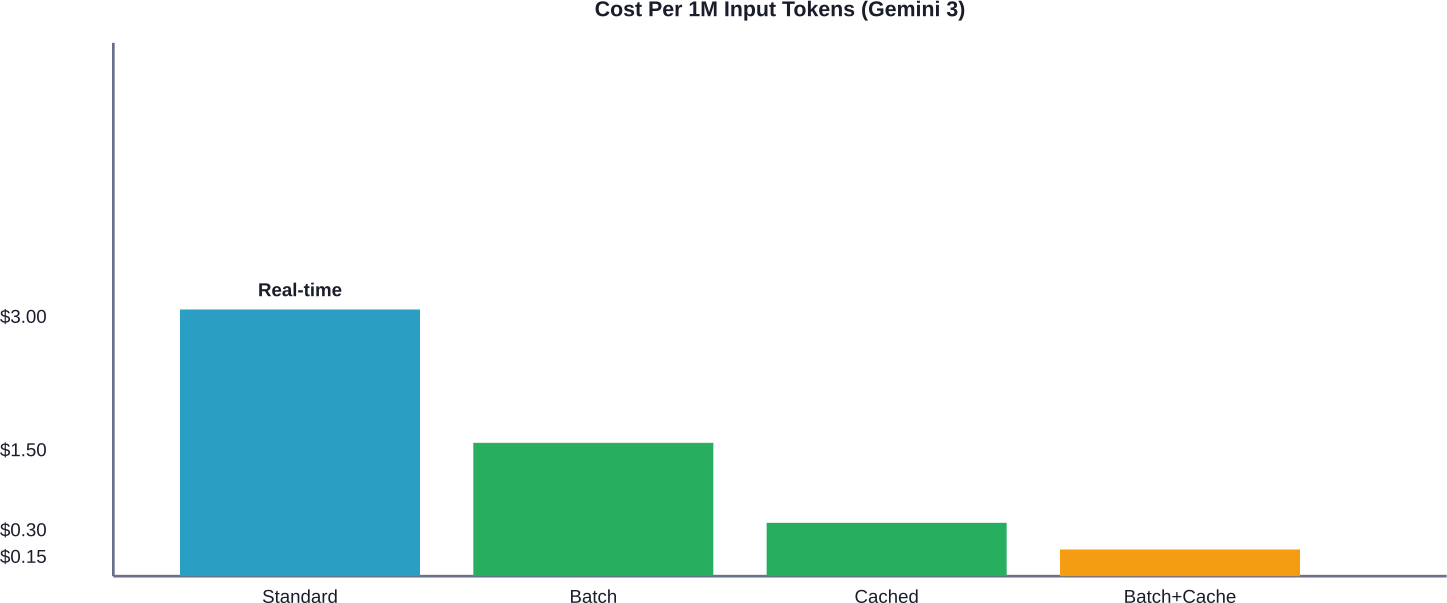
La caché es donde los desarrolladores más hábiles recortan costos de forma drástica. Cuando el mismo contexto aparece en varias solicitudes (por ejemplo, un catálogo de productos, un conjunto de documentación o una base de conocimiento), almacenarlo en caché reduce el costo de la entrada repetida en un 90 %.
En Gemini 3.1 Pro, los tokens de entrada en caché cuestan $0.20 por millón en lugar de $2 (hasta 200K tokens) o $0.40 por millón (por encima de 200K tokens).
Las cuentas salen rápido. Si una base de conocimiento de 50 000 tokens se consulta 100 veces al día, la caché ahorra unos $9 diarios frente a enviar el contexto completo cada vez. Son $270 al mes gracias a una sola optimización.
Procesamiento por lotes frente a tiempo real
Las solicitudes por lotes reducen los costos a la mitad. Según la documentación oficial de Vertex AI, la entrada por lotes de Gemini 3 Standard cuesta $1.50 por millón de tokens, frente a $3 en tiempo real (sin lotes). La salida por lotes cuesta $7.50 por millón, frente a $15 en tiempo real.
¿La contrapartida? La latencia. Los trabajos por lotes se procesan de forma asíncrona, con tiempos de finalización que van de minutos a horas. Para el procesamiento nocturno de datos, el análisis de documentos o la generación masiva de contenido, ese retraso es irrelevante. Para chatbots o herramientas interactivas, lo descarta por completo.
Las operaciones de caché por lotes tienen descuentos similares. Las escrituras en caché bajan a $1.875 por millón de tokens y los aciertos de caché, a $0.15. Para cargas de trabajo de gran volumen que no requieren respuestas inmediatas, el procesamiento por lotes con caché es la estructura de costos más baja disponible.
Precios de grounding y herramientas
Gemini 2.5 Pro incluye 10 000 prompts con grounding al día sin costo adicional. Por encima de ese límite, Google cobra $35 por cada 1000 prompts con grounding.
Un prompt con grounding significa que el modelo consulta la Búsqueda de Google durante la generación. Para lograr precisión factual en resúmenes de noticias, apoyo a la investigación o consultas de datos en tiempo real, el grounding resulta muy valioso. Pero el costo se acumula.
A $35 por cada 1000 solicitudes con grounding, los escenarios de uso intensivo generan cargos rápidamente. Una aplicación que realiza 50 000 solicitudes con grounding al mes paga $1750 solo por el grounding, antes del costo de los tokens. La asignación diaria gratuita cubre 300 000 solicitudes mensuales en las cuentas que cumplen los requisitos, lo que basta para la mayoría de los despliegues pequeños y medianos.
Web Grounding for Enterprise tiene una tarifa más alta: $45 por cada 1000 prompts con grounding. Este nivel premium ofrece capacidades de búsqueda mejoradas y fuentes de datos empresariales. Las organizaciones que necesiten esta función deberían contactar con el equipo de cuentas de Google Cloud para consultar posibles descuentos por volumen.
Comparación de los costos de los LLM de Google con la competencia
¿Cómo se comparan las tarifas de Google con las de OpenAI y Anthropic?
En marzo de 2026, GPT-5.2 Pro de OpenAI cuesta $21 por millón de tokens de entrada y $168 por millón de tokens de salida, unas 10 veces más que Gemini 3.1 Pro de Google. Claude Sonnet 4.5 de Anthropic cuesta $3 por millón de tokens de entrada y $15 por millón de salida, prácticamente lo mismo que Gemini 3 Standard.
Pero aquí la cosa se pone interesante. DeepSeek V3.2 rebaja a todos con $0.28 por millón de tokens de entrada. Para aplicaciones con presupuesto ajustado, los proveedores chinos han fijado un nuevo precio mínimo que a los proveedores occidentales les cuesta igualar.
| Proveedor | Modelo | Entrada (por 1M de tokens) | Salida (por 1M de tokens) |
|---|---|---|---|
| Gemini 3.1 Pro | $2.00 | $12.00 | |
| Gemini 3.1 Flash-Lite | $0.25 | Tarifas estándar | |
| OpenAI | GPT-5.2 Pro | $21.00 | $168.00 |
| Anthropic | Claude Sonnet 4.5 | $3.00 | $15.00 |
| DeepSeek | V3.2-Exp | $0.28 | $0.40 |
El rendimiento importa tanto como el precio. Algunas discusiones de la comunidad indican que el precio ultrabajo de DeepSeek podría implicar concesiones de calidad en determinadas tareas de razonamiento complejo. Gemini 3.1 Pro de Google y los modelos Claude de Anthropic ofrecen un rendimiento superior en benchmarks como MMLU y HellaSwag.
El cálculo del valor depende por completo del caso de uso. Para el análisis de documentos jurídicos de alto riesgo, tiene sentido pagar 10 veces más por la precisión de GPT-5.2 Pro. Para clasificar tickets de atención al cliente, Gemini Flash o DeepSeek ofrecen una calidad suficiente por una fracción del costo.
Costos ocultos y cargos de infraestructura
El precio por token solo cuenta una parte de la historia. La infraestructura de Vertex AI añade costos que muchos desarrolladores pasan por alto en la planificación inicial.
El almacenamiento de datos para aplicaciones RAG con Vertex AI RAG Engine se factura aparte. Los precios de Vertex AI Search siguen un modelo configurable con suscripciones mensuales para la capacidad de consulta (QPM) y el almacenamiento. En el caso de los sitios web, el almacenamiento se calcula como 500 kilobytes por el número de páginas: un sitio de 1000 páginas cuesta $2.38 al mes solo por la indexación de datos.
Las bases de datos vectoriales, ya sean los servicios gestionados de Vertex AI o soluciones de terceros como Pinecot o Weaviate, añaden costos de almacenamiento por GB y de consulta. Un despliegue RAG empresarial típico con 50 GB de embeddings puede generar entre $50 y $150 al mes en almacenamiento vectorial, al margen de los costos del LLM.
Tarifas de transferencia y salida de datos
Acceder desde Vertex AI a Cloud Storage, Google Drive y otras fuentes de datos no tiene costo, pero sí se aplican cargos por salida de datos (egress). Sacar datos de las regiones de Google Cloud genera tarifas de ancho de banda de entre $0.08 y $0.23 por GB, según el destino.
En aplicaciones que procesan archivos multimedia grandes o colecciones extensas de documentos, el egress puede sumar entre un 10 y un 20 % al costo total. Un pipeline de procesamiento de video que maneja 1 TB al mes paga entre $80 y $230 solo en ancho de banda.
Estrategias de optimización de costos que funcionan
La diferencia entre una implementación básica y un despliegue optimizado puede alcanzar el 70 % del gasto total. Esto es lo que realmente marca la diferencia.
Aplique una caché de contexto agresiva
Más allá de la caché básica, una estrategia de caché en varios niveles reduce aún más los costos. Guarde los contextos de acceso frecuente en la caché nativa de Vertex AI. Para contextos menos habituales pero que se repiten, mantenga una capa de Redis o Memcached que reconstruya los prompts a partir de plantillas.
Un ejemplo muestra que implantar un sistema de caché de dos niveles en un bot de atención al cliente que consulta un catálogo de productos de 30 000 tokens puede reducir los costos de unos $2400 a $720 al mes.
Comprima los prompts sin sacrificar calidad
La ingeniería de prompts no solo busca calidad, sino también eficiencia. Eliminar palabras de relleno, usar abreviaturas cuando el contexto lo permite y reestructurar los prompts puede reducir el número de tokens entre un 15 y un 25 % sin pérdida de calidad.
En lugar de «Analice los siguientes comentarios de clientes y proporcione un resumen detallado de los temas principales, el sentimiento y las conclusiones accionables», utilice «Analice estos comentarios. Enumere: temas principales, sentimiento, conclusiones accionables». La misma instrucción, con un 40 % menos de tokens.
Dirija cada solicitud al modelo adecuado
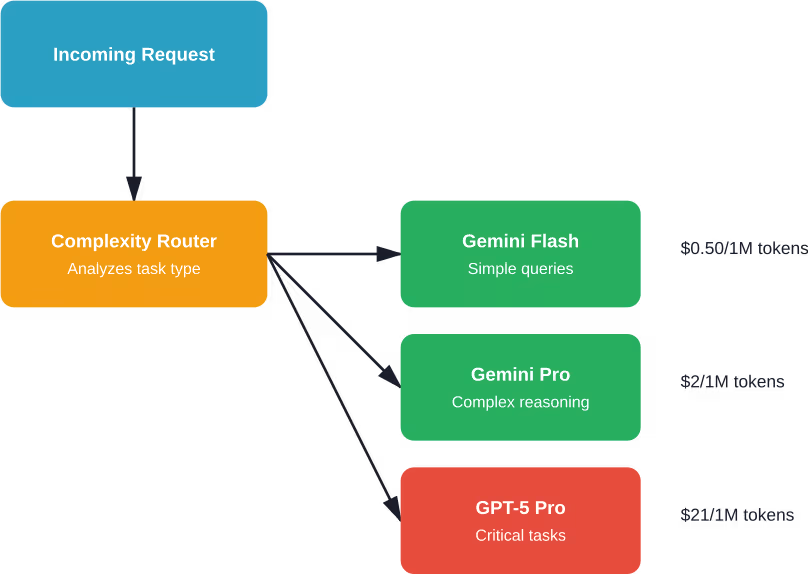
No todas las solicitudes necesitan Gemini Pro. Una capa de enrutamiento que envíe las consultas sencillas a Flash y el razonamiento complejo a Pro optimiza la relación entre costo y calidad.
Las tareas de clasificación, las preguntas y respuestas básicas y el rellenado de plantillas funcionan bien en Flash. El razonamiento en varios pasos, el análisis con matices y la generación creativa se benefician de las capacidades adicionales de Pro. Un enrutamiento inteligente puede reducir el costo medio por solicitud entre un 40 y un 50 % en cargas de trabajo mixtas.
Procese por lotes todo lo que pueda
Los requisitos de tiempo real suelen exagerarse. La moderación de contenido, el resumen de documentos, el enriquecimiento de datos y muchos otros flujos de trabajo toleran retrasos de 5 a 30 minutos sin afectar al usuario.
Migrar estas cargas de trabajo al procesamiento por lotes reduce los costos un 50 % de inmediato. Para las organizaciones que procesan millones de solicitudes al mes, eso supone ahorros de cinco cifras con un esfuerzo de ingeniería mínimo.
Supervise el gasto y configure alertas de presupuesto
Los costos descontrolados ocurren. Un bucle de reintentos mal configurado, un pico de tráfico inesperado o un ataque de prompt injection pueden agotar un presupuesto en cuestión de horas.
Las alertas de facturación de Google Cloud envían notificaciones cuando el gasto supera determinados umbrales. Configurar alertas al 50 %, 75 % y 90 % del presupuesto mensual proporciona un aviso temprano. Combinar las alertas con límites de cuota automáticos evita sobrecostos catastróficos.
Evite pagar de más por las API de LLM: valide antes su configuración
Usar las API de LLM de Google parece sencillo al principio, pero los costos crecen rápido cuando el uso escala, sobre todo si los prompts, el flujo de datos y el comportamiento del modelo no están optimizados. AI Superior trabaja en todo el ciclo de vida, desde la preparación de datos y la selección del modelo hasta el fine-tuning y el despliegue, lo que ayuda a reducir el uso innecesario de la API y a evitar configuraciones ineficientes.
En lugar de depender solo de API externas, el enfoque suele incluir evaluar cuándo resultan más rentables los modelos personalizados, el fine-tuning o las configuraciones híbridas. Esto es especialmente relevante para las empresas que pasan de la fase de pruebas a producción, donde los costos de API pueden acumularse con el tiempo. Si piensa apoyarse en API de LLM o ya ve que los costos aumentan, conviene revisar su arquitectura cuanto antes. Póngase en contacto con AI Superior para evaluar su configuración antes de que los costos sigan creciendo.
Ejemplos de costos reales
La teoría importa menos que la práctica. ¿Cuánto cuestan los despliegues reales?
Chatbot de atención al cliente
Una empresa mediana de comercio electrónico tiene un bot de soporte que gestiona 50 000 conversaciones al mes. Cada conversación tiene de media 8 mensajes, con 200 tokens de entrada y 150 tokens de salida por mensaje.
Volumen mensual total: 50 000 conversaciones × 8 mensajes × (200 de entrada + 150 de salida) = 140 millones de tokens (80M de entrada, 60M de salida).
Con Gemini 3.1 Flash ($0.50 de entrada para texto/imagen, $3 de salida para texto): aproximadamente $40 de entrada + $30 de salida = $70 al mes.
Con Gemini 3.1 Pro ($2 de entrada, $12 de salida): $160 de entrada + $720 de salida = $880 al mes.
Flash resuelve este caso de uso con eficacia y ahorra $810 al mes, una reducción de costos del 97 %.
Pipeline de procesamiento de documentos
Una startup de legal tech procesa 10 000 contratos al mes, de 5000 tokens de media cada uno. La extracción y el análisis generan 1000 tokens de salida por documento.
Volumen total: 10 000 documentos × (5000 de entrada + 1000 de salida) = 60 millones de tokens (50M de entrada, 10M de salida).
Con procesamiento por lotes en Gemini 3 Standard: 50M × $1.50/1M (entrada por lotes) + 10M × $7.50/1M (salida por lotes) = $75 + $75 = $150 al mes.
En tiempo real: 50M × $3/1M + 10M × $15/1M = $150 + $150 = $300 al mes.
El procesamiento por lotes reduce los costos a la mitad sin ningún impacto en la calidad en los flujos de trabajo nocturnos.
Cuándo elegir Google frente a la competencia
Las API de LLM de Google destacan en escenarios concretos, pero no son la mejor opción en todos los casos.
Elija Google Vertex AI cuando:
- Ya opera dentro de la infraestructura de Google Cloud: los costos de transferencia de datos e integración se reducen considerablemente
- Necesita capacidades multimodales: Gemini procesa texto, imágenes, audio y video en prompts unificados
- Desarrolla aplicaciones RAG: la búsqueda vectorial y las herramientas de grounding integradas de Vertex AI reducen la complejidad de la arquitectura
- Necesita ventanas de contexto muy largas: Gemini 1.5 Pro admite hasta 2 millones de tokens, muy por encima de la mayoría de sus competidores
- Prioriza la eficiencia de costos en tareas de complejidad moderada: los modelos Flash ofrecen una excelente relación calidad-precio
Busque otras opciones cuando: la máxima capacidad de razonamiento importa más que el costo (GPT-5.2 Pro supera a Gemini en tareas lógicas complejas); se trata de ámbitos especializados como las matemáticas avanzadas o la programación competitiva (los modelos de OpenAI lideran actualmente estos benchmarks); o existen requisitos de cumplimiento de tolerancia cero (algunos sectores exigen certificaciones específicas que favorecen a los proveedores consolidados).
Preguntas frecuentes
¿Cuánto cuesta la API de LLM más barata de Google?
En marzo de 2026, Gemini 3.1 Flash-Lite cuesta $0.25 por millón de tokens de entrada (con contexto de hasta 200K), lo que la convierte en una de las opciones más económicas de Google. Con procesamiento por lotes y caché, el costo efectivo puede bajar a $0.15 por millón de tokens en los aciertos de caché por lotes, aunque las escrituras iniciales en la caché por lotes cuestan $1.875 por millón.
¿Qué diferencia de precio hay entre Gemini Pro y Flash?
Gemini 3.1 Pro cuesta $2 por millón de tokens de entrada, frente a los $0.50 de Flash: cuatro veces más. En los tokens de salida la diferencia es similar: Pro cobra $12 por millón, mientras que Flash aplica tarifas estándar considerablemente más bajas. Pro ofrece mejor razonamiento y más matices; Flash está optimizado para velocidad y costo en tareas más sencillas.
¿Cobra Google por las solicitudes de API fallidas?
Google cobra todos los tokens procesados en las solicitudes correctas (200 OK). Sin embargo, algunos errores 4xx (como el 429 Too Many Requests) no generan costos, mientras que otros relacionados con el filtrado de contenido durante la generación pueden dar lugar a cargos por los tokens de entrada.
¿Cómo reduce la caché de contexto los costos de los LLM de Google?
Almacenar en caché el contexto repetido reduce el costo de los tokens en aproximadamente un 90 %. En Gemini 3.1 Pro, los tokens de entrada en caché cuestan $0.20 por millón, frente a $2 sin caché.
¿Cuánto cuesta el grounding en los modelos Gemini?
Gemini 2.5 Pro incluye 10 000 prompts con grounding gratuitos al día. Por encima de ese límite, el grounding estándar cuesta $35 por cada 1000 prompts con grounding. El web grounding empresarial cuesta $45 por cada 1000 prompts. Estos cargos se suman al costo estándar de los tokens de entrada y salida.
¿Puedo usar las API de LLM de Google gratis?
A diferencia de algunos competidores, Google no ofrece un nivel gratuito permanente para el uso de LLM en Vertex AI. Sin embargo, las cuentas nuevas de Google Cloud reciben créditos (normalmente $300) para las pruebas iniciales. El modelo es de pago por uso, sin consumo mínimo, lo que permite hacer pruebas a pequeña escala con un costo mínimo.
¿Cómo funcionan los precios del procesamiento por lotes?
El procesamiento por lotes reduce el costo de los tokens un 50 % en todos los modelos Gemini de Google. Por ejemplo, Gemini 3 Standard pasa de $3 a $1.50 por millón de tokens de entrada y de $15 a $7.50 por millón de tokens de salida. Las solicitudes por lotes se procesan de forma asíncrona, con tiempos de finalización de minutos a horas según la longitud de la cola.
Cómo tomar la decisión sobre costos
Los precios de las API de LLM de Google sitúan a Vertex AI en una posición competitiva en el mercado de 2026, sobre todo para aplicaciones que ya funcionan dentro del ecosistema de Google Cloud.
La estructura de costos premia la optimización. Los desarrolladores que aplican caché, procesamiento por lotes y enrutamiento inteligente entre modelos pueden lograr costos efectivos entre un 70 y un 80 % inferiores a los precios de lista. Quienes despliegan los modelos sin optimizar pagarán bastante de más.
El precio por token sigue siendo el modelo dominante entre los grandes proveedores, pero el costo efectivo por respuesta generada varía enormemente según las decisiones de implementación. Un despliegue bien diseñado sobre Gemini Flash puede ofrecer capacidades de IA a una décima parte del costo de un despliegue de GPT-5 Pro sin optimizar.
La pregunta clave no es qué proveedor tiene el precio de lista más bajo, sino qué combinación de capacidad del modelo, estructura de precios e integración con la infraestructura ofrece el mejor valor para las características concretas de cada carga de trabajo.
Empiece con un benchmarking claro. Pruebe cargas de trabajo representativas con modelos de Google, OpenAI y Anthropic. Mida no solo la calidad, sino también el consumo real de tokens, la latencia y las tasas de error. Calcule el costo total de propiedad, incluidos la infraestructura, la transferencia de datos y el tiempo de ingeniería.
Después, optimice sin concesiones. Cada reducción del 10 % en el promedio de tokens por solicitud, cada punto porcentual de mejora en la tasa de aciertos de caché y cada carga de trabajo migrada al procesamiento por lotes se traducen directamente en ahorro.
El panorama de costos de los LLM sigue evolucionando rápidamente. Los precios competitivos de hoy pueden quedar obsoletos en pocos meses a medida que los proveedores se disputan cuota de mercado. Al construir una infraestructura de IA a largo plazo, la flexibilidad presupuestaria y la adaptabilidad de la arquitectura importan tanto como los precios actuales.