
Des réponses dans votre contexte
Les modèles entraînés sur vos données propriétaires fournissent des réponses précises et contextualisées pour vos clients et vos processus.
Entraînement de LLM · Des données au benchmark
Bien entraîner un modèle de langage est un travail d’ingénierie : les bonnes données, un pipeline qui utilise efficacement la puissance de calcul et la preuve que le modèle fonctionne avant sa mise en production. Nous sélectionnons vos jeux de données, construisons des pipelines d’entraînement distribués, réglons les hyperparamètres et évaluons le résultat sur des cas de test réels.
L’entraînement détermine la précision, l’efficacité et la fiabilité de votre modèle au quotidien.
Les modèles entraînés sur vos données propriétaires fournissent des réponses précises et contextualisées pour vos clients et vos processus.
Des pipelines évolutifs et un réglage systématique des hyperparamètres tirent le meilleur parti des ressources de calcul et réduisent les coûts.
Une validation par des métriques standard et des benchmarks réels confirme la précision, l’efficacité et la robustesse avant le déploiement.
Le cycle d’entraînement complet, des données brutes à un modèle validé et tenu à jour.
Nous prétraitons et sélectionnons de grands jeux de données diversifiés, avec nettoyage et augmentation de données pour améliorer la précision et la compréhension du contexte.
Des pipelines de bout en bout conçus pour vos besoins, qui s’appuient sur le calcul distribué, des environnements cloud et des GPU haute performance pour accélérer l’entraînement.
Nous adaptons des modèles pré-entraînés avec les données de votre domaine pour une précision et une pertinence accrues.
Nous testons et ajustons systématiquement les paramètres pour améliorer l’efficacité de l’entraînement, réduire le surapprentissage et aider le modèle à généraliser.
Nous évaluons les modèles entraînés au regard de métriques standard et de benchmarks réels avant leur mise en production.
Des mesures de sécurité et de conformité protègent les jeux de données d’entraînement sensibles tout au long du processus.
Nous aidons à mettre le modèle entraîné en production et à l’intégrer à vos workflows et applications.
Nous surveillons les performances et mettons à jour le modèle avec de nouvelles données, pour qu’il reste précis et pertinent dans la durée.
Vous ne savez pas de quoi vous avez besoin ? Décrivez-nous le problème, nous vous recommanderons l’approche adaptée.
Parlons de votre projet
LLM interneaucune dépendance à des services LLM tiers
Un chatbot privé et hébergé, fondé sur un grand modèle de langage sur mesure, qui fournit à un cabinet de conseil des réponses accompagnées de leurs sources tout en lui laissant la maîtrise totale de ses données.
Lire l’étude de cas
1 semaine de travail d’analyste économisée par nouveau marché de niche
Une solution NLP de bout en bout qui permet aux fonds de private equity et de capital-risque de trouver et de regrouper les entreprises pertinentes selon leur activité réelle, et non selon un code sectoriel ou un mot-clé.
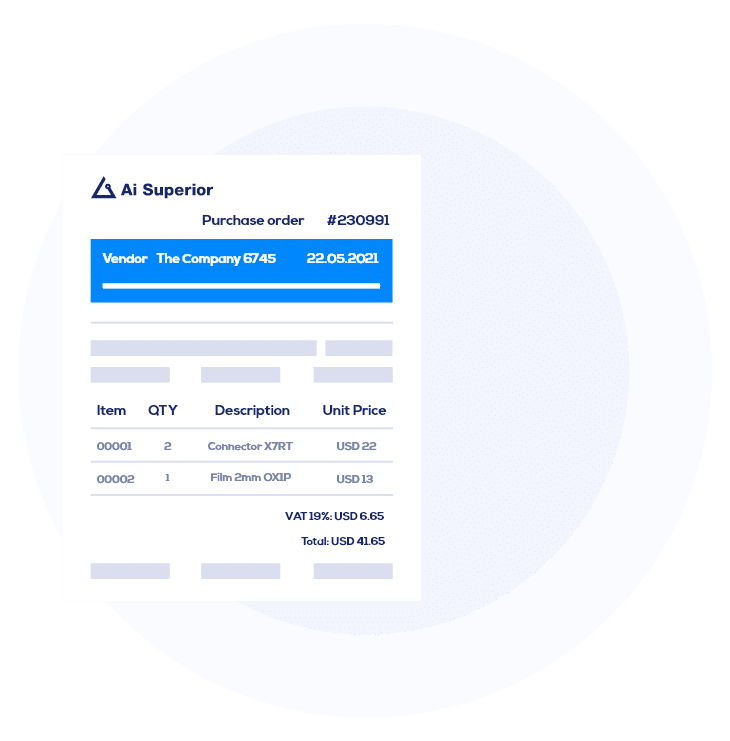
25x plus rapide pour traiter les factures
Un service web qui extrait les données de différents types de factures. Il automatise la saisie pour un distributeur d’équipements multinational et lui fait gagner 850 heures de travail par mois.
~10 000 heures de travail économisées
Un outil NLP interactif qui évalue les compétences des collaborateurs, compare les profils de compétences et identifie les écarts entre les collaborateurs clés et leurs successeurs potentiels.
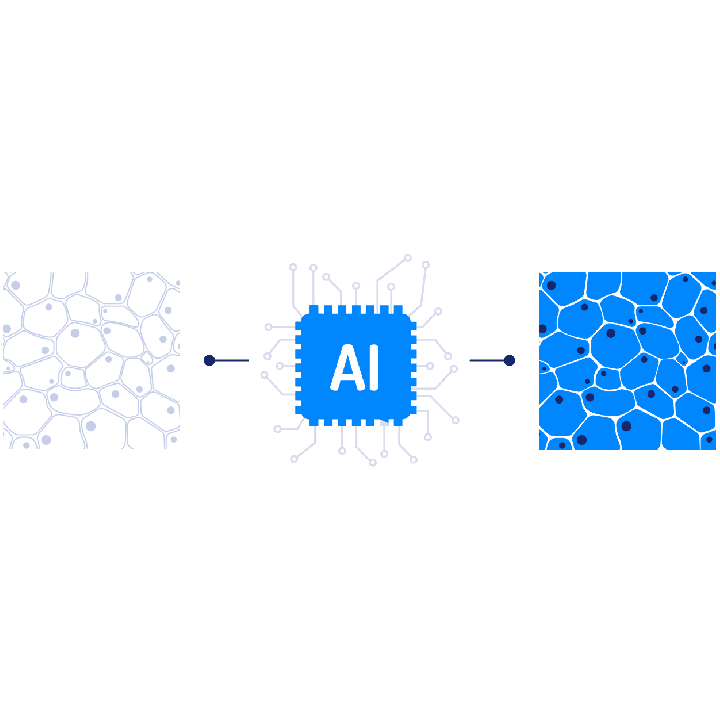
Réutilisé un seul classifieur de pathologies pour tous les réactifs de coloration
Un composant d’IA qui traduit des images histologiques d’un domaine de coloration à un autre, pour réutiliser les logiciels et modèles de machine learning existants avec tous les réactifs.
Beaucoup de prestataires savent construire une démo. Faire fonctionner l’IA de manière fiable sur des données réelles, au cœur de vrais processus métier, exige une tout autre équipe. C’est ce que vous trouvez chez nous.
AI Superior a été fondée en 2019 par des chercheurs en IA, auteurs de publications et de brevets. Cette expertise irrigue toute l’équipe.
Chaque projet est sécurisé par étapes, avec une décision go/no-go à chaque jalon : le budget ne va qu’aux solutions validées sur vos données.
Stratégie, modèles et logiciel sont conçus ensemble, sans passage de relais entre prestataires distincts.
Lorsque vos données ne doivent pas quitter votre organisation, nous nous appuyons sur des modèles privés auto-hébergés plutôt que sur des services d’IA tiers.
Votre projet est piloté par des data scientists et des ingénieurs seniors issus de la recherche, épaulés par nos équipes produit et développement.
 Dr. Sergey Sukhanov Chief Data Scientist
Doctorat en machine learning, data scientist depuis 2013. Publications, brevets et plus de 30 cas d’usage d’IA mis en œuvre ; plusieurs distinctions de l’IEEE.
 Dr. Ivan Tankoyeu Chief Data Officer
Doctorat en informatique. Distingué par l’IEEE GRSS Society, lauréat du Global AI Hackathon 2017, classé dans le TOP500 des data scientists sur Kaggle (2014).
 Sergio Frayle, M.Sc. Lead Data Scientist
Master en IA, reconnaissance de formes et imagerie numérique ; plus de 7 ans d’expérience en traitement d’images et en vision par ordinateur, avec publications.
 Enrique Fernández, M.Sc. Expert ML senior
Master en robotique et mécatronique ; conçoit et déploie des solutions d’IA complexes, notamment en vision par ordinateur et en NLP.
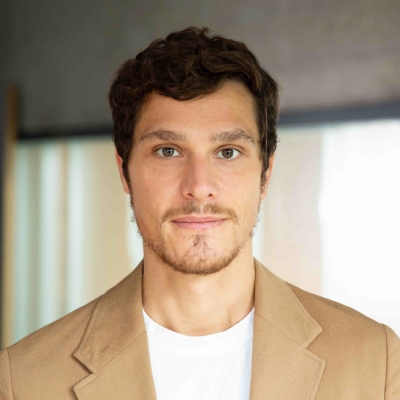 Peter Luck, M.Sc. Consultant IA
Master en Business Engineering et informatique ; chef de produit et chef de projet pour des produits de machine learning.
“AI Superior a fait preuve d’un réel engagement pour nous livrer des solutions de grande qualité.”
Amélioration et maintenance de l’infrastructure de données d’une société de solutions de crédit : pipelines de données, modèles de ML et rapports sur mesure.
“AI Superior a répondu avec beaucoup d’attention à tous nos besoins et les a pris en compte dans le projet.”
Développement de modèles d’IA et d’un tableau de bord pour un programme pilote de détection de déchets sur des images de drones.
“Ils ont livré un module supplémentaire que nous n’attendions pas, mais qui s’est révélé très utile.”
Recherche et développement logiciel sur mesure fondés sur des réseaux antagonistes génératifs (GAN), pour une entreprise pharmaceutique de plus de 5 000 salariés.
Chaque étape se conclut par un résultat vérifiable. Vous ne vous engagez jamais dans l’étape suivante avant d’avoir vu la précédente fonctionner : périmètre, budget et risques restent sous votre contrôle.
Nous analysons le problème métier avec vos équipes et définissons l’orientation de la solution.
Vous obtenez : Périmètre, approche et estimation globale de l’effort et des résultats attendus
Nous découvrons votre équipe et vos données, et vérifions si l’IA est le bon outil pour ce problème.
Vous obtenez : Une évaluation des données et un verdict clair sur la faisabilité, avant tout développement
Nous commençons petit, avec les données déjà disponibles, pour tester la solution en conditions réelles.
Vous obtenez : Des résultats mesurés sur vos propres données et une base solide pour la décision d’investissement
Nous intégrons la solution à vos systèmes existants, affinons les modèles et les ajustons si nécessaire.
Vous obtenez : Une solution opérationnelle au sein de vos processus, compatible avec vos données et vos systèmes
Ensemble, nous évaluons les résultats de la mise en œuvre et veillons à ce qu’ils soient correctement interprétés.
Vous obtenez : Une vision claire de la valeur créée et des prochains axes d’amélioration
Nous adaptons les jeux de données, les workflows et l’entraînement aux besoins de chaque secteur.
Des modèles entraînés sur des données et des documents financiers.
Des modèles pour les tâches cliniques et les échanges avec les patients.
Des modèles qui aident les clients à trouver et acheter les produits.
Des modèles entraînés sur des contrats, de la jurisprudence et de la réglementation.
Des modèles qui rédigent et optimisent des contenus avec le ton de votre marque.
Distinguée par des prix internationaux et par des plateformes B2B indépendantes qui classent les entreprises selon des avis clients vérifiés.
 Lauréat des Go Global Awards 2021 · International Trade Council
 Meilleur prestataire de services en data science et IA, Europe 2021 · German Business Awards
 Top entreprise d’intelligence artificielle 2023 · Clutch
 Top entreprise de machine learning 2023 · Clutch
 Clutch Champion Automne 2023 · Clutch
 Clutch Global Automne 2023 · Clutch
 Top entreprise BI et big data Allemagne 2023 · Clutch
 Top entreprise de services informatiques Allemagne 2023 · Clutch
 Top entreprises d’intelligence artificielle 2023 · TrueFirms
 Top entreprises de machine learning 2021 · Techreviewer
 Entreprises de services informatiques les plus évaluées Allemagne · The Manifest
L’entraînement couvre l’ensemble du développement d’un modèle sur de grands jeux de données, avec d’importantes ressources de calcul. Le fine-tuning adapte un modèle pré-entraîné existant avec les données de votre domaine. Nous vous conseillons sur la voie adaptée à vos objectifs et combinons souvent les deux.
Un modèle entraîné sur vos données propriétaires est plus précis et plus efficace pour vos tâches, qu’il s’agisse d’un assistant IA pour vos clients, d’analyse de documents propres à votre secteur ou d’un système multilingue.
Oui. Nous adaptons les jeux de données d’entraînement, les workflows et le fine-tuning aux exigences de votre secteur et à vos objectifs métier.
Nous utilisons le chiffrement, des contrôles d’accès et des mesures de conformité pour protéger les informations sensibles pendant tout l’entraînement.
Nous le validons avec des métriques standard, des cas de test réels et des benchmarks avant le déploiement, puis continuons à surveiller ses performances en production.
Cela dépend de la complexité des données, de la taille du modèle et des besoins en calcul. Nous établissons un plan d’entraînement et une estimation en fonction de vos exigences.
Contactez-nous pour parler de vos besoins en entraînement. Nous vous proposerons une stratégie sur mesure pour développer, affiner et déployer votre modèle.
Partagez quelques informations et notre équipe IA s’occupe du reste. Voici la suite :
Vous préférez choisir un créneau ?
Planifier un appel