
Antwoorden in uw context
Modellen getraind op uw eigen data geven nauwkeurige, contextbewuste antwoorden voor uw klanten en processen.
LLM-training · Van data tot benchmark
Een taalmodel goed trainen is engineeringwerk: de juiste data, een pijplijn die rekenkracht efficiënt benut en het bewijs dat het model werkt voordat het in productie gaat. Wij stellen uw datasets samen, bouwen gedistribueerde trainingspijplijnen, optimaliseren hyperparameters en benchmarken het resultaat op praktijkcases.
De training bepaalt hoe nauwkeurig, efficiënt en betrouwbaar uw model in het dagelijks gebruik is.
Modellen getraind op uw eigen data geven nauwkeurige, contextbewuste antwoorden voor uw klanten en processen.
Schaalbare pijplijnen en systematische hyperparameteroptimalisatie halen het maximale uit de rekenkracht en verlagen de kosten.
Validatie met standaardmetrieken en praktijkbenchmarks bevestigt nauwkeurigheid, efficiëntie en robuustheid vóór de deployment.
De volledige trainingscyclus, van ruwe data tot een gevalideerd model dat actueel blijft.
Wij bewerken en selecteren grote, diverse datasets, met opschoning en data-augmentatie om nauwkeurigheid en contextbegrip te verbeteren.
Pijplijnen van begin tot eind, gebouwd voor uw behoeften, met gedistribueerde verwerking, cloudomgevingen en krachtige gpu's om de training te versnellen.
Wij passen voorgetrainde modellen aan met uw domeinspecifieke data voor meer nauwkeurigheid en relevantie.
Wij testen en passen parameters systematisch aan om de trainingsefficiëntie te verbeteren, overfitting te beperken en het model beter te laten generaliseren.
Wij evalueren getrainde modellen aan de hand van standaardmetrieken en praktijkbenchmarks voordat ze live gaan.
Maatregelen voor gegevensbeveiliging en compliance beschermen gevoelige trainingsdatasets gedurende het hele proces.
Wij helpen het getrainde model in productie te nemen en te integreren met uw workflows en applicaties.
Wij bewaken de prestaties en werken het model bij met nieuwe data, zodat het na verloop van tijd nauwkeurig en relevant blijft.
Weet u niet zeker wat u nodig hebt? Beschrijf het probleem en wij adviseren u over de aanpak.
Bespreek uw project
Eigen LLMgeen afhankelijkheid van LLM-diensten van derden
Een private, gehoste chatbot op basis van een op maat gemaakt large language model. Het adviesbureau krijgt antwoorden met bronverwijzingen en houdt volledige controle over zijn data.
Lees de case study
1 week analistenwerk bespaard per nieuwe nichemarkt
Een end-to-end NLP-oplossing waarmee private-equityfondsen en venture-capitalbedrijven relevante bedrijven vinden en clusteren op betekenis, in plaats van op branchecode of trefwoord.
25x snellere factuurverwerking
Een webdienst die gegevens uit verschillende soorten facturen haalt, de gegevensinvoer automatiseert voor een multinationale distributeur van apparatuur en 850 manuren per maand bespaart.
~10.000 bespaarde manuren
Een interactieve NLP-tool die de vaardigheden van medewerkers beoordeelt, vaardigheidsprofielen vergelijkt en skill gaps signaleert tussen bedrijfskritische medewerkers en hun mogelijke opvolgers.
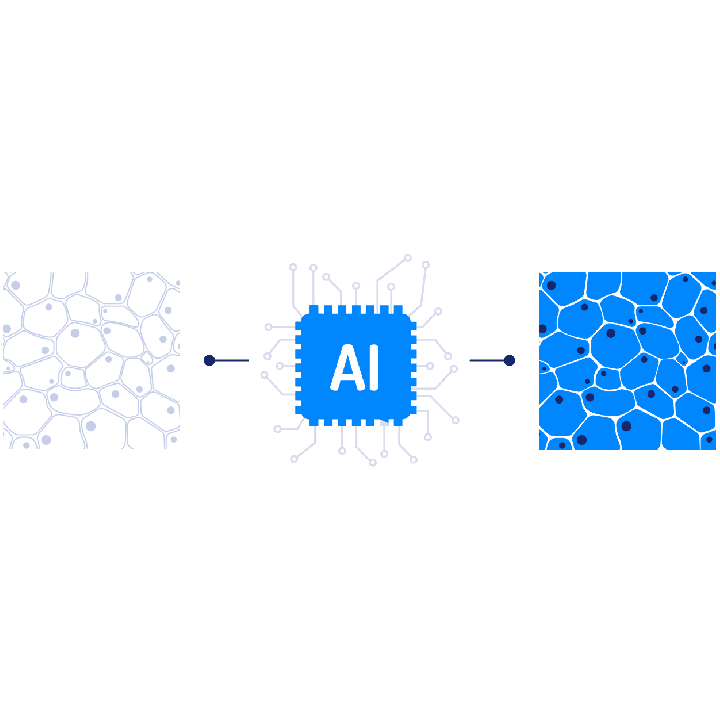
Hergebruikt één ziekteclassifier voor alle kleurreagentia
Een AI-component die histologische beelden van het ene kleuringsdomein naar het andere vertaalt, zodat bestaande software en machine-learningmodellen voor alle reagentia kunnen worden hergebruikt.
Veel leveranciers kunnen een demo bouwen. AI betrouwbaar laten werken op echte data, binnen echte bedrijfsprocessen, vraagt om een ander soort team. Dat team krijgt u bij ons.
AI Superior werd in 2019 opgericht door AI-onderzoekers met gepubliceerde papers en patenten. Die diepgang vindt u in het hele team terug.
Bij elk project beperken we het risico stap voor stap, met een go/no-go-beslissing bij elke mijlpaal. Zo gaat uw budget alleen naar oplossingen die zich op uw data hebben bewezen.
Strategie, modellen en software worden samen ontworpen, niet doorgegeven tussen losse leveranciers.
Mag data uw organisatie niet verlaten, dan bouwen we op private, zelf gehoste modellen in plaats van AI-diensten van derden.
Uw project wordt geleid door senior data scientists en engineers met een onderzoeksachtergrond, ondersteund door onze product- en ontwikkelteams.
 Dr. Sergey Sukhanov Chief Data Scientist
Gepromoveerd in machine learning, data scientist sinds 2013. Publicaties, patenten en meer dan 30 geïmplementeerde AI-use cases; meerdere IEEE-prijzen.
 Dr. Ivan Tankoyeu Chief Data Officer
Gepromoveerd in de informatica. Erkend door de IEEE GRSS Society, winnaar van de Global AI Hackathon 2017, Kaggle TOP500 data scientist (2014).
 Sergio Frayle, M.Sc. Lead Data Scientist
Master in AI, patroonherkenning en digitale beeldverwerking; meer dan 7 jaar ervaring in beeldverwerking en computer vision, met publicaties.
 Enrique Fernández, M.Sc. Senior ML Expert
Master in robotica en mechatronica; bouwt en implementeert complexe AI-oplossingen, vooral in computer vision en NLP.
 Peter Luck, M.Sc. AI Consultant
Master in bedrijfskunde en informatica; product- en projectmanager voor machine learning-producten.
“AI Superior toonde een sterke inzet om ons oplossingen van hoge kwaliteit te leveren.”
Verbetert en onderhoudt de data-infrastructuur van een aanbieder van kredietoplossingen: datapipelines, ML-modellen en rapportages op maat.
“AI Superior is zeer zorgvuldig op al onze behoeften ingegaan en heeft ze in het project meegenomen.”
Bouwde AI-modellen en een dashboard voor een pilotprogramma dat afval detecteert in dronebeelden.
“Ze leverden een extra module die we niet hadden verwacht, maar die zeer nuttig bleek.”
Onderzoek en softwareontwikkeling op maat met generative adversarial networks voor een farmaceutisch bedrijf met meer dan 5.000 medewerkers.
Elke fase eindigt met een resultaat dat u kunt controleren. U stapt pas in de volgende fase als u de vorige hebt zien werken. Zo houdt u scope, budget en risico zelf in de hand.
Samen met uw team werken we het bedrijfsprobleem uit en bepalen we de richting van de oplossing.
U ontvangt: Scope, aanpak en een globale inschatting van inspanning en verwachte resultaten
We leren uw team en uw data kennen en toetsen of AI het juiste middel is voor dit probleem.
U ontvangt: Een data-assessment en een helder haalbaarheidsoordeel, nog voordat de bouw begint
We beginnen klein, met de data die al beschikbaar is, om de oplossing in de praktijk te testen.
U ontvangt: Gemeten resultaten op uw eigen data en een basis voor de investeringsbeslissing
We integreren de oplossing in uw bestaande systemen, finetunen de modellen en passen ze aan waar nodig.
U ontvangt: Een oplossing die draait binnen uw processen, afgestemd op uw data en systemen
Samen evalueren we de resultaten van de implementatie en zorgen we dat ze juist worden geïnterpreteerd.
U ontvangt: Een helder beeld van de geleverde waarde en van wat u hierna kunt verbeteren
Wij stemmen datasets, workflows en training af op de behoeften van elke sector.
Modellen getraind op financiële data en documenten.
Modellen voor klinische en patiëntgerichte taken.
Modellen die verbeteren hoe klanten producten vinden en kopen.
Modellen getraind op contracten, jurisprudentie en regelgeving.
Modellen die content schrijven en optimaliseren in uw stem.
Erkend door internationale bedrijfsprijzen en door onafhankelijke B2B-platforms die bedrijven rangschikken op basis van geverifieerde klantreviews.
 Go Global Awards Winner 2021 · International Trade Council
 Beste dienstverlener in data science & AI, Europa 2021 · German Business Awards
 Top AI-bedrijf 2023 · Clutch
 Top machine learning-bedrijf 2023 · Clutch
 Clutch Champion Najaar 2023 · Clutch
 Clutch Global Najaar 2023 · Clutch
 Top BI- & big data-bedrijf Duitsland 2023 · Clutch
 Top IT-dienstverlener Duitsland 2023 · Clutch
 Top AI-bedrijven 2023 · TrueFirms
 Top machine learning-bedrijven 2021 · Techreviewer
 Meest beoordeelde IT-dienstverleners Duitsland · The Manifest
Training omvat het volledige proces van het ontwikkelen van een model op grote datasets met aanzienlijke rekenkracht. Finetuning past een bestaand voorgetraind model aan met uw domeinspecifieke data. Wij adviseren welke route bij uw doelen past en combineren vaak beide.
Een model dat is getraind op uw eigen data is nauwkeuriger en efficiënter voor uw taken, of het nu gaat om een AI-assistent voor uw klanten, sectorspecifieke documentanalyse of een meertalig systeem.
Ja. Wij stemmen de trainingsdatasets, workflows en finetuning af op de eisen van uw sector en uw bedrijfsdoelen.
Wij gebruiken versleuteling, toegangscontroles en compliancemaatregelen om gevoelige informatie gedurende de hele training te beschermen.
Wij valideren het vóór de deployment met standaardmetrieken, praktijkcases en benchmarks, en blijven de prestaties in productie bewaken.
Dat hangt af van de complexiteit van de data, de omvang van het model en de benodigde rekenkracht. Wij stellen een trainingsplan en een inschatting op basis van uw eisen op.
Neem contact met ons op om uw trainingsbehoeften te bespreken. Wij stellen een strategie op maat voor om uw model te ontwikkelen, te finetunen en uit te rollen.
Deel een paar details en ons AI-team neemt het over. Dit zijn de volgende stappen:
Liever zelf een tijd kiezen?
Plan een gesprek