Antworten in Ihrem Kontext
Modelle, trainiert auf Ihren eigenen Daten, liefern präzise, kontextbezogene Antworten für Ihre Kunden und Prozesse.
LLM-Training · Von den Daten zum Benchmark
Ein Sprachmodell gut zu trainieren, ist eine Engineering-Aufgabe: die richtigen Daten, eine Pipeline, die Rechenleistung effizient nutzt, und der Nachweis, dass das Modell funktioniert, bevor es in den Produktivbetrieb geht. Wir kuratieren Ihre Datensätze, bauen verteilte Trainingspipelines, optimieren Hyperparameter und prüfen das Ergebnis mit Benchmarks an realen Testfällen.
Das Training entscheidet, wie genau, effizient und zuverlässig Ihr Modell im Alltag ist.
Modelle, trainiert auf Ihren eigenen Daten, liefern präzise, kontextbezogene Antworten für Ihre Kunden und Prozesse.
Skalierbare Pipelines und systematisches Hyperparameter-Tuning holen das Beste aus den Rechenressourcen heraus und senken die Kosten.
Die Validierung mit Standardmetriken und realen Benchmarks bestätigt Genauigkeit, Effizienz und Robustheit vor dem Deployment.
Der gesamte Trainingszyklus, von Rohdaten bis zu einem validierten Modell, das aktuell bleibt.
Wir verarbeiten und kuratieren große, vielfältige Datensätze, mit Bereinigung und Datenaugmentation für mehr Genauigkeit und besseres Kontextverständnis.
Durchgängige Pipelines, gebaut für Ihren Bedarf, mit verteiltem Rechnen, Cloud-Umgebungen und leistungsstarken GPUs, um das Training zu beschleunigen.
Wir passen vortrainierte Modelle mit Ihren fachspezifischen Daten an, für mehr Genauigkeit und Relevanz.
Wir testen und justieren Parameter systematisch, um die Trainingseffizienz zu verbessern, Overfitting zu reduzieren und die Generalisierung des Modells zu fördern.
Wir bewerten trainierte Modelle anhand von Standardmetriken und realen Benchmarks, bevor sie live gehen.
Maßnahmen für Datensicherheit und Compliance schützen sensible Trainingsdatensätze während des gesamten Prozesses.
Wir helfen, das trainierte Modell in den Produktivbetrieb zu bringen und in Ihre Workflows und Anwendungen zu integrieren.
Wir überwachen die Leistung und aktualisieren das Modell mit neuen Daten, damit es dauerhaft präzise und relevant bleibt.
Nicht sicher, was davon Sie brauchen? Beschreiben Sie das Problem, und wir empfehlen Ihnen den passenden Ansatz.
Projekt besprechen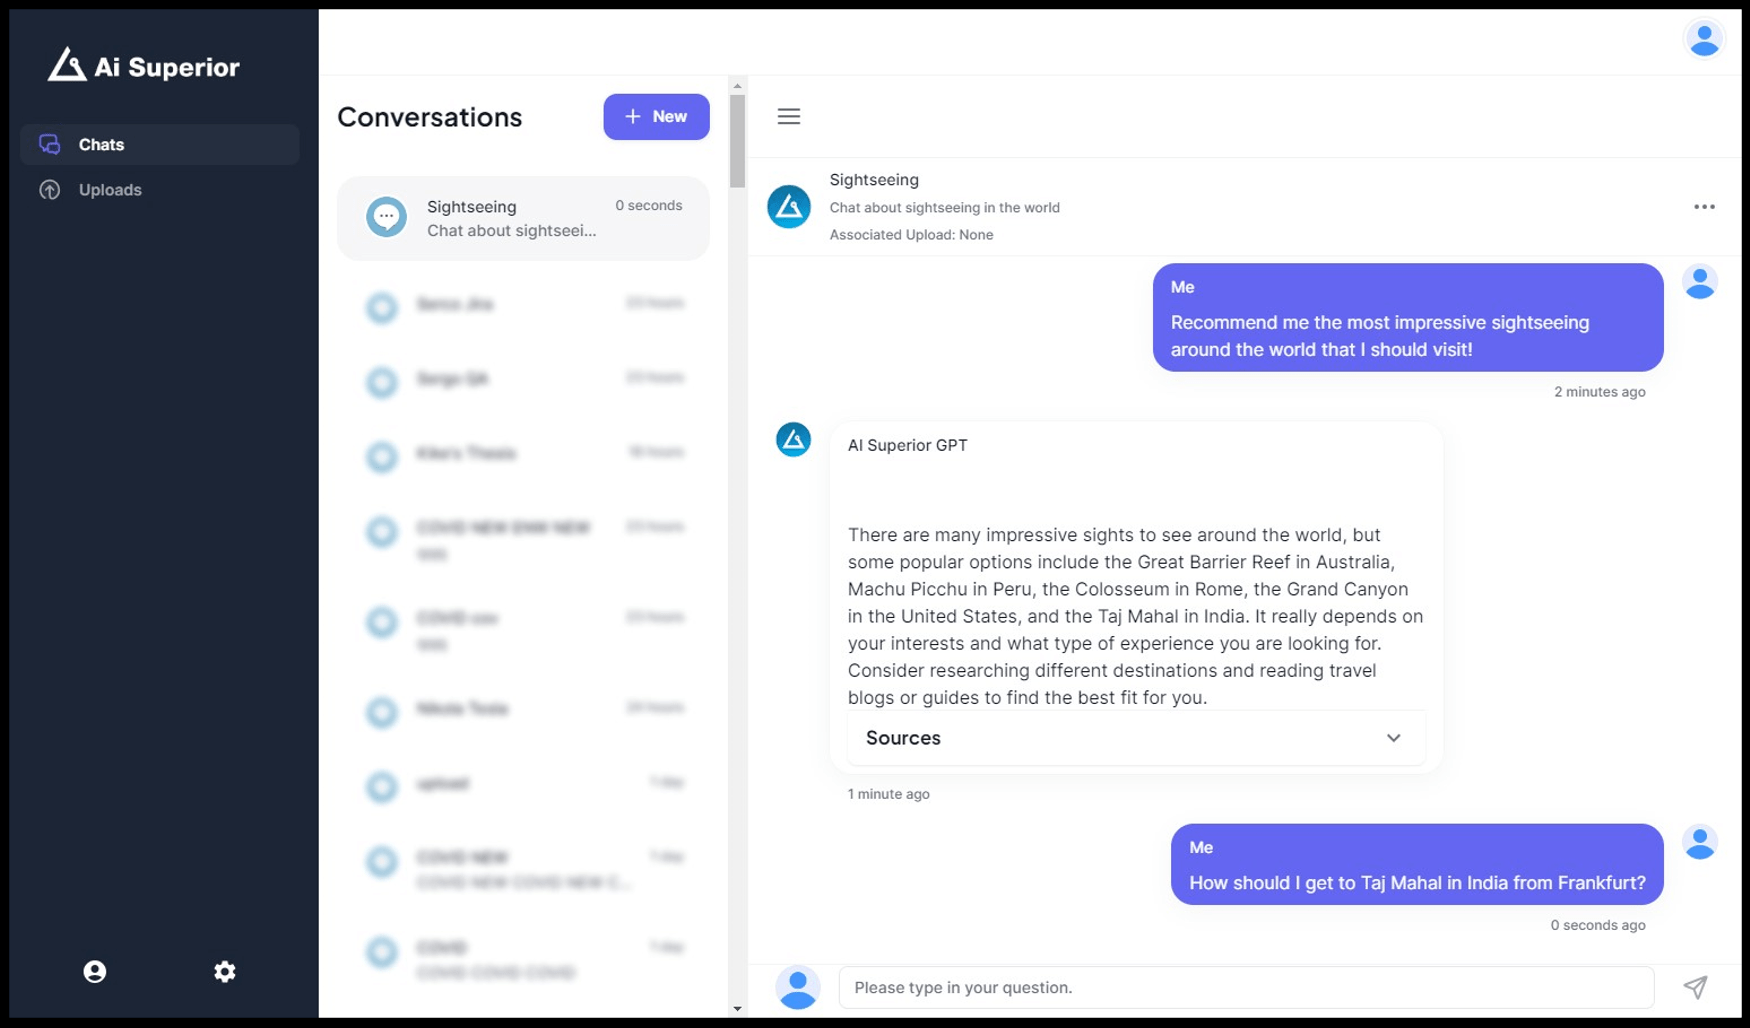
Eigenes LLMkeine Abhängigkeit von LLM-Diensten Dritter
Ein privater, gehosteter Chatbot auf Basis eines maßgeschneiderten Large Language Models. Er liefert einem Beratungsunternehmen Antworten mit Quellenangaben – bei voller Kontrolle über die eigenen Daten.
Fallstudie lesen
1 Woche Analystenarbeit pro neuem Nischenmarkt eingespart
Eine End-to-End-NLP-Lösung, mit der Private-Equity-Fonds und Venture-Capital-Gesellschaften relevante Unternehmen nach inhaltlicher Bedeutung finden und gruppieren – statt nach Branchencode oder Schlagwort.
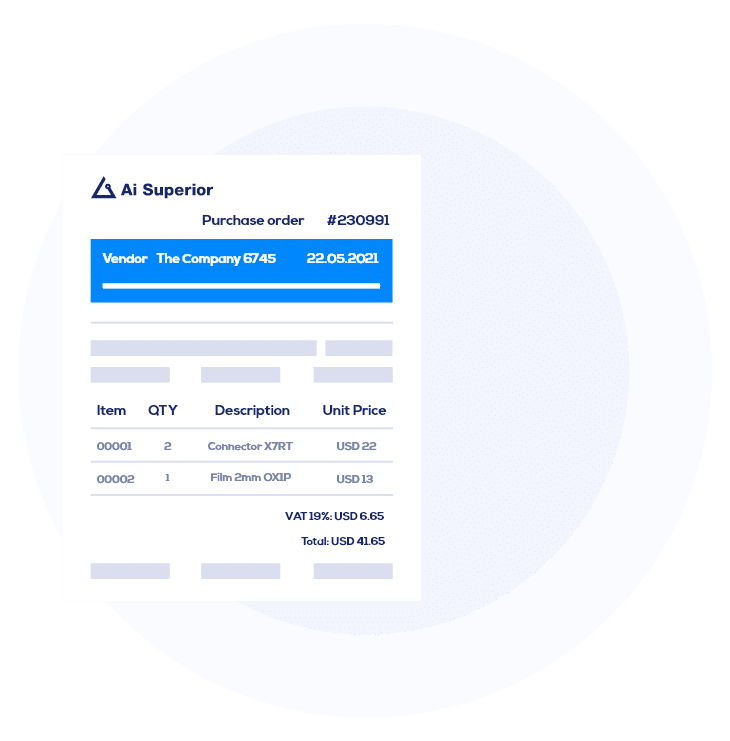
25x schnellere Rechnungsverarbeitung
Ein Webservice, der Daten aus verschiedenen Rechnungstypen extrahiert, die Dateneingabe für einen multinationalen Anlagenhändler automatisiert und 850 Arbeitsstunden pro Monat spart.
~10.000 eingesparte Arbeitsstunden
Ein interaktives NLP-Tool, das die Kompetenzen von Mitarbeitenden bewertet, Skill-Profile vergleicht und Kompetenzlücken zwischen geschäftskritischen Mitarbeitenden und ihren potenziellen Nachfolgern aufzeigt.
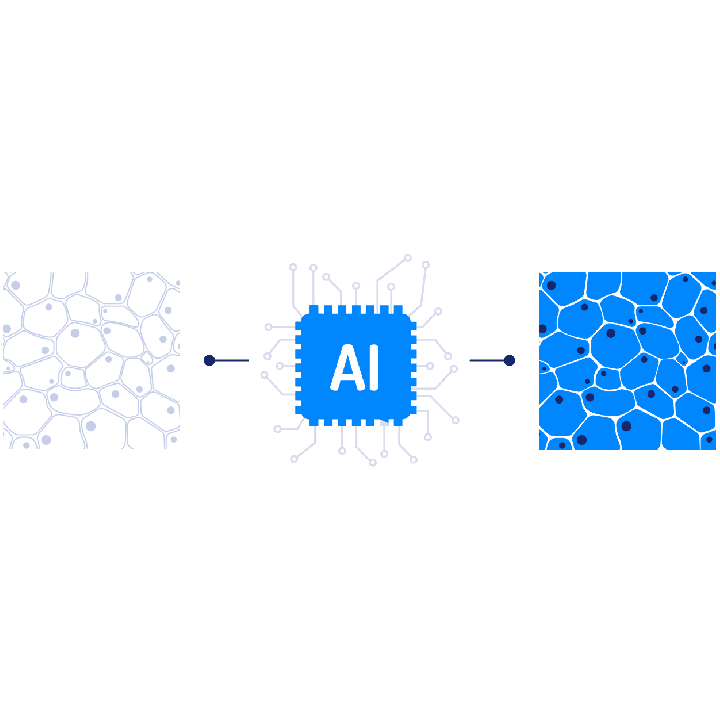
Wiederverwendet ein Krankheitsklassifikator für alle Färbereagenzien
Eine KI-Komponente, die histologische Bilder von einer Färbedomäne in eine andere überträgt, sodass bestehende Software und Machine-Learning-Modelle für alle Reagenzien wiederverwendet werden können.
Eine Demo bauen können viele Anbieter. Schwierig wird es, wenn KI mit echten Daten in echten Geschäftsprozessen zuverlässig laufen soll, und dafür braucht es ein anderes Team.
AI Superior wurde 2019 von KI-Forschern mit Publikationen und Patenten gegründet. Nach diesem wissenschaftlichen Maßstab arbeitet das gesamte Team.
Jedes Projekt läuft in Phasen, mit einer Go/No-Go-Entscheidung an jedem Meilenstein. Das senkt das Risiko: Budget fließt nur in Ansätze, die auf Ihren Daten bereits funktioniert haben.
Strategie, Modelle und Software entwirft ein und dasselbe Team. Es gibt keine Übergaben zwischen Dienstleistern, bei denen etwas verloren geht.
Wenn Daten Ihr Unternehmen nicht verlassen dürfen, setzen wir auf private, selbst gehostete Modelle statt auf KI-Dienste von Drittanbietern.
Ihr Projekt wird von erfahrenen Data Scientists und Engineers mit Forschungshintergrund geleitet, unterstützt von unseren Produkt- und Entwicklungsteams.
 Dr. Ivan Tankoyeu CEO
Promotion in Informatik. Ausgezeichnet von der IEEE GRSS Society, Gewinner des Global AI Hackathon 2017, TOP500 Data Scientist auf Kaggle (2014).
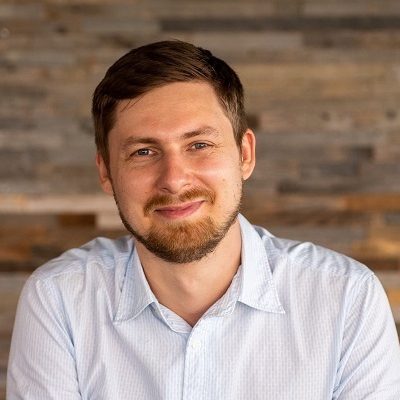 Dr. Sergey Sukhanov Advisor
Promotion in Machine Learning, Data Scientist seit 2013. Publikationen, Patente und über 30 umgesetzte KI-Use-Cases; mehrere IEEE-Auszeichnungen.
“AI Superior hat großes Engagement gezeigt, uns hochwertige Lösungen zu liefern.”
Verbessert und betreut die Dateninfrastruktur eines Anbieters von Kreditlösungen: Datenpipelines, ML-Modelle und individuelle Reports.
“AI Superior ist sehr sorgfältig auf alle unsere Anforderungen eingegangen und hat sie im Projekt berücksichtigt.”
Entwicklung von KI-Modellen und einem Dashboard für ein Pilotprogramm, das Abfall in Drohnenaufnahmen erkennt.
“Sie haben ein zusätzliches Modul geliefert, mit dem wir nicht gerechnet hatten, das sich aber als sehr nützlich erwiesen hat.”
Forschung und individuelle Softwareentwicklung mit Generative Adversarial Networks (GANs) für ein Pharmaunternehmen mit über 5.000 Mitarbeitenden.
Jede Phase endet mit einem Ergebnis, das Sie prüfen können, und über die nächste entscheiden Sie erst, wenn die vorherige nachweislich funktioniert. Umfang und Budget bleiben in Ihrer Hand.
Gemeinsam mit Ihrem Team analysieren wir die geschäftliche Fragestellung und legen die Richtung der Lösung fest.
Sie erhalten: Umfang, Vorgehen und eine erste Schätzung von Aufwand und erwarteten Ergebnissen
Wir lernen Ihr Team und Ihre Daten kennen und prüfen, ob KI das richtige Werkzeug für dieses Problem ist.
Sie erhalten: Eine Datenbewertung und eine klare Aussage zur Machbarkeit, bevor die Entwicklung beginnt
Wir starten klein, mit den bereits vorhandenen Daten, und testen die Lösung in der Praxis.
Sie erhalten: Gemessene Ergebnisse auf Ihren eigenen Daten und eine Grundlage für die Investitionsentscheidung
Wir integrieren die Lösung in Ihre bestehenden Systeme, optimieren die Modelle und passen sie bei Bedarf an.
Sie erhalten: Eine Lösung, die in Ihren Prozessen läuft und mit Ihren Daten und Systemen kompatibel ist
Wir gehen die Ergebnisse mit Ihnen durch und sorgen dafür, dass sie richtig gelesen werden.
Sie erhalten: Was die Lösung gebracht hat und wo sich die nächste Verbesserung lohnt
Wir richten Datensätze, Workflows und Training auf die Anforderungen jeder Branche aus.
Modelle, trainiert auf Finanzdaten und Finanzdokumenten.
Modelle für klinische und patientennahe Aufgaben.
Modelle, die verbessern, wie Kunden Produkte finden und kaufen.
Modelle, trainiert auf Verträgen, Fallmaterial und Vorschriften.
Modelle, die Inhalte in Ihrer Tonalität schreiben und optimieren.
Anerkannt von internationalen Wirtschaftspreisen und unabhängigen B2B-Plattformen, die Unternehmen auf Basis verifizierter Kundenbewertungen einstufen.
 Top-Unternehmen für künstliche Intelligenz Deutschland 2026 · Clutch
 Top-Unternehmen für Machine Learning Deutschland 2026 · Clutch
 Top-Unternehmen für Computer Vision Deutschland 2026 · Clutch
 Top-Unternehmen für generative KI Deutschland 2026 · Clutch
 Gewinner der Go Global Awards 2021 · International Trade Council
 Bester Data-Science- und KI-Dienstleister, Europa 2021 · German Business Awards
 Top-Unternehmen für künstliche Intelligenz 2023 · Clutch
 Top-Unternehmen für Machine Learning 2023 · Clutch
 Clutch Champion Herbst 2023 · Clutch
 Clutch Global Herbst 2023 · Clutch
 Top-Unternehmen für BI & Big Data Deutschland 2023 · Clutch
 Top-Unternehmen für IT-Services Deutschland 2023 · Clutch
 Top-KI-Unternehmen 2023 · TrueFirms
 Top-Unternehmen für Machine Learning 2021 · Techreviewer
 Meistbewertete IT-Dienstleister Deutschland · The Manifest
Training umfasst den gesamten Prozess der Modellentwicklung auf großen Datensätzen mit erheblichen Rechenressourcen. Fine-Tuning passt ein bestehendes vortrainiertes Modell mit Ihren fachspezifischen Daten an. Wir beraten Sie, welcher Weg zu Ihren Zielen passt, und kombinieren oft beides.
Ein Modell, das auf Ihren eigenen Daten trainiert wurde, ist für Ihre Aufgaben genauer und effizienter, ob KI-Assistent für Ihre Kunden, branchenspezifische Dokumentenanalyse oder mehrsprachiges System.
Ja. Wir richten Trainingsdatensätze, Workflows und Fine-Tuning auf die Anforderungen Ihrer Branche und Ihre Geschäftsziele aus.
Wir schützen sensible Informationen während des gesamten Trainings mit Verschlüsselung, Zugriffskontrollen und Compliance-Maßnahmen.
Wir validieren es vor dem Deployment mit Standardmetriken, realen Testfällen und Benchmarks und überwachen seine Leistung im Produktivbetrieb weiter.
Das hängt von der Komplexität der Daten, der Modellgröße und dem Rechenbedarf ab. Wir erstellen einen Trainingsplan und eine Schätzung auf Basis Ihrer Anforderungen.
Kontaktieren Sie uns, um Ihren Trainingsbedarf zu besprechen. Wir schlagen eine maßgeschneiderte Strategie für Entwicklung, Fine-Tuning und Deployment Ihres Modells vor.
Teilen Sie uns ein paar Details mit, unser KI-Team übernimmt den Rest. So geht es weiter: