
Des modèles plus précis
Des jeux de données annotés avec précision aident les modèles à reconnaître des schémas de manière fiable, par exemple en reconnaissance d’images, en analyse du sentiment ou en transcription de la parole.
Annotation de données · Données d’entraînement pour l’IA
Un modèle n’est jamais plus précis que les données dont il apprend. Nous annotons images, vidéos, textes, fichiers audio et nuages de points 3D selon les spécifications de votre modèle, en combinant des outils assistés par l’IA, une revue humaine et un contrôle qualité. Les jeux de données livrés s’intègrent directement à votre pipeline de machine learning.
Des étiquettes imprécises produisent des résultats inexacts. Nous considérons l’annotation comme une étape du développement du modèle, pas comme une corvée à part.
Des jeux de données annotés avec précision aident les modèles à reconnaître des schémas de manière fiable, par exemple en reconnaissance d’images, en analyse du sentiment ou en transcription de la parole.
Outils assistés par l’IA, expertise humaine et contrôle qualité garantissent des étiquettes précises et cohérentes, même sur de très grands jeux de données.
De la classification d’images à la reconnaissance d’entités nommées en passant par l’annotation image par image des vidéos, le schéma d’étiquetage suit les exigences de votre modèle.
L’annotation de tous les grands types de données, avec le contrôle qualité qui va avec.
Boîtes englobantes, polygones, points clés et segmentation sémantique au pixel près pour la détection d’objets et la reconnaissance d’images.
Une annotation image par image qui apprend aux modèles à suivre des objets, des actions et des comportements.
Reconnaissance d’entités nommées, analyse du sentiment, classification des intentions et catégorisation de textes pour la recherche, les chatbots et l’analyse.
Transcription phonétique et propre à chaque langue, identification des locuteurs, détection des émotions et classification des bruits pour la reconnaissance vocale.
Annotation structurée des données LiDAR et des capteurs 3D pour les systèmes autonomes, les drones et les modèles géospatiaux.
Des schémas d’étiquetage complexes pour les modèles qui exigent plusieurs catégories par élément.
Des contrôles à plusieurs niveaux : validation par l’IA, revue humaine et vérifications automatisées de cohérence.
Des processus et des consignes d’annotation conçus autour de votre modèle, de votre secteur et de votre pipeline de développement.
Des processus d’annotation conçus pour réduire les biais et favoriser un entraînement équitable des modèles.
Des plateformes d’annotation cloud et des outils d’automatisation pour les projets d’entraînement à fort volume.
Vous ne savez pas de quoi vous avez besoin ? Décrivez-nous le problème, nous vous recommanderons l’approche adaptée.
Parlons de votre projet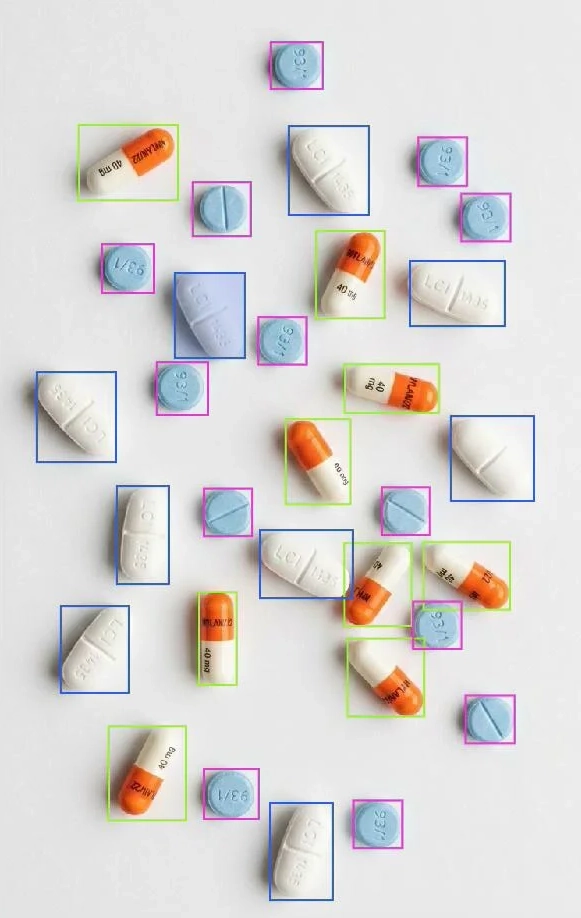
99,9 %de précision, de rappel et de score F1 sur l’ensemble des prédictions
Un système de vision par ordinateur qui identifie, classe et compte les comprimés par National Drug Code (NDC) à partir de photos, en remplacement d’un comptage manuel sujet aux erreurs.
Lire l’étude de cas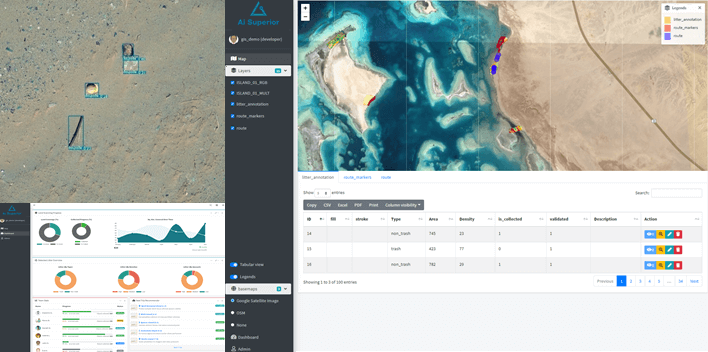
25x plus rapide pour détecter les déchets, avec des coûts globaux divisés par deux
Un système de vision par ordinateur qui détecte les déchets sur des images de drone couvrant environ mille kilomètres carrés de littoral, avec une application SIG pour planifier et suivre la collecte.
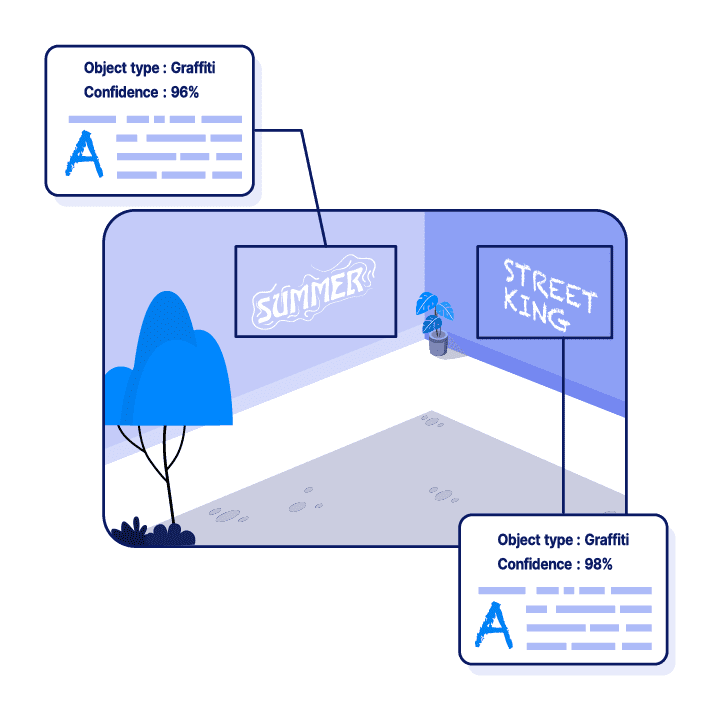
Temps réel détection des graffitis avec localisation GPS
Un système de deep learning qui détecte et localise les graffitis dans toute la ville en temps réel, pour que les équipes de nettoyage les repèrent, les priorisent et les effacent plus vite.
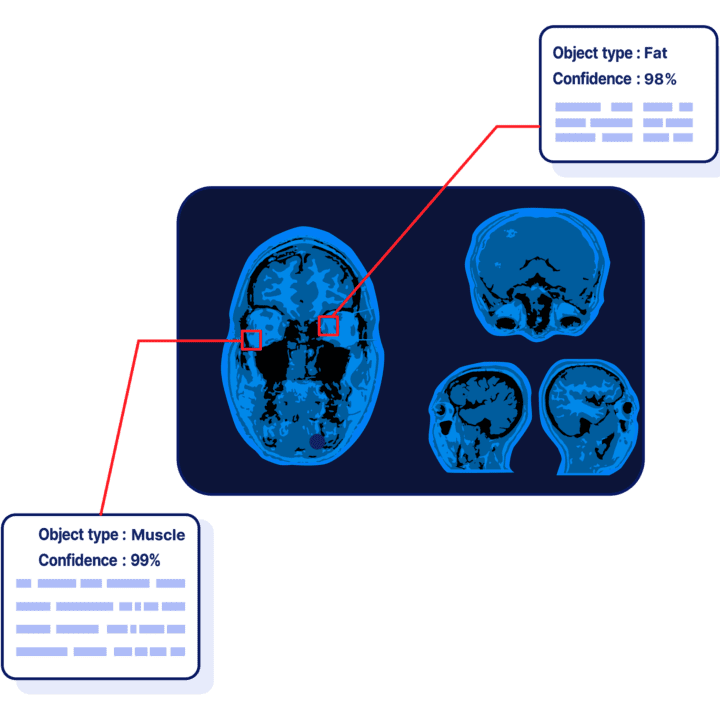
Automatisé segmentation de la graisse et du muscle sur chaque coupe IRM
Un modèle de deep learning pour un centre d’ophtalmologie, qui segmente les tissus graisseux et musculaires sur des IRM de l’orbite, estime leur volume et permet des comparaisons avant-après.
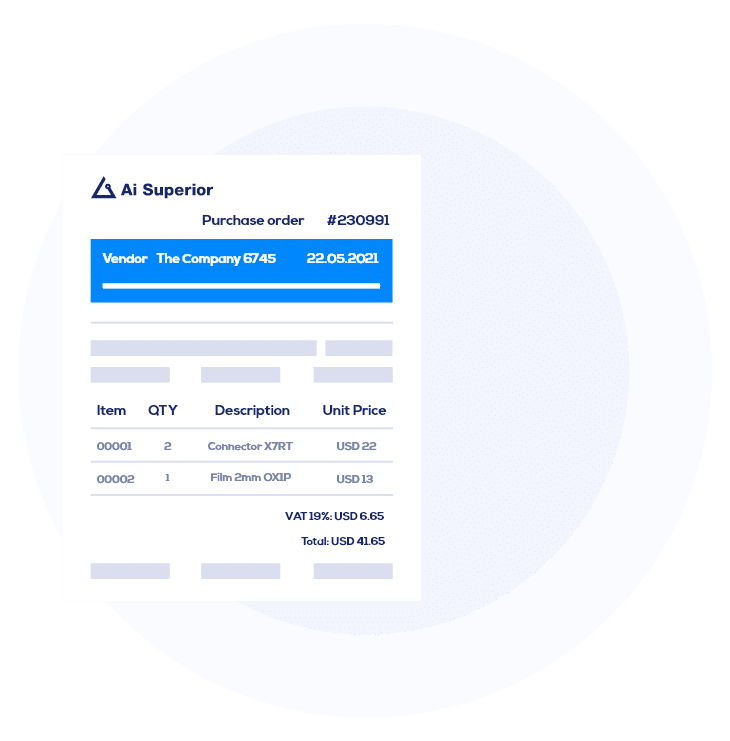
25x plus rapide pour traiter les factures
Un service web qui extrait les données de différents types de factures. Il automatise la saisie pour un distributeur d’équipements multinational et lui fait gagner 850 heures de travail par mois.
Beaucoup de prestataires savent construire une démo. Faire fonctionner l’IA de manière fiable sur des données réelles, au cœur de vrais processus métier, exige une tout autre équipe. C’est ce que vous trouvez chez nous.
AI Superior a été fondée en 2019 par des chercheurs en IA, auteurs de publications et de brevets. Cette expertise irrigue toute l’équipe.
Chaque projet est sécurisé par étapes, avec une décision go/no-go à chaque jalon : le budget ne va qu’aux solutions validées sur vos données.
Stratégie, modèles et logiciel sont conçus ensemble, sans passage de relais entre prestataires distincts.
Lorsque vos données ne doivent pas quitter votre organisation, nous nous appuyons sur des modèles privés auto-hébergés plutôt que sur des services d’IA tiers.
Votre projet est piloté par des data scientists et des ingénieurs seniors issus de la recherche, épaulés par nos équipes produit et développement.
 Dr. Sergey Sukhanov Chief Data Scientist
Doctorat en machine learning, data scientist depuis 2013. Publications, brevets et plus de 30 cas d’usage d’IA mis en œuvre ; plusieurs distinctions de l’IEEE.
 Dr. Ivan Tankoyeu Chief Data Officer
Doctorat en informatique. Distingué par l’IEEE GRSS Society, lauréat du Global AI Hackathon 2017, classé dans le TOP500 des data scientists sur Kaggle (2014).
 Sergio Frayle, M.Sc. Lead Data Scientist
Master en IA, reconnaissance de formes et imagerie numérique ; plus de 7 ans d’expérience en traitement d’images et en vision par ordinateur, avec publications.
 Enrique Fernández, M.Sc. Expert ML senior
Master en robotique et mécatronique ; conçoit et déploie des solutions d’IA complexes, notamment en vision par ordinateur et en NLP.
 Peter Luck, M.Sc. Consultant IA
Master en Business Engineering et informatique ; chef de produit et chef de projet pour des produits de machine learning.
“Ils ont mené à bien chaque volet du projet et ont dépassé nos attentes.”
Développement d’un modèle d’IA qui analyse les toitures de bâtiments résidentiels et commerciaux, collecte et annotation des données comprises. Tous les livrables clés ont été remis dans les délais.
“AI Superior a répondu avec beaucoup d’attention à tous nos besoins et les a pris en compte dans le projet.”
Développement de modèles d’IA et d’un tableau de bord pour un programme pilote de détection de déchets sur des images de drones.
“AI Superior a fait preuve d’un réel engagement pour nous livrer des solutions de grande qualité.”
Amélioration et maintenance de l’infrastructure de données d’une société de solutions de crédit : pipelines de données, modèles de ML et rapports sur mesure.
Chaque étape se conclut par un résultat vérifiable. Vous ne vous engagez jamais dans l’étape suivante avant d’avoir vu la précédente fonctionner : périmètre, budget et risques restent sous votre contrôle.
Nous analysons le problème métier avec vos équipes et définissons l’orientation de la solution.
Vous obtenez : Périmètre, approche et estimation globale de l’effort et des résultats attendus
Nous découvrons votre équipe et vos données, et vérifions si l’IA est le bon outil pour ce problème.
Vous obtenez : Une évaluation des données et un verdict clair sur la faisabilité, avant tout développement
Nous commençons petit, avec les données déjà disponibles, pour tester la solution en conditions réelles.
Vous obtenez : Des résultats mesurés sur vos propres données et une base solide pour la décision d’investissement
Nous intégrons la solution à vos systèmes existants, affinons les modèles et les ajustons si nécessaire.
Vous obtenez : Une solution opérationnelle au sein de vos processus, compatible avec vos données et vos systèmes
Ensemble, nous évaluons les résultats de la mise en œuvre et veillons à ce qu’ils soient correctement interprétés.
Vous obtenez : Une vision claire de la valeur créée et des prochains axes d’amélioration
Exemples de jeux de données annotés que nous préparons pour les modèles de chaque secteur.
Des données annotées pour la détection de fraude, l’automatisation des sinistres et l’évaluation des risques.
Une annotation précise pour la détection de fraude, l’analyse des investissements et le profilage des clients.
Des jeux de données médicales annotés pour la découverte de médicaments et le suivi des patients.
Des données annotées pour la sécurité des chantiers, la maintenance prédictive et la planification.
Des données annotées pour l’estimation, la recherche et le traitement des documents.
Des données géospatiales et de capteurs annotées pour l’exploration et l’exploitation.
Une annotation pour la modération de contenus, l’analyse du sentiment et les recommandations.
Des données annotées pour l’automatisation documentaire et les services aux citoyens.
Des données d’entraînement pour l’automatisation du support, l’analyse et la personnalisation.
Une annotation pour l’imagerie satellitaire et la détection d’anomalies.
Des données annotées pour l’évaluation d’impact et l’engagement des donateurs.
Distinguée par des prix internationaux et par des plateformes B2B indépendantes qui classent les entreprises selon des avis clients vérifiés.
 Lauréat des Go Global Awards 2021 · International Trade Council
 Meilleur prestataire de services en data science et IA, Europe 2021 · German Business Awards
 Top entreprise d’intelligence artificielle 2023 · Clutch
 Top entreprise de machine learning 2023 · Clutch
 Clutch Champion Automne 2023 · Clutch
 Clutch Global Automne 2023 · Clutch
 Top entreprise BI et big data Allemagne 2023 · Clutch
 Top entreprise de services informatiques Allemagne 2023 · Clutch
 Top entreprises d’intelligence artificielle 2023 · TrueFirms
 Top entreprises de machine learning 2021 · Techreviewer
 Entreprises de services informatiques les plus évaluées Allemagne · The Manifest
Les modèles apprennent à partir d’exemples annotés. Des étiquettes inexactes ou incohérentes produisent des résultats inexacts, ce qui réduit l’efficacité et augmente les risques une fois le modèle en service.
Images, vidéos, textes, fichiers audio et nuages de points 3D, y compris LiDAR. Les tâches courantes sont la détection d’objets, la segmentation, la reconnaissance d’entités, l’analyse du sentiment, la transcription et l’identification des locuteurs.
Des outils d’IA pré-étiquettent les données, puis des annotateurs humains affinent et valident les étiquettes. L’étiquetage est plus rapide tout en restant très précis.
Par un contrôle qualité à plusieurs niveaux : validation par l’IA, revue humaine et vérifications automatisées de cohérence. Nous annotons aussi d’abord un échantillon pour valider la qualité et affiner le processus avant de passer à l’échelle.
Oui. Nous définissons les objectifs et les consignes d’annotation à partir des exigences de votre modèle, afin que les données annotées correspondent à ses objectifs d’apprentissage et s’intègrent à votre pipeline de machine learning.
Oui. Nous utilisons des plateformes d’annotation cloud et des outils d’automatisation pour traiter de gros volumes de données avec une qualité constante.
Non. Nous pouvons vous aider à rassembler et organiser les données brutes, à en corriger les erreurs et incohérences, et à les prétraiter avant l’annotation et le développement du modèle.
Partagez quelques informations et notre équipe IA s’occupe du reste. Voici la suite :
Vous préférez choisir un créneau ?
Planifier un appel