
Hogere modelnauwkeurigheid
Nauwkeurig gelabelde datasets helpen modellen patronen betrouwbaar te herkennen bij taken als beeldherkenning, sentimentanalyse en spraak-naar-tekst.
Data-annotatie · Trainingsdata voor AI
Een model is zo nauwkeurig als de data waarvan het leert. Wij labelen beelden, video, tekst, audio en 3D-puntenwolken volgens de specificaties van uw model. We combineren AI-ondersteunde tools met menselijke controle en kwaliteitsborging en leveren datasets die direct in uw machine-learningpipeline passen.
Slechte labels leiden tot onnauwkeurige output. Wij behandelen annotatie als onderdeel van modelontwikkeling, niet als los klusje.
Nauwkeurig gelabelde datasets helpen modellen patronen betrouwbaar te herkennen bij taken als beeldherkenning, sentimentanalyse en spraak-naar-tekst.
AI-ondersteunde tools, menselijke expertise en kwaliteitscontrole houden labels precies en consistent, ook bij grote datasets.
Van beeldclassificatie tot named entity recognition en annotatie van videoframes: het labelschema volgt de eisen van uw model.
Annotatie voor elk belangrijk datatype, met de kwaliteitscontrole die daarbij hoort.
Bounding boxes, polygonen, keypoints en pixelnauwkeurige semantische segmentatie voor objectdetectie en beeldherkenning.
Annotatie per frame waarmee modellen leren objecten, handelingen en gedragspatronen te volgen.
Named entity recognition, sentimentanalyse, intentclassificatie en tekstcategorisering voor zoekfuncties, chatbots en analyses.
Fonetische en taalspecifieke transcriptie, sprekeridentificatie, emotiedetectie en ruisclassificatie voor spraakherkenning.
Gestructureerde annotatie van LiDAR- en 3D-sensordata voor autonome systemen, drones en geospatiale modellen.
Complexe labelschema's voor modellen die meerdere categorieën per item nodig hebben.
Controles in meerdere lagen: AI-gestuurde validatie, menselijke review en geautomatiseerde consistentiechecks.
Annotatieworkflows en -richtlijnen ontworpen rond uw model, uw sector en uw ontwikkelpipeline.
Annotatieprocessen die zijn ontworpen om bias te beperken en eerlijke modeltraining te ondersteunen.
Annotatieplatforms in de cloud en automatiseringstools voor trainingsprojecten met grote volumes.
Weet u niet zeker wat u nodig hebt? Beschrijf het probleem en wij adviseren u over de aanpak.
Bespreek uw project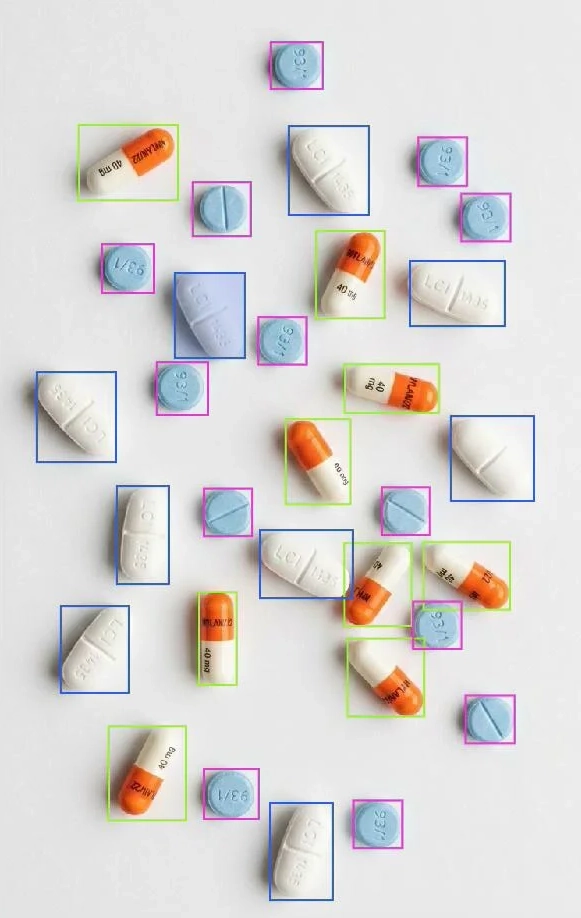
99,9%precisie, recall en F1 over alle voorspellingen
Een computervisionsysteem dat medicijnpillen op National Drug Code (NDC) herkent, classificeert en telt op foto’s, en zo foutgevoelig handmatig tellen vervangt.
Lees de case study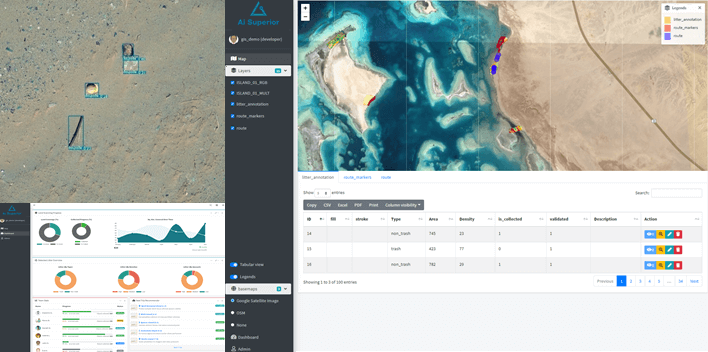
25x snellere afvaldetectie, met gehalveerde totale kosten
Een computervisionsysteem dat zwerfafval detecteert op dronebeelden van ongeveer duizend vierkante kilometer kustgebied, met een GIS-applicatie om de inzameling te plannen en te volgen.
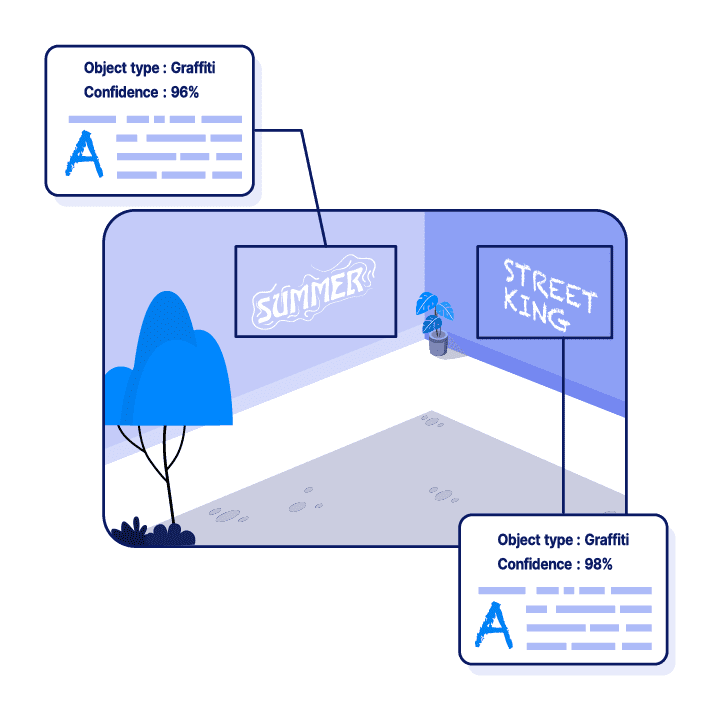
Realtime graffitidetectie met gps-locatie
Een deep-learningsysteem dat graffiti in de hele stad in realtime detecteert en lokaliseert, zodat schoonmaakteams het sneller kunnen vinden, prioriteren en verwijderen.
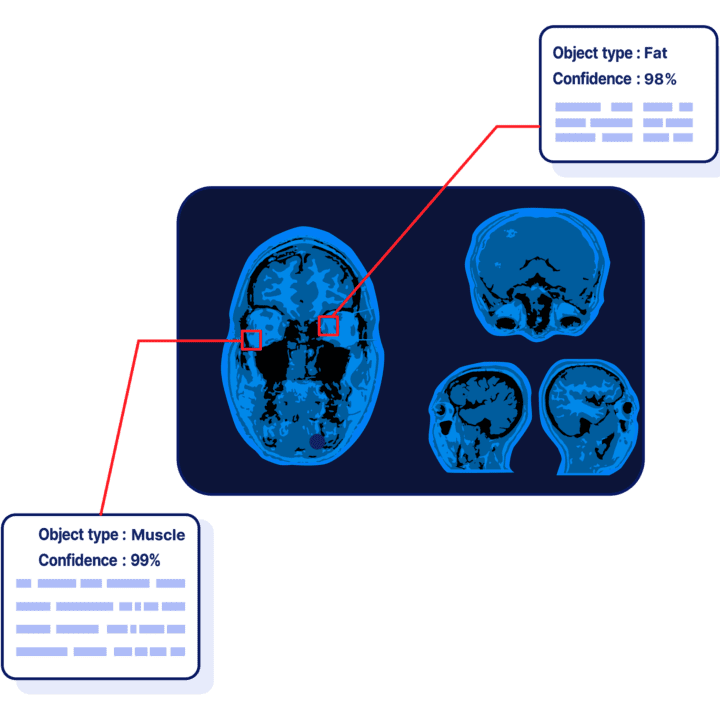
Geautomatiseerd segmentatie van vet en spieren in elke MRI-doorsnede
Een deep-learningmodel voor een oogheelkundig centrum dat vet- en spierweefsel segmenteert in MRI-scans van de oogkas, het volume schat en vergelijkingen voor en na een ingreep ondersteunt.
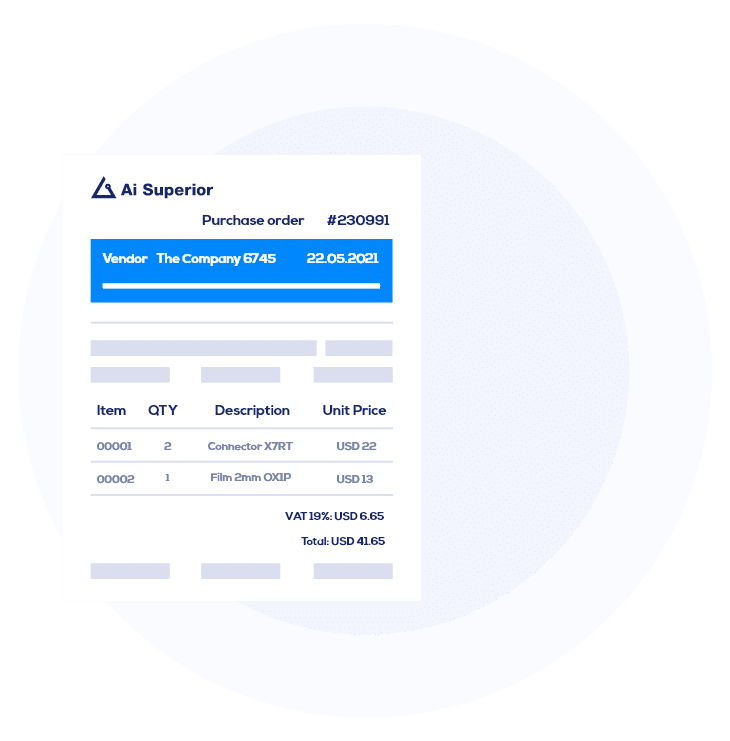
25x snellere factuurverwerking
Een webdienst die gegevens uit verschillende soorten facturen haalt, de gegevensinvoer automatiseert voor een multinationale distributeur van apparatuur en 850 manuren per maand bespaart.
Veel leveranciers kunnen een demo bouwen. AI betrouwbaar laten werken op echte data, binnen echte bedrijfsprocessen, vraagt om een ander soort team. Dat team krijgt u bij ons.
AI Superior werd in 2019 opgericht door AI-onderzoekers met gepubliceerde papers en patenten. Die diepgang vindt u in het hele team terug.
Bij elk project beperken we het risico stap voor stap, met een go/no-go-beslissing bij elke mijlpaal. Zo gaat uw budget alleen naar oplossingen die zich op uw data hebben bewezen.
Strategie, modellen en software worden samen ontworpen, niet doorgegeven tussen losse leveranciers.
Mag data uw organisatie niet verlaten, dan bouwen we op private, zelf gehoste modellen in plaats van AI-diensten van derden.
Uw project wordt geleid door senior data scientists en engineers met een onderzoeksachtergrond, ondersteund door onze product- en ontwikkelteams.
 Dr. Sergey Sukhanov Chief Data Scientist
Gepromoveerd in machine learning, data scientist sinds 2013. Publicaties, patenten en meer dan 30 geïmplementeerde AI-use cases; meerdere IEEE-prijzen.
 Dr. Ivan Tankoyeu Chief Data Officer
Gepromoveerd in de informatica. Erkend door de IEEE GRSS Society, winnaar van de Global AI Hackathon 2017, Kaggle TOP500 data scientist (2014).
 Sergio Frayle, M.Sc. Lead Data Scientist
Master in AI, patroonherkenning en digitale beeldverwerking; meer dan 7 jaar ervaring in beeldverwerking en computer vision, met publicaties.
 Enrique Fernández, M.Sc. Senior ML Expert
Master in robotica en mechatronica; bouwt en implementeert complexe AI-oplossingen, vooral in computer vision en NLP.
 Peter Luck, M.Sc. AI Consultant
Master in bedrijfskunde en informatica; product- en projectmanager voor machine learning-producten.
“Ze hebben elk onderdeel van het project met succes uitgevoerd en onze verwachtingen overtroffen.”
Bouwde een AI-model dat daken van woningen en bedrijfspanden analyseert, inclusief dataverzameling en labeling. Alle belangrijke deliverables werden op tijd opgeleverd.
“AI Superior is zeer zorgvuldig op al onze behoeften ingegaan en heeft ze in het project meegenomen.”
Bouwde AI-modellen en een dashboard voor een pilotprogramma dat afval detecteert in dronebeelden.
“AI Superior toonde een sterke inzet om ons oplossingen van hoge kwaliteit te leveren.”
Verbetert en onderhoudt de data-infrastructuur van een aanbieder van kredietoplossingen: datapipelines, ML-modellen en rapportages op maat.
Elke fase eindigt met een resultaat dat u kunt controleren. U stapt pas in de volgende fase als u de vorige hebt zien werken. Zo houdt u scope, budget en risico zelf in de hand.
Samen met uw team werken we het bedrijfsprobleem uit en bepalen we de richting van de oplossing.
U ontvangt: Scope, aanpak en een globale inschatting van inspanning en verwachte resultaten
We leren uw team en uw data kennen en toetsen of AI het juiste middel is voor dit probleem.
U ontvangt: Een data-assessment en een helder haalbaarheidsoordeel, nog voordat de bouw begint
We beginnen klein, met de data die al beschikbaar is, om de oplossing in de praktijk te testen.
U ontvangt: Gemeten resultaten op uw eigen data en een basis voor de investeringsbeslissing
We integreren de oplossing in uw bestaande systemen, finetunen de modellen en passen ze aan waar nodig.
U ontvangt: Een oplossing die draait binnen uw processen, afgestemd op uw data en systemen
Samen evalueren we de resultaten van de implementatie en zorgen we dat ze juist worden geïnterpreteerd.
U ontvangt: Een helder beeld van de geleverde waarde en van wat u hierna kunt verbeteren
Voorbeelden van de gelabelde datasets die wij per sector voor modellen voorbereiden.
Gelabelde data voor fraudedetectie, automatisering van schadeafhandeling en risicobeoordeling.
Nauwkeurige annotatie voor fraudedetectie, beleggingsanalyse en klantprofilering.
Gelabelde medische datasets voor geneesmiddelenonderzoek en patiëntmonitoring.
Gelabelde data voor veiligheid op de bouwplaats, voorspellend onderhoud en planning.
Geannoteerde data voor waardering, zoekfuncties en documentverwerking.
Geannoteerde geospatiale en sensordata voor exploratie en operations.
Annotatie voor contentmoderatie, sentiment en aanbevelingen.
Gelabelde data voor documentautomatisering en dienstverlening aan burgers.
Trainingsdata voor supportautomatisering, analyses en personalisatie.
Annotatie voor satellietbeelden en anomaliedetectie.
Geannoteerde data voor impactmeting en donateurbetrokkenheid.
Erkend door internationale bedrijfsprijzen en door onafhankelijke B2B-platforms die bedrijven rangschikken op basis van geverifieerde klantreviews.
 Go Global Awards Winner 2021 · International Trade Council
 Beste dienstverlener in data science & AI, Europa 2021 · German Business Awards
 Top AI-bedrijf 2023 · Clutch
 Top machine learning-bedrijf 2023 · Clutch
 Clutch Champion Najaar 2023 · Clutch
 Clutch Global Najaar 2023 · Clutch
 Top BI- & big data-bedrijf Duitsland 2023 · Clutch
 Top IT-dienstverlener Duitsland 2023 · Clutch
 Top AI-bedrijven 2023 · TrueFirms
 Top machine learning-bedrijven 2021 · Techreviewer
 Meest beoordeelde IT-dienstverleners Duitsland · The Manifest
Modellen leren patronen uit gelabelde voorbeelden. Onnauwkeurige of inconsistente labels leiden tot onnauwkeurige output. Dat verlaagt de efficiëntie en verhoogt het risico zodra het model in gebruik is.
Beelden, video, tekst, audio en 3D-puntenwolken, waaronder LiDAR. Typische taken zijn objectdetectie, segmentatie, entiteitsherkenning, sentimentanalyse, transcriptie en sprekeridentificatie.
AI-tools labelen de data voor, waarna menselijke annotatoren de labels verfijnen en valideren. Zo gaat het labelen sneller terwijl de nauwkeurigheid hoog blijft.
Met kwaliteitscontrole in meerdere lagen: AI-gestuurde validatie, menselijke review en geautomatiseerde consistentiechecks. We annoteren ook eerst een steekproef om de kwaliteit te valideren en de workflow te verfijnen voordat we opschalen.
Ja. Wij bepalen annotatiedoelen en -richtlijnen op basis van de eisen van uw model, zodat de gelabelde data aansluit op de leerdoelen en integreert met uw machine-learningpipeline.
Ja. Wij gebruiken annotatieplatforms in de cloud en automatiseringstools om grote hoeveelheden data met constante kwaliteit te verwerken.
Nee. Wij kunnen helpen ruwe data te verzamelen en te ordenen, fouten en inconsistenties eruit te halen en de data voor te bewerken voordat annotatie en modelontwikkeling beginnen.
Deel een paar details en ons AI-team neemt het over. Dit zijn de volgende stappen:
Liever zelf een tijd kiezen?
Plan een gesprek