
Höhere Modellgenauigkeit
Präzise annotierte Datensätze helfen Modellen, Muster zuverlässig zu erkennen, etwa bei Bilderkennung, Sentimentanalyse und Speech-to-Text.
Datenannotation · Trainingsdaten für KI
Ein Modell ist nur so präzise wie die Daten, aus denen es lernt. Wir annotieren Bilder, Videos, Texte, Audio und 3D-Punktwolken exakt nach den Vorgaben Ihres Modells. Dabei kombinieren wir KI-gestützte Tools mit menschlicher Prüfung und Qualitätskontrolle und liefern Datensätze, die sich direkt in Ihre Machine-Learning-Pipeline einfügen.
Schlechte Labels führen zu ungenauen Ergebnissen. Für uns ist Annotation Teil der Modellentwicklung, keine lästige Nebenaufgabe.
Präzise annotierte Datensätze helfen Modellen, Muster zuverlässig zu erkennen, etwa bei Bilderkennung, Sentimentanalyse und Speech-to-Text.
KI-gestützte Tools, menschliche Expertise und Qualitätskontrolle halten Labels präzise und konsistent, auch bei großen Datensätzen.
Von der Bildklassifizierung über Named Entity Recognition bis zur Annotation von Videoframes: Das Labeling-Schema folgt den Anforderungen Ihres Modells.
Annotation für alle wichtigen Datentypen, abgesichert durch Qualitätskontrolle.
Bounding Boxes, Polygone, Keypoints und pixelgenaue semantische Segmentierung für Objekterkennung und Bilderkennung.
Annotation auf Frame-Ebene, mit der Modelle lernen, Objekte, Handlungen und Verhaltensmuster zu verfolgen.
Named Entity Recognition, Sentimentanalyse, Intent-Klassifizierung und Textkategorisierung für Suche, Chatbots und Analysen.
Phonetische und sprachspezifische Transkription, Sprechererkennung, Emotionserkennung und Geräuschklassifizierung für die Spracherkennung.
Strukturierte Annotation von LiDAR- und 3D-Sensordaten für autonome Systeme, Drohnen und Geodatenmodelle.
Komplexe Labeling-Schemata für Modelle, die mehrere Kategorien pro Datenpunkt benötigen.
Mehrstufige Prüfungen: KI-gestützte Validierung, menschliche Prüfung und automatisierte Konsistenzchecks.
Annotations-Workflows und Richtlinien, ausgerichtet auf Ihr Modell, Ihre Branche und Ihre Entwicklungspipeline.
Annotationsprozesse, die Verzerrungen reduzieren und ein faires Modelltraining unterstützen.
Cloud-basierte Annotationsplattformen und Automatisierungstools für Trainingsprojekte mit hohem Datenvolumen.
Nicht sicher, was davon Sie brauchen? Beschreiben Sie das Problem, und wir empfehlen Ihnen den passenden Ansatz.
Projekt besprechen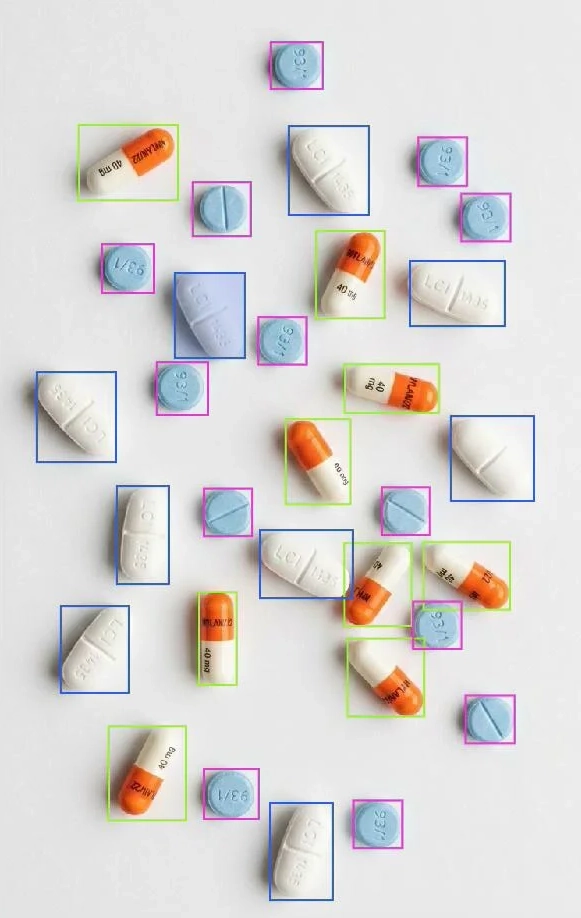
99,9 %Precision, Recall und F1 über alle Vorhersagen
Ein Computer-Vision-System, das pharmazeutische Tabletten anhand des National Drug Code (NDC) auf Fotos identifiziert, klassifiziert und zählt – und damit das fehleranfällige manuelle Zählen ersetzt.
Fallstudie lesen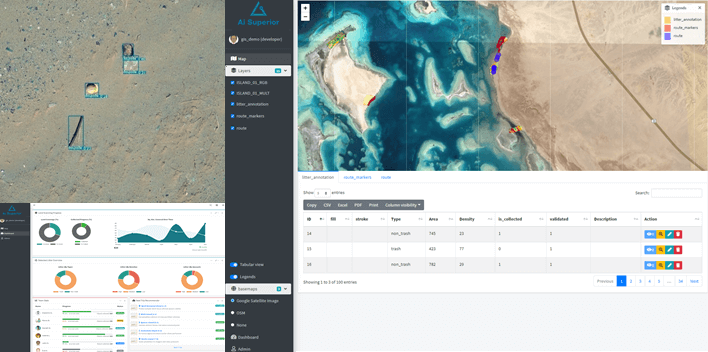
25x schnellere Müllerkennung bei halbierten Gesamtkosten
Ein Computer-Vision-System, das Müll auf Drohnenbildern entlang von rund tausend Quadratkilometern Küste erkennt – mit einer GIS-Anwendung zur Planung und Nachverfolgung der Sammlung.
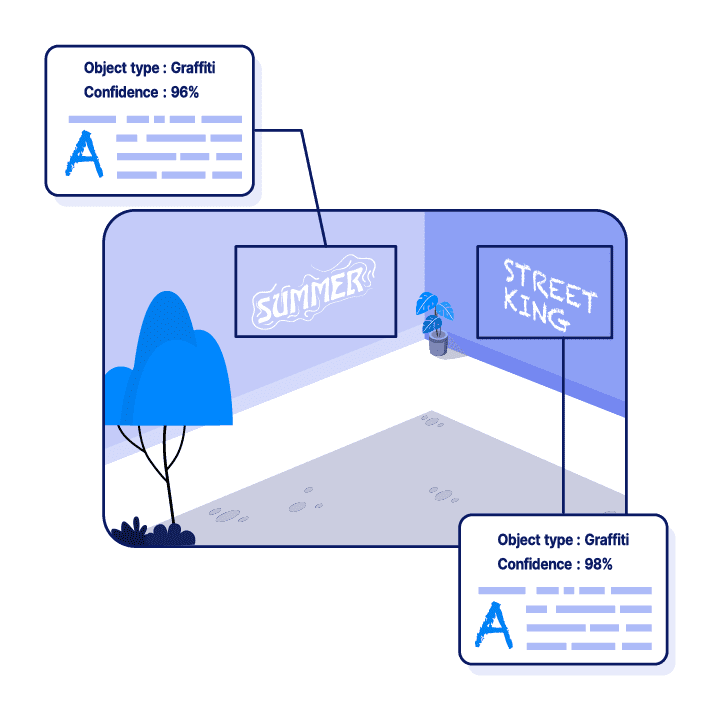
Echtzeit Graffiti-Erkennung mit GPS-Standort
Ein Deep-Learning-System, das Graffiti im gesamten Stadtgebiet in Echtzeit erkennt und verortet, damit Reinigungsteams sie schneller finden, priorisieren und entfernen können.
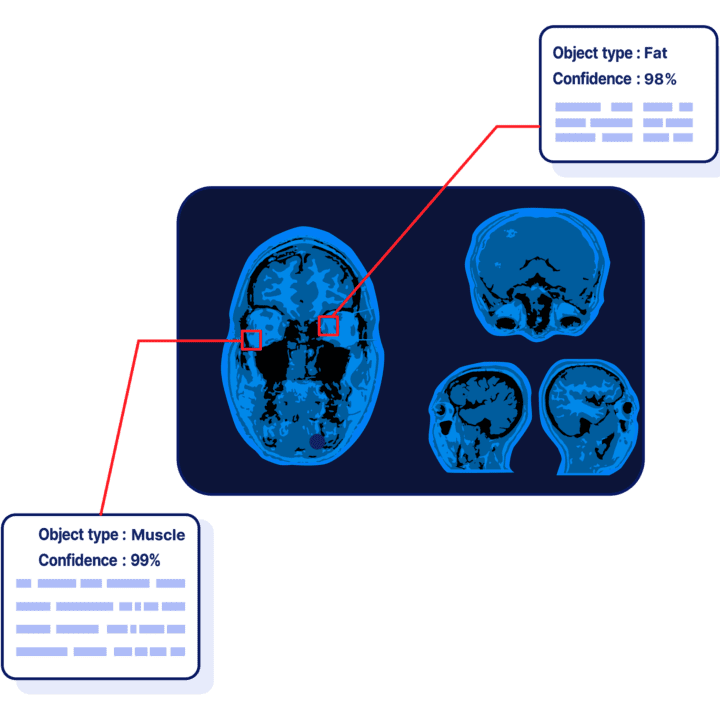
Automatisiert Segmentierung von Fett und Muskel in jeder MRT-Schicht
Ein Deep-Learning-Modell für eine Augenklinik, das Fett- und Muskelgewebe in MRT-Scans der Orbita segmentiert, deren Volumen schätzt und Vorher-nachher-Vergleiche ermöglicht.
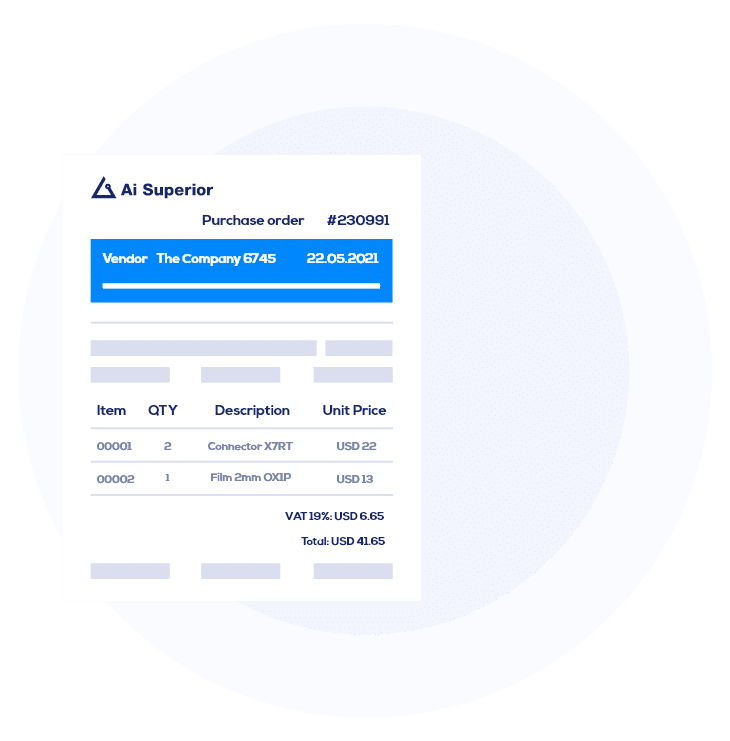
25x schnellere Rechnungsverarbeitung
Ein Webservice, der Daten aus verschiedenen Rechnungstypen extrahiert, die Dateneingabe für einen multinationalen Anlagenhändler automatisiert und 850 Arbeitsstunden pro Monat spart.
Eine Demo bauen können viele Anbieter. Damit KI mit echten Daten in echten Geschäftsprozessen zuverlässig funktioniert, braucht es ein anderes Team. Genau das bekommen Sie bei uns.
AI Superior wurde 2019 von KI-Forschern mit Publikationen und Patenten gegründet. Diese Tiefe prägt das gesamte Team.
Wir reduzieren das Risiko jedes Projekts schrittweise, mit einer Go/No-Go-Entscheidung an jedem Meilenstein. So fließt Budget nur in Lösungen, die sich auf Ihren Daten bewährt haben.
Strategie, Modelle und Software entstehen gemeinsam, statt zwischen verschiedenen Dienstleistern weitergereicht zu werden.
Wenn Daten Ihr Unternehmen nicht verlassen dürfen, setzen wir auf private, selbst gehostete Modelle statt auf KI-Dienste von Drittanbietern.
Ihr Projekt wird von erfahrenen Data Scientists und Engineers mit Forschungshintergrund geleitet, unterstützt von unseren Produkt- und Entwicklungsteams.
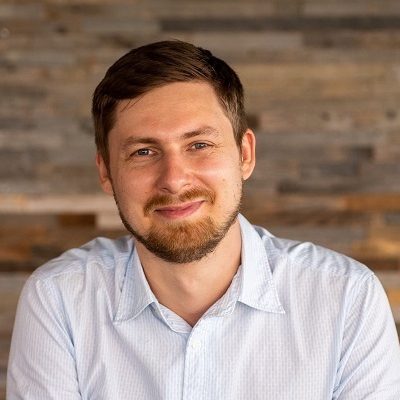 Dr. Sergey Sukhanov Chief Data Scientist
Promotion in Machine Learning, Data Scientist seit 2013. Publikationen, Patente und über 30 umgesetzte KI-Use-Cases; mehrere IEEE-Auszeichnungen.
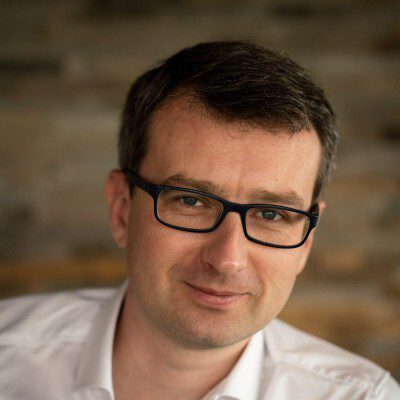 Dr. Ivan Tankoyeu Chief Data Officer
Promotion in Informatik. Ausgezeichnet von der IEEE GRSS Society, Gewinner des Global AI Hackathon 2017, TOP500 Data Scientist auf Kaggle (2014).
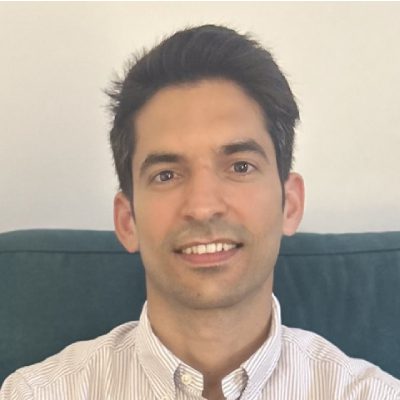 Sergio Frayle, M.Sc. Lead Data Scientist
Master in KI, Mustererkennung und digitaler Bildverarbeitung; über 7 Jahre Erfahrung in Bildverarbeitung und Computer Vision, mit Publikationen.
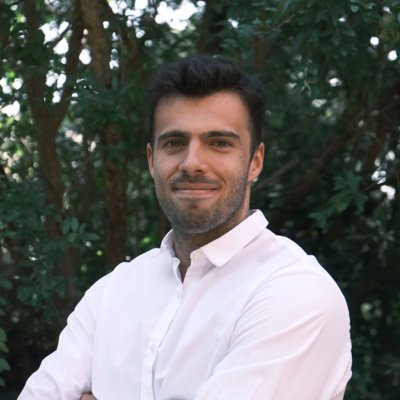 Enrique Fernández, M.Sc. Senior ML Expert
Master in Robotik und Mechatronik; entwickelt und implementiert komplexe KI-Lösungen, insbesondere in Computer Vision und NLP.
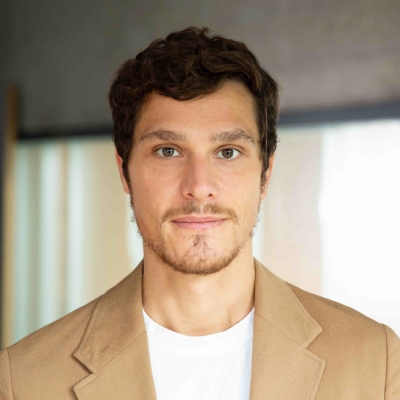 Peter Luck, M.Sc. KI-Berater
Master in Wirtschaftsingenieurwesen und Informatik; Produkt- und Projektmanager für Machine-Learning-Produkte.
“Sie haben jeden Bestandteil des Projekts erfolgreich umgesetzt und unsere Erwartungen übertroffen.”
Entwicklung eines KI-Modells, das die Dächer von Wohn- und Gewerbeimmobilien analysiert, einschließlich Datenerhebung und Labeling. Alle zentralen Ergebnisse wurden termingerecht geliefert.
“AI Superior ist sehr sorgfältig auf alle unsere Anforderungen eingegangen und hat sie im Projekt berücksichtigt.”
Entwicklung von KI-Modellen und einem Dashboard für ein Pilotprogramm, das Abfall in Drohnenaufnahmen erkennt.
“AI Superior hat großes Engagement gezeigt, uns hochwertige Lösungen zu liefern.”
Verbessert und betreut die Dateninfrastruktur eines Anbieters von Kreditlösungen: Datenpipelines, ML-Modelle und individuelle Reports.
Jede Phase endet mit einem Ergebnis, das Sie prüfen können. Sie entscheiden sich erst für die nächste Phase, wenn die vorherige funktioniert. So behalten Sie Umfang, Budget und Risiko unter Kontrolle.
Gemeinsam mit Ihrem Team analysieren wir die geschäftliche Fragestellung und legen die Richtung der Lösung fest.
Sie erhalten: Umfang, Vorgehen und eine erste Schätzung von Aufwand und erwarteten Ergebnissen
Wir lernen Ihr Team und Ihre Daten kennen und prüfen, ob KI das richtige Werkzeug für dieses Problem ist.
Sie erhalten: Eine Datenbewertung und eine klare Aussage zur Machbarkeit, bevor die Entwicklung beginnt
Wir starten klein, mit den bereits vorhandenen Daten, und testen die Lösung in der Praxis.
Sie erhalten: Messbare Ergebnisse auf Ihren eigenen Daten und eine Grundlage für die Investitionsentscheidung
Wir integrieren die Lösung in Ihre bestehenden Systeme, optimieren die Modelle und passen sie bei Bedarf an.
Sie erhalten: Eine Lösung, die in Ihren Prozessen läuft und mit Ihren Daten und Systemen kompatibel ist
Gemeinsam bewerten wir die Ergebnisse der Implementierung und stellen sicher, dass sie richtig interpretiert werden.
Sie erhalten: Ein klares Bild des geschaffenen Mehrwerts und der nächsten Verbesserungspotenziale
Beispiele für annotierte Datensätze, die wir für Modelle in den einzelnen Branchen aufbereiten.
Annotierte Daten für Betrugserkennung, automatisierte Schadenbearbeitung und Risikobewertung.
Präzise Annotation für Betrugserkennung, Investmentanalyse und Kundenprofile.
Annotierte medizinische Datensätze für Wirkstoffforschung und Patientenmonitoring.
Annotierte Daten für Baustellensicherheit, vorausschauende Wartung und Planung.
Annotierte Daten für Bewertung, Suche und Dokumentenverarbeitung.
Annotierte Geo- und Sensordaten für Exploration und Betrieb.
Annotation für Content-Moderation, Sentiment und Empfehlungen.
Annotierte Daten für Dokumentenautomatisierung und Bürgerservices.
Trainingsdaten für Support-Automatisierung, Analysen und Personalisierung.
Annotation für Satellitenbilder und Anomalieerkennung.
Annotierte Daten für Wirkungsmessung und Spenderbindung.
Anerkannt von internationalen Wirtschaftspreisen und unabhängigen B2B-Plattformen, die Unternehmen auf Basis verifizierter Kundenbewertungen einstufen.
 Gewinner der Go Global Awards 2021 · International Trade Council
 Bester Data-Science- und KI-Dienstleister, Europa 2021 · German Business Awards
 Top-Unternehmen für künstliche Intelligenz 2023 · Clutch
 Top-Unternehmen für Machine Learning 2023 · Clutch
 Clutch Champion Herbst 2023 · Clutch
 Clutch Global Herbst 2023 · Clutch
 Top-Unternehmen für BI & Big Data Deutschland 2023 · Clutch
 Top-Unternehmen für IT-Services Deutschland 2023 · Clutch
 Top-KI-Unternehmen 2023 · TrueFirms
 Top-Unternehmen für Machine Learning 2021 · Techreviewer
 Meistbewertete IT-Dienstleister Deutschland · The Manifest
Modelle lernen Muster aus annotierten Beispielen. Ungenaue oder inkonsistente Labels führen zu ungenauen Ergebnissen. Das mindert die Effizienz und erhöht das Risiko, sobald das Modell im Einsatz ist.
Bilder, Videos, Texte, Audio und 3D-Punktwolken einschließlich LiDAR. Typische Aufgaben sind Objekterkennung, Segmentierung, Entity Recognition, Sentimentanalyse, Transkription und Sprechererkennung.
KI-gestützte Tools labeln die Daten vor, menschliche Annotatoren verfeinern und validieren die Labels. Das beschleunigt das Labeling und hält die Genauigkeit hoch.
Durch mehrstufige Qualitätskontrolle: KI-gestützte Validierung, menschliche Prüfung und automatisierte Konsistenzchecks. Außerdem annotieren wir zuerst einen Beispieldatensatz, um die Qualität zu validieren und den Workflow zu verfeinern, bevor wir hochskalieren.
Ja. Wir leiten Annotationsziele und Richtlinien aus den Anforderungen Ihres Modells ab. So passen die annotierten Daten zu seinen Lernzielen und fügen sich in Ihre Machine-Learning-Pipeline ein.
Ja. Wir nutzen Cloud-basierte Annotationsplattformen und Automatisierungstools, um große Datenmengen in gleichbleibender Qualität zu verarbeiten.
Nein. Wir helfen Ihnen, Rohdaten zu sammeln und zu strukturieren, sie von Fehlern und Inkonsistenzen zu bereinigen und sie vor Annotation und Modellentwicklung vorzuverarbeiten.
Teilen Sie uns ein paar Details mit, unser KI-Team übernimmt den Rest. So geht es weiter:
Lieber direkt einen Termin wählen?
Termin vereinbaren